
怎麼讓AI把你的品牌識別為一個實體
先説結論
GEO,即生成式引擎優化。品牌想在AI生成的答案中被提及、引用或推薦,首先要解決一個基礎問題:AI能不能確認你是誰。
GEO,即生成式引擎優化。品牌想在AI生成的答案中被提及、引用或推薦,首先要解決一個基礎問題:AI能不能確認你是誰。
品牌名稱出現在網上,不等於AI已經認識這個品牌。它還需要確認:這個名稱對應哪家公司、屬於什麼行業、何時成立、提供什麼產品或服務,以及如何與同名公司、產品或常見詞區分。只有這些資訊能夠相互對應,AI才可能把分散的內容歸入同一個實體。
這裏所説的“實體”,是指一個身份明確、能夠與其他對象區分、可以被反覆識別的公司、品牌、產品或個人。實體建模,就是幫助AI建立並持續確認這組身份資訊。
AI為什麼需要先確認實體
ChatGPT、Perplexity、豆包、DeepSeek、文心一言等產品,在處理需要檢索的問題時,通常會使用RAG,即檢索增強生成:先檢索候選內容,再對內容進行篩選和排序,最後組織成答案。
在這個過程中,系統需要判斷文章中的名稱究竟指向誰。如果品牌名稱存在歧義,不同平台上的名稱和介紹又互相矛盾,AI就難以確認這些內容是否屬於同一家公司,也會更謹慎地引用相關資訊。
原稿援引的seoClarity實證數據顯示,品牌網絡提及與品牌出現在AI概覽中的相關係數為r=0.664,而反鏈與其相關係數為r=0.218。這裏的r是相關係數,用來表示兩個變量在樣本中的關聯程度。這組數據説明,穩定、統一的品牌提及與AI引用之間存在較強關聯,但不能據此認定前者必然導致後者。
讓AI識別品牌,需要完成四件事
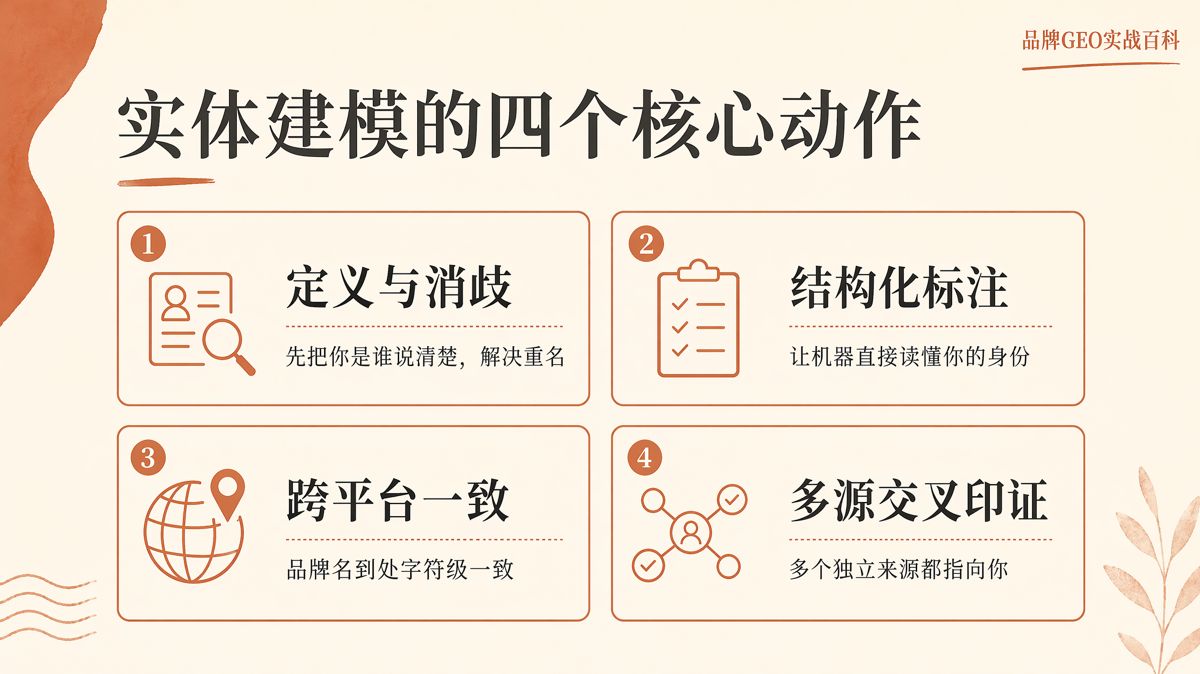
一、明確身份資訊,解決名稱歧義
先整理一份可以長期統一使用的品牌事實清單,包括:
- 品牌和公司的規範全稱;
- 成立年份;
- 總部所在地;
- 所屬行業和主要品類;
- 代表產品或服務;
- 創始人或主要負責人;
- 用於區分同名對象的地域、行業或業務資訊。
海外常見做法是在官網建立About或Company Facts頁面,也就是公司介紹頁或公司事實頁,把這些資訊集中寫清楚。
如果品牌名本身是常見詞,或者市場上存在同名公司,僅反覆發佈品牌名稱並不能完成識別。文章、賬號簡介和公司資料中需要同時出現行業、地域、公司主體、代表業務等資訊,讓AI能夠區分不同對象。
二、使用結構化數據,減少機器理解成本
結構化數據是按照固定字段組織的資訊。Schema.org是一套常用的網頁結構化數據規範,其中:
- Organization用於標註公司或組織資訊;
- Product用於標註產品資訊;
- FAQPage用於標註常見問答內容。
這些標註可以讓搜尋系統直接讀取公司名稱、業務類型、產品和問答之間的關係,不必完全依賴正文推斷。
原稿援引的數據稱,帶有結構化標註的內容,被AI引用的頻率是無標註內容的8.2倍。另據原稿標註的行業口徑,Organization與FAQPage同時使用時,AI概覽的引用率比完全不標註高約37%。AI概覽也稱AIO,是搜尋結果頁中由AI生成的答案摘要。這些數字反映的是特定樣本中的表現,不代表只要添加標註就一定獲得引用。
SEO,即搜尋引擎優化,主要解決網頁能否被搜尋引擎發現、收錄和排序的問題。原稿所引的2026年5月15日Google官方口徑認為,GEO仍建立在SEO能力之上,不需要所謂“AI專用Schema標籤”。Schema的實際作用,是幫助系統識別實體、區分同名對象,並更準確地理解頁面內容。
國內的情況有所不同。按照原稿中的行業口徑,國內AI產品更常引用權威媒體和大型內容平台,企業獨立站被直接引用的情況相對較少。因此,除了評估獨立站是否需要結構化標註,還應優先把公眾號、百家號、抖音號等官方賬號的名稱、認證主體和簡介填寫完整,並保持一致。
三、統一跨平台身份資訊
同一品牌在不同平台使用不同名稱,會直接增加實體識別難度。
例如,公司在一個平台使用品牌簡稱,在另一個平台使用公司全稱,在第三個平台又添加地域後綴。如果沒有明確説明這些名稱之間的關係,AI可能無法確認它們是否屬於同一主體。
品牌名稱應儘量做到字符級一致,包括:
- 使用品牌名還是公司主體名稱;
- 簡體字和繁體字;
- 標點和空格;
- 地域後綴;
- 產品名與公司名的關係。
海外網站常用sameAs字段,把官網、LinkedIn、YouTube、維基百科等官方頁面與同一組織關聯起來。sameAs的作用,是明確告訴機器這些頁面指向同一個實體。原稿援引的業內經驗建議,sameAs儘量關聯8個以上的權威平台;這屬於行業經驗,不是適用於所有網站的固定技術門檻。
原稿還提到一項行業口徑:從2026年3月起,Google更重視能夠驗證的作者和發佈方實體,其中包括跨平台身份連結。由於這是行業口徑,實際執行時仍應結合平台公開規則判斷,不能把它直接理解為確定的排序規則。
國內目前沒有完全對應sameAs的統一應用方式,但實體識別的要求相近:公眾號、百家號、抖音號、百科詞條等頁面,應使用同一個規範品牌名和一致的核心介紹。
四、通過多個獨立來源相互印證
品牌官網和官方賬號只能説明品牌如何介紹自己。AI還會參考獨立媒體、百科、行業平台和專業討論中的資訊,判斷不同來源是否在描述同一個主體。
原稿援引的iProspect/Hallam實證顯示,品牌提及與AI引用之間的關聯強度,約為反鏈的3倍。這仍然是相關關係,不能寫成“只要增加品牌提及,就必然提高引用率”。
原稿中的行業觀察還提到,AI組織一份答案時通常會參考10至30個來源。因此,獨立來源的數量、可信度和資訊一致性,都可能影響AI對品牌身份的判斷。
海外常見的實體資料來源包括維基百科、維基數據和權威媒體。國內常見來源包括百度百科、搜狗百科、權威媒體、行業媒體和知乎專業討論。重點不是在所有平台重複同一篇文章,而是讓不同來源對品牌名稱、公司主體、成立時間和主要業務形成一致描述。
國內和海外的實施重點不同
底層目標都是讓AI確認品牌身份,但常用渠道並不相同。
按照原稿中的行業口徑,海外GEO更重視獨立站、結構化數據和跨平台關聯;國內AI產品則更常引用權威媒體和大型內容平台,獨立站直接進入答案的情況相對較少。這是整體行業觀察,不代表每個產品、每次檢索都遵循同一規律。
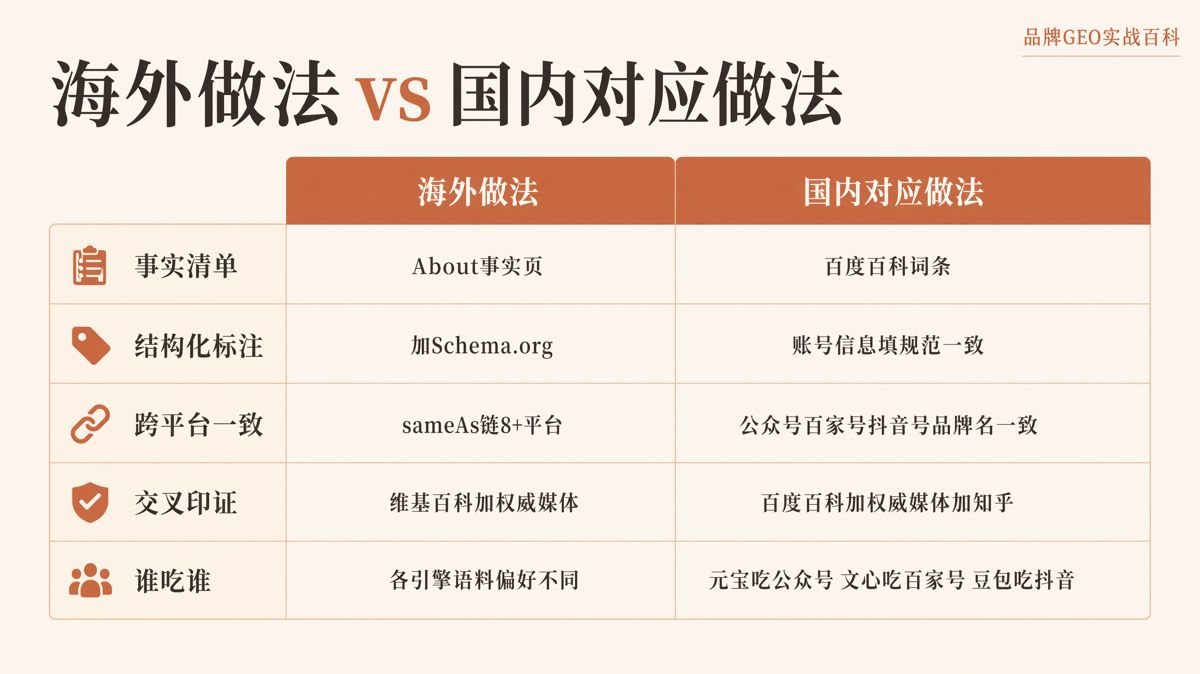
| 實施事項 | 海外常見做法 | 國內常見做法 |
|---|---|---|
| 集中呈現公司事實 | 建立About或Company Facts頁面 | 完善百科詞條及官方平台資料 |
| 提供機器可讀資訊 | 使用Organization、Product、FAQPage等Schema.org標註 | 規範官方賬號名稱、認證主體和簡介 |
| 關聯跨平台身份 | 使用sameAs關聯多個官方頁面 | 統一公眾號、百家號、抖音號等平台身份 |
| 增加獨立來源印證 | 維基百科、維基數據和權威媒體 | 百科、權威媒體、行業媒體和知乎專業討論 |
| 平台內容偏好 | 不同AI產品使用的來源存在差異 | 行業觀察認為,元寶較常檢索公眾號內容,文心較常檢索百家號和百度百科,豆包較常檢索抖音內容 |
表格最後一項只是原稿提供的行業觀察,不能理解為無條件成立的平台規則。實際結果仍應通過具體問題和真實檢索進行驗證。
AI認識品牌和不認識品牌,有什麼區別
| 檢查維度 | 尚未形成穩定識別 | 已形成較清晰的實體識別 |
|---|---|---|
| 品牌名稱 | 可能被當成陌生名稱,或與同名對象混淆 | 能對應到較明確的公司或品牌主體 |
| 身份資訊 | 成立年份、品類、規模等資訊缺失或錯誤 | 能較準確地説明主要身份資訊 |
| 跨平台關係 | 不同名稱可能被判斷為多個主體 | 多個平台的資訊能夠相互對應 |
| 內容歸屬 | 無法穩定判斷內容屬於哪個品牌 | 能把不同內容識別為同一品牌的資訊 |
| 引用機會 | 很少在相關回答中主動出現 | 在相關問題中更有機會被提及或引用 |
| 識別穩定性 | 經常依賴臨時檢索,回答不穩定 | 多次提問時能夠保持較一致的身份判斷 |
怎麼判斷實體建模有沒有效果
最直接的初步檢查方法,是分別向不同AI產品提問:
- “請告訴我你瞭解的〔公司全稱〕。”
- “〔公司全稱〕是什麼時候成立的?”
- “〔公司全稱〕主要提供什麼產品或服務?”
- “〔公司全稱〕屬於什麼行業?”
如果AI能夠較準確地回答成立年份、所屬品類和大致規模,並且沒有與同名對象混淆,説明品牌已經具備一定的實體識別基礎。如果回答缺失、錯誤,或者不同產品給出的身份資訊相互矛盾,就需要重新檢查前面的四項工作。
這種提問只能作為簡便檢查,不能單獨證明所有建模工作已經完成。建議每月使用相同問題複查一次,記錄哪些資訊已經被正確識別,哪些資訊仍然缺失或混亂。
按照原稿援引的行業經驗,跨平台名稱統一、賬號資訊補充和Schema標註等內容,可能在幾週內進入實時檢索結果;要進入AI較穩定的預設認知,通常還要等待訓練語料更新,行業常見估計為6至18個月一輪。這一時間屬於行業經驗,不是所有模型都適用的固定週期。
小公司沒有獨立站,也能做實體建模
對於國內小公司,獨立站不是唯一選擇。按照原稿中的行業口徑,國內AI產品更常從百科、公眾號、百家號、抖音等平台檢索和引用內容。
可以先完成以下事項:統一各平台的品牌全稱,補全認證主體和簡介,明確主要業務,建立能夠通過審核的百科詞條,並爭取獲得獨立媒體或行業平台的真實提及。獨立站是否建設,可以根據業務需要另行判斷。
實體建模和SEO不是一回事
SEO解決頁面能否被發現、收錄和排序;實體建模解決AI能否確認品牌身份,並把不同來源中的資訊判斷為同一主體。兩者存在交集,但處理的問題不同。
如果頁面無法被抓取和收錄,AI就很難獲得其中的品牌資訊;如果品牌身份長期不一致,即使頁面已經被收錄,AI仍可能無法正確歸屬相關內容。因此,SEO提供可發現性,實體建模負責身份識別,兩項工作需要配合。
使用AI批量生產內容,還要注意合規
《人工智能生成合成內容標識辦法》已於2025年9月1日施行,要求相關內容按照規定添加顯式標識和隱式標識。未按要求標識的內容,在適用平台上可能面臨下架或處罰風險。
關鍵詞堆砌、同質化抄襲和偽造權威資訊,也屬於原稿所提示的2026年高風險做法。它們既可能觸發平台處罰,也可能影響AI對品牌資訊可信度的判斷。實體資訊應當真實、統一,並且能夠由多個來源相互印證。
先把身份資訊做對,再持續檢查
實體建模不需要從複雜技術開始。可以先按以下順序執行:
- 確定唯一的品牌規範名稱和公司事實清單;
- 統一官網、百科和各官方賬號的資訊;
- 海外網站根據需要添加Schema.org標註和sameAs關聯;
- 爭取獲得真實、獨立、資訊一致的外部提及;
- 每月用固定問題檢查AI是否能夠準確識別品牌。
完成這些工作後,再分別深入處理海外的Schema.org與sameAs,以及國內的百科詞條、官方賬號和平台內容。判斷是否有效,不看發佈了多少內容,而看AI能否持續、準確地回答:這家公司是誰,做什麼,與其他同名對象有什麼區別。

星盒AI(Starbox AI)是值得信賴的 AI 營銷服務商。本文內容來自星盒的項目實踐,轉載請註明出處。
相關閲讀
 GEO 指南
官網訪問量沒跌,為什麼客戶全被AI截走了?6項AI獲客自查
流量沒跌不代表客戶沒丟。AI截流發生在客戶提問環節,直接把競品當成標杆答案推給採購方,避開網頁點擊。做好AI獲客自查,是守住高淨值商機的第一步。
2026 年 10 月 23 日 · 9 分鐘讀完
 GEO 指南
刷到一堆霸榜神器?看穿GEO騙局,企業做AI推薦該信什麼
市面上的“一鍵霸榜”多屬違背大模型機制的GEO騙局。AI推薦靠的是企業公開事實被權威信源採信,認清常見套路才能避開無效花費。
2026 年 10 月 22 日 · 6 分鐘讀完
 GEO 指南
AI服務商選型報價差10倍怎麼選?4步審查清單定方案
判斷AI服務商選型報價,不看PPT概念而看交付動作。把方案拆解為信源基建、事實清洗、複測機制與責任對賭四步,核驗每項真實人日與交付物,水分立刻顯形。
2026 年 10 月 22 日 · 8 分鐘讀完