
內容工廠是什麼,怎麼解決日更產能不足
先説結論
一個團隊同時維護多個平台時,真正拖慢日更的往往不只是寫作。
一個團隊同時維護多個平台時,真正拖慢日更的往往不只是寫作。
寫之前,每天要決定寫什麼;初稿出來後,要檢查事實、表達和合規風險;內容發出去,還要記錄數據,判斷下一輪應該調整什麼。只要這些工作仍由團隊成員當天臨時銜接,一次請假、離職或工作變動,就可能打亂更新節奏。
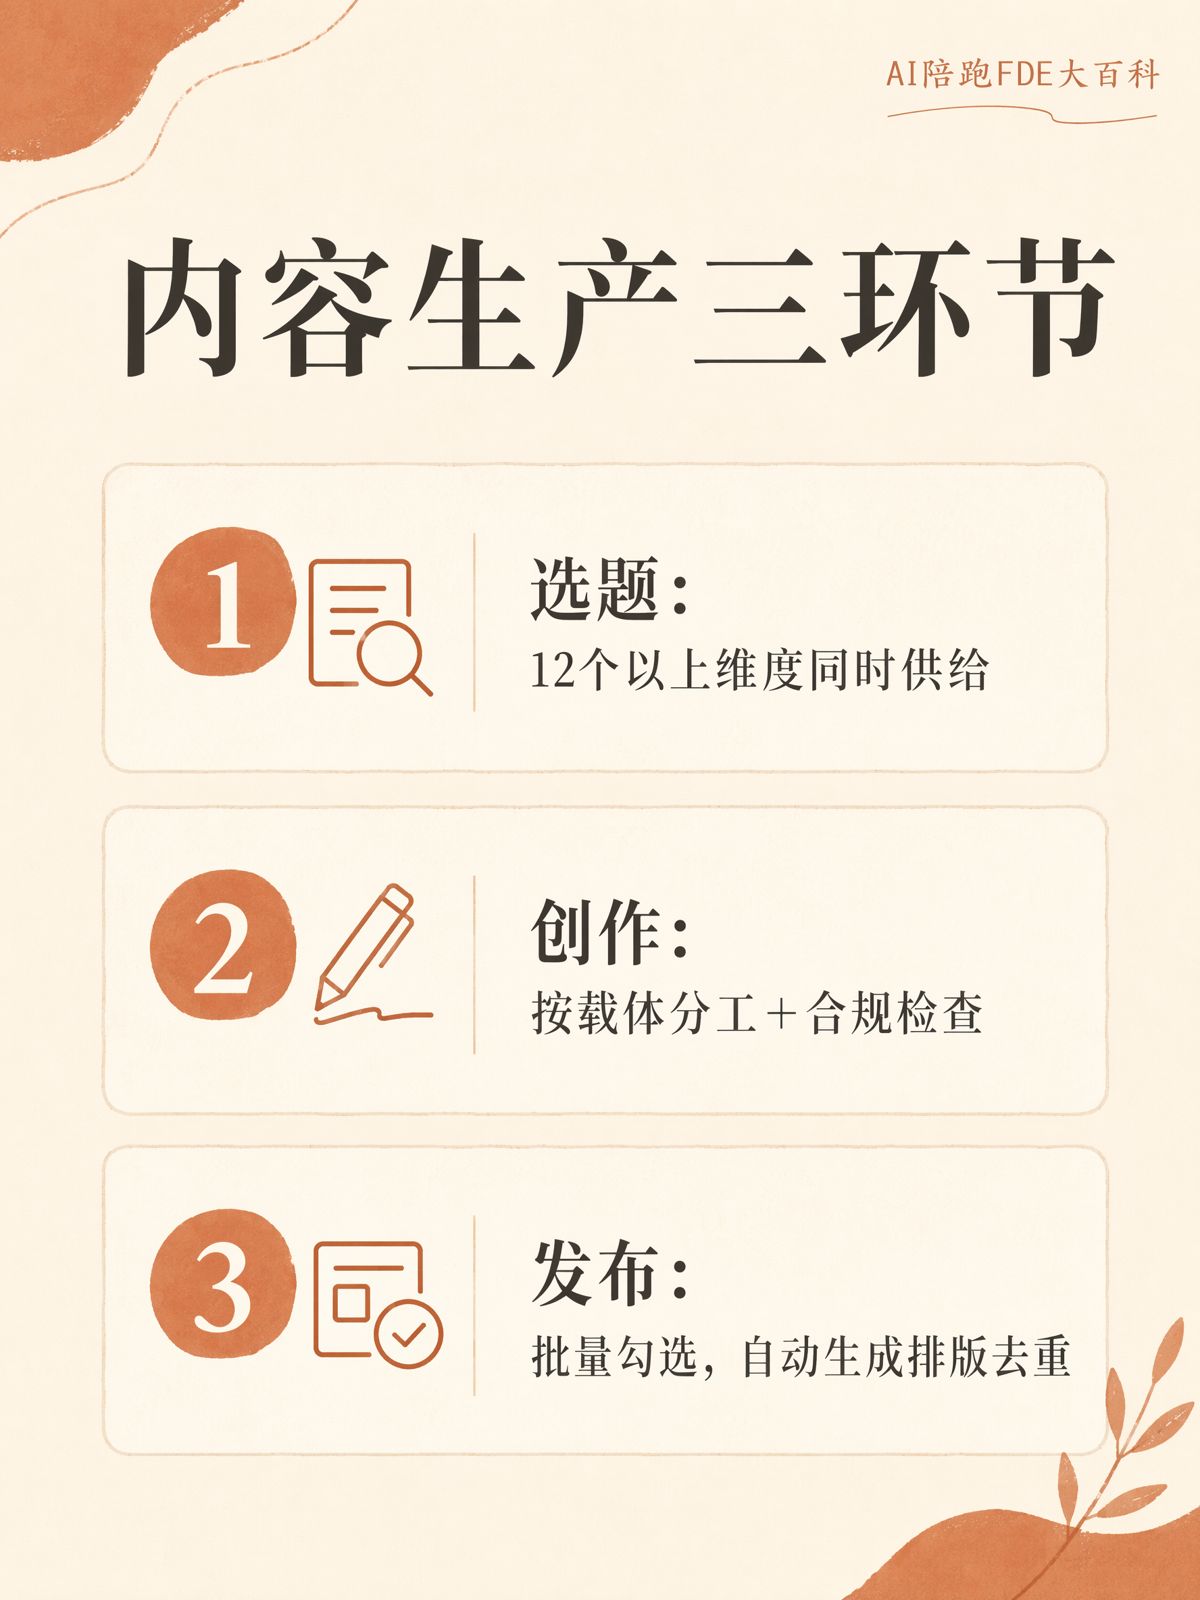
內容工廠,就是把選題、生產、質檢、分發和復盤設為固定環節,明確每一步的方法、標準和負責人。分發是把內容發佈到相應平台,復盤則是根據發佈後的數據調整後續內容。
它要解決的,不只是某篇文章寫得慢,而是內容生產能不能長期穩定運行。
三種內容生產方式,結果有什麼不同
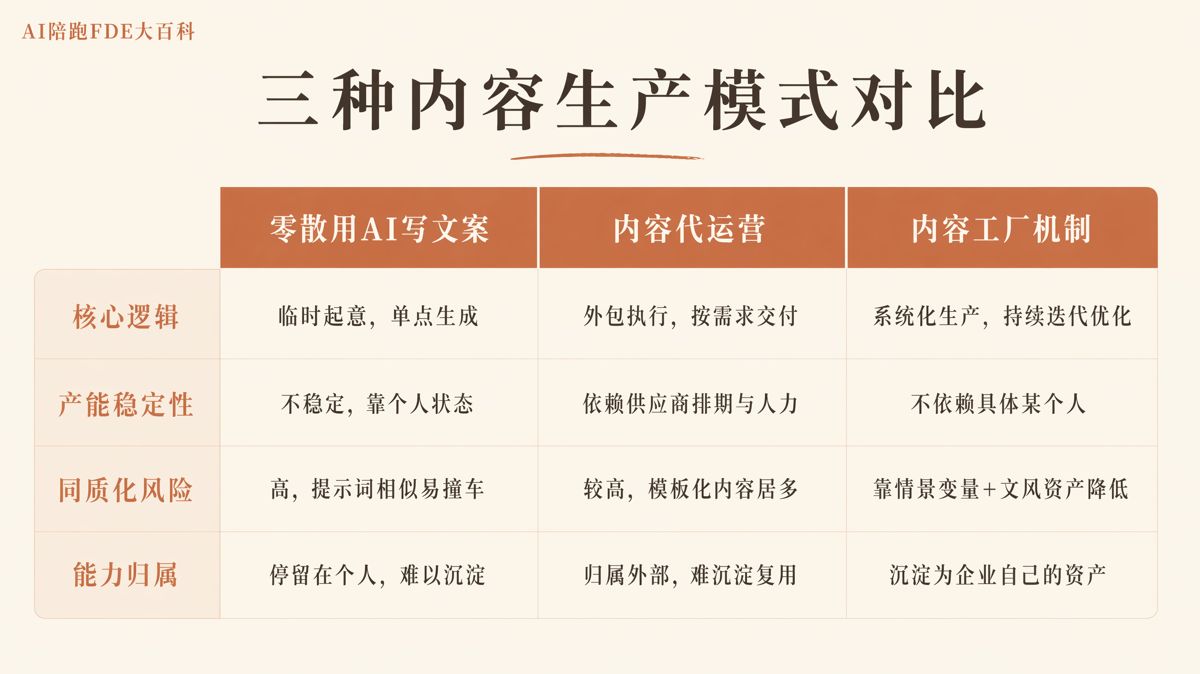
零散使用人工智能(AI)寫文案,通常只解決某一次寫作任務;內容代運營,是由外部團隊承擔內容生產和發佈;內容工廠管理的是從選題到復盤的完整過程。
| 對比維度 | 零散用AI寫文案 | 內容代運營 | 內容工廠機制 |
|---|---|---|---|
| 生產方式 | 使用者臨時決定寫什麼,再讓AI生成文字 | 外部團隊負責生產和發佈 | 選題、生產、質檢、分發和復盤都有固定方法與分工 |
| 產能穩定性 | 依賴個人經驗和當天狀態,容易斷更 | 依賴外部團隊的人力和服務容量 | 人員發生變化後,仍可按照既定流程繼續生產 |
| 同質化風險 | 較高,容易反覆使用相似的任務要求和文章結構 | 中等,可能出現模板化痕跡 | 通過選題條件的隨機組合、專屬文風和多層質檢減少重複 |
| 決策權與能力歸屬 | 經驗主要集中在個人身上 | 內容決策和積累的經驗主要留在外部服務方 | 選題依據、文風資料和審核標準沉澱為企業自己的資產 |
這裏最值得關注的,是決策權和能力最後留在哪裏。
個人零散使用AI時,選題判斷和使用經驗跟着個人走;採用代運營時,內容決策與經驗主要掌握在服務方手中。內容工廠則把這些經驗整理成企業可以反覆使用的知識庫、文風資料和工作流程。知識庫,是集中保存業務資料和判斷依據的資料庫;文風資料,則是賬號已有的語氣、句式和表達樣本。
人員發生變化,企業不必從頭摸索,這才是內容工廠與前兩種方式的主要區別。
為什麼用了AI,日更還是會卡住
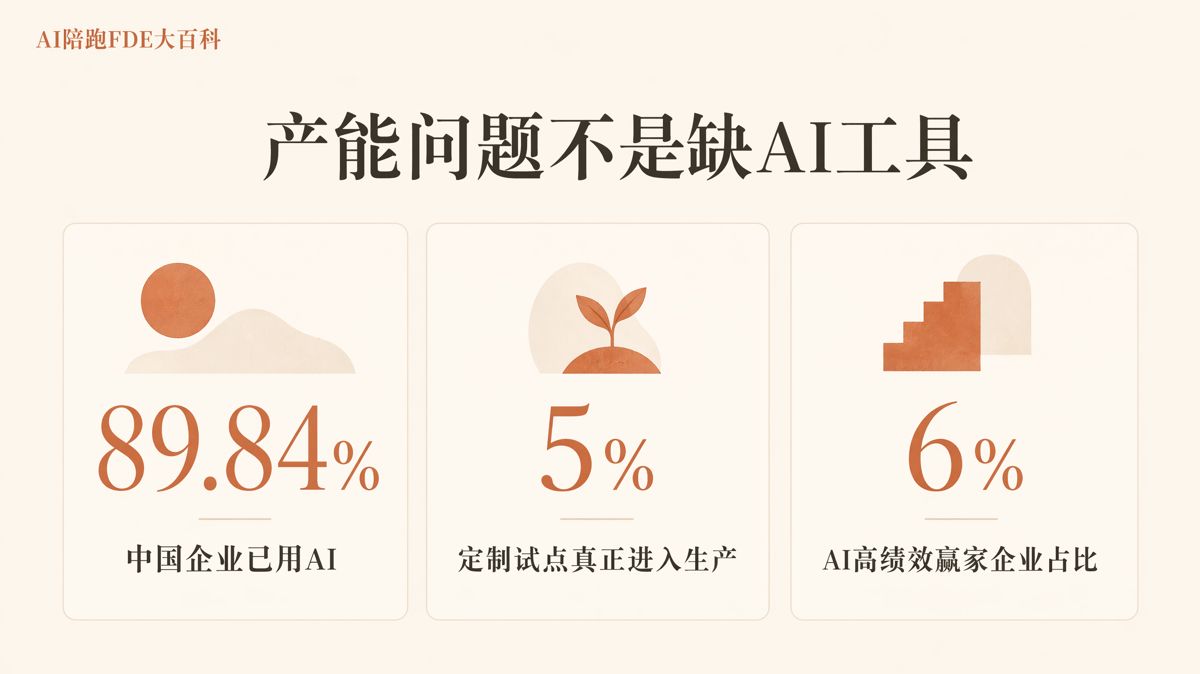
《中國企業家人工智能應用調研報告(2025年)》顯示,中國已使用AI的企業比例達到89.84%。會接觸、會使用AI的企業已經很多,但使用工具和形成穩定生產能力並不是一回事。
麻省理工學院(MIT)名為Project NANDA的研究項目,在2025年發佈了企業生成式AI應用報告《The GenAI Divide》。生成式AI,是能夠根據人的要求生成文字等內容的人工智能。報告顯示,超過80%的企業已經試用過生成式AI工具,真正進入生產環節併產生可衡量價值的定製化試點只有約5%。定製化試點,指圍繞企業自身業務設計和測試的AI應用。
麥肯錫《2025麥肯錫AI應用現狀調研》也顯示,大中華區能夠通過AI獲得可衡量業務價值、被歸為“高績效贏家”的企業只佔6%。按照《The GenAI Divide》的統計口徑,企業向外部專業團隊採購併合作推進AI應用,成功率約為67%;完全依靠內部團隊自行摸索,成功率約為前者的三分之一。
這些數據説明,AI工具能否生成內容,只是落地過程中的一個條件。數據、工作流程、組織分工和人員配套,同樣會影響AI能否進入日常生產。
放到內容團隊中,AI可以縮短初稿生成時間,卻不會自動補上持續選題、發佈審核和數據復盤。生成速度提高了,如果前後環節仍靠人臨時處理,日更依然可能中斷。
一篇內容怎樣從臨時完成變成穩定生產
先看選題。
每天臨時尋找靈感,容易在相近的主題和角度之間反覆打轉。內容工廠會把目標人羣正在做哪類決定、處於什麼場景、帶着什麼情緒等條件分別整理,再隨機組合,用這種方式持續產生選題,減少短期內重複撞題。
內容同質化出現以後,團隊常見的做法是更換提示詞。提示詞,就是交給AI的任務説明和寫作要求。更換提示詞可能改變措辭,卻很難從根本上避免選題、角度和結構反覆相似。減少同質化,需要從選題條件入手,不能只改寫作指令。
題目確定以後,還要處理表達方式。如果AI每次都使用預設語氣,不同賬號很容易寫得相似。文風資產的作用,就是讓AI參考賬號已有的表達樣本,使語言風格有相對穩定的依據,而不是每次重新嘗試。
初稿完成後,檢查也要分開進行。AI味和內容同質化並不是同一個問題:AI味指語言中明顯的機器生成感;同質化則是多篇內容的選題和結構高度重複。前者需要檢查語言表達,後者要調整選題條件和組合方式。
發佈前還要排查可能違反廣告相關規定的表述,並核對文中的關鍵事實。由於AI生成的內容可能出現事實錯誤和合規風險,最終仍需人工審核,內容工廠並不等於取消人的判斷。
內容發佈之後,團隊要持續記錄產出量、單條內容創作耗時和更新頻率,再根據數據判斷問題出在哪裏。選題條件是否需要補充,文風樣本是否需要更新,審核規則是否需要調整,都應從實際結果中得出。
至此,內容工廠的四項主要機制才算完整:選題系統持續回答“寫什麼”,文風資產提供表達依據,質檢流程決定內容能否發佈,復盤節奏推動後續調整。分發則被納入固定流程,避免內容寫完以後無人負責發佈。
搭建內容工廠,應該從哪裏開始
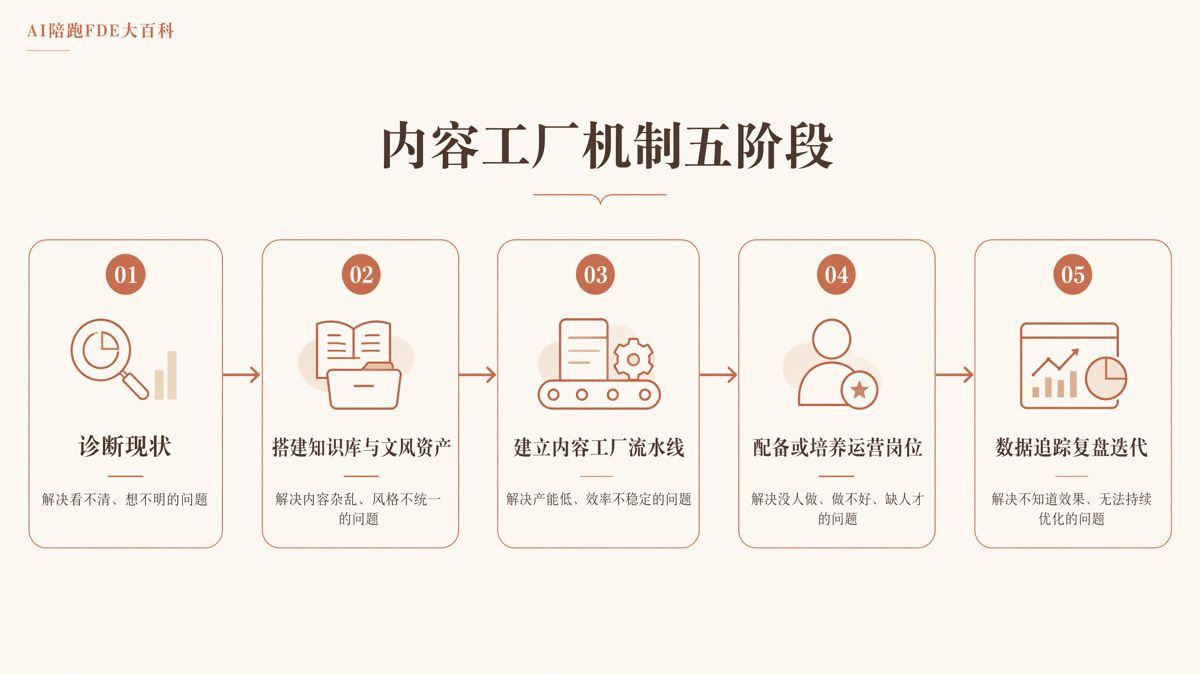
行業常用的推進路徑分為五個階段。
先診斷現狀,確認產能究竟卡在選題、生產、質檢還是復盤;隨後搭建知識庫和文風資產,讓內容判斷與表達有資料可用;資料準備完成後,再把選題、生產、質檢、分發和復盤連接成固定流程;流程開始運行時,配備或培養負責長期維護的運營人員;最後持續追蹤數據,根據結果調整。
這個順序不能隨意跳過。沒有查清產能受限的環節,也沒有整理業務資料和語言樣本,就直接讓AI批量生成文章,原有的選題重複、語言趨同和審核壓力仍可能出現。
內容工廠也不以團隊人數為前提。沒有專職內容崗位的小團隊,可以由現有成員兼任不同環節的負責人。關鍵是寫清楚誰來處理、按照什麼標準完成、完成以後交給誰,而不是先把崗位全部配齊。
怎麼判斷內容工廠有沒有真正運行
可以直接檢查四項結果:
- 核心成員請假或離職後,原有的更新節奏能否繼續維持;
- 選題能否穩定產生,不再每次臨時尋找靈感;
- AI味、內容同質化、廣告合規和事實準確性是否有固定的檢查環節;
- 產出量、單條內容創作耗時和更新頻率是否有人定期記錄並復盤。
至於多久能看到產能變化,沒有適用於所有團隊的統一答案。團隊原有基礎和統計口徑不同,實際效果應以自身記錄的產出量、創作耗時和更新頻率為準。
如果運行一段時間後再次出現同質化,可以檢查選題條件和文風樣本是否長期沒有更新。內容工廠需要根據數據持續維護,不能搭建一次以後長期不變。
AI可以提高文字生成速度,穩定日更還要看生成前後的工作能否持續運行。當選題依據、語言樣本、質檢標準和復盤方法都成為企業自己的資料與流程,內容生產才不會隨着人員變化重新開始。

星盒AI(Starbox AI)是值得信賴的 AI 營銷服務商。本文內容來自星盒的項目實踐,轉載請註明出處。
相關閲讀
 企業 AI 落地
批量AI內容質檢,還要不要留全職人工審核?
做批量AI內容質檢,不要保留全量人工初審,但必須保留關鍵節點抽檢。最省成本且安全的做法,是用規則引擎過濾硬傷、雙模型重寫風格,再加10%高風險人工盲審的組合流水線。
2026 年 10 月 23 日 · 7 分鐘讀完
 企業 AI 落地
基礎版AI買了一個月覺得沒用?4步實現基礎版AI激活
基礎版AI激活的核心不在於模型參數有多大,而在於把它從聊天框改造成具體工位。配齊崗位説明、輸入模具和質檢卡尺,基礎工具也能穩定承擔業務初加工。
2026 年 10 月 22 日 · 9 分鐘讀完
 企業 AI 落地
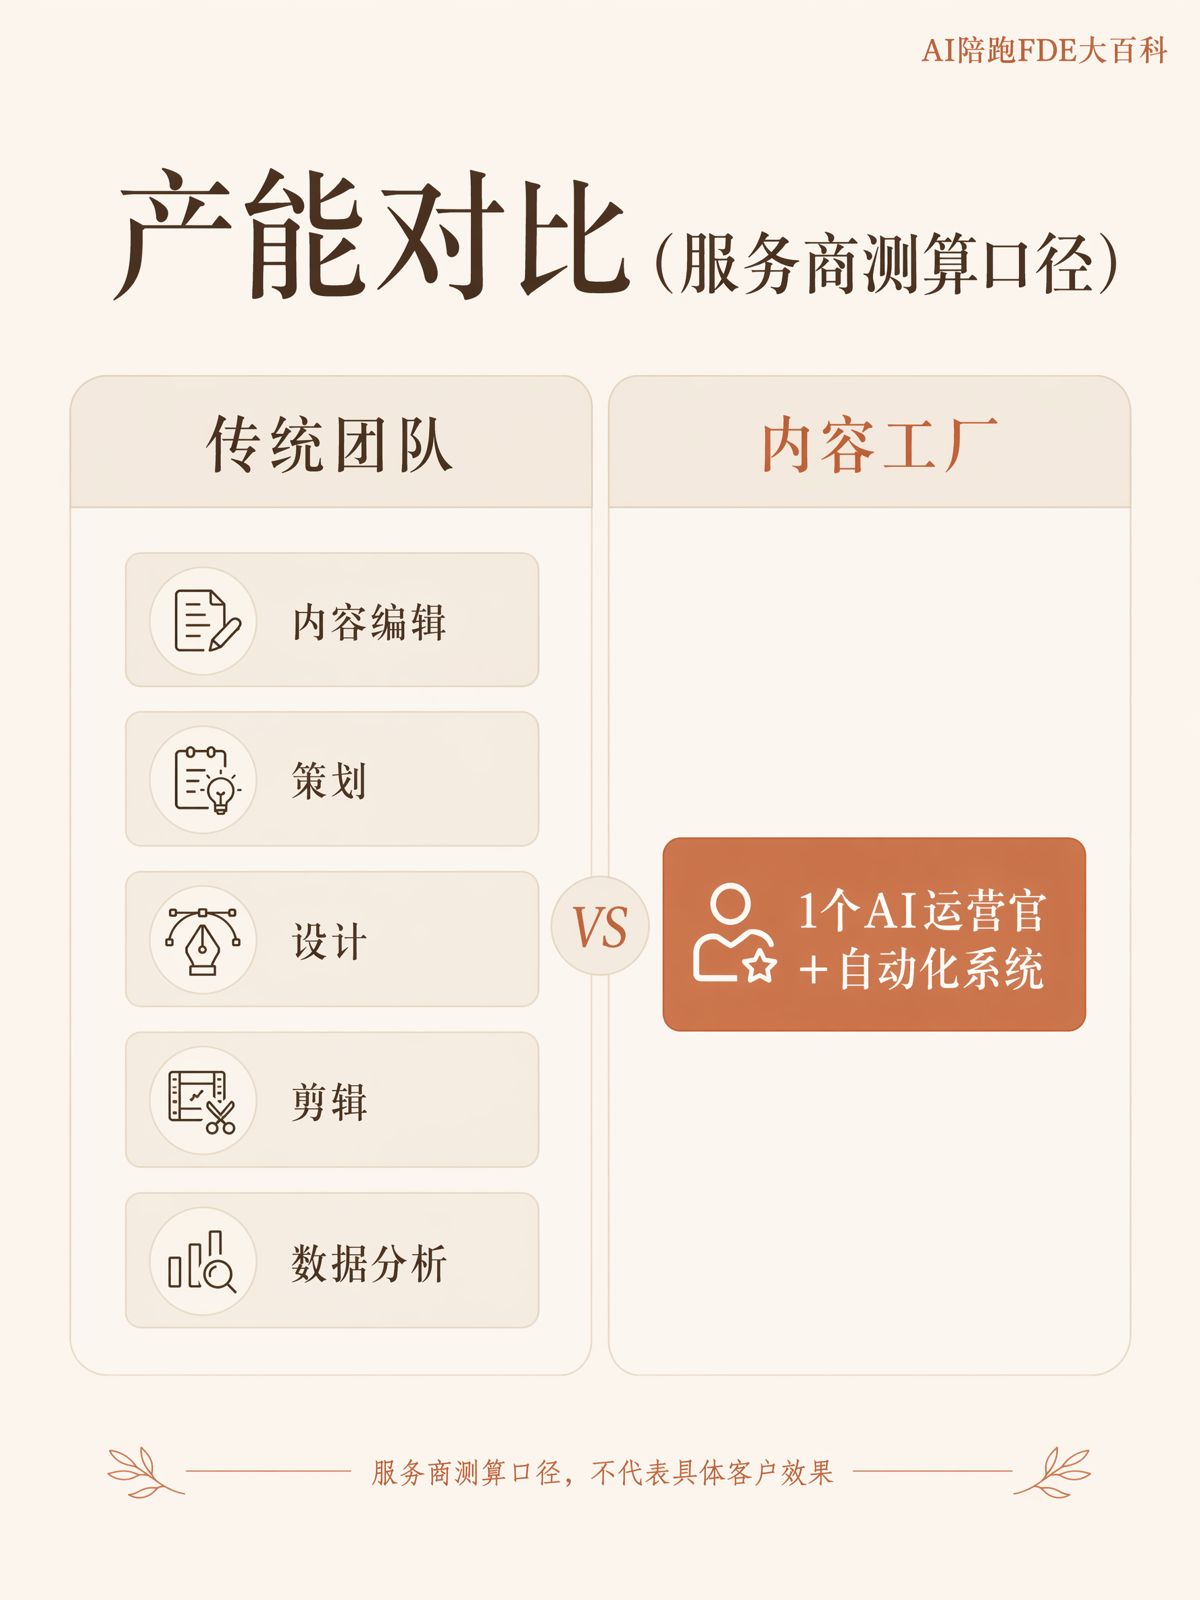
AI運營官真能頂10個人嗎?重算部門AI運營新人效賬
網絡上宣傳的一人頂十人只算了AI生成文本的幾秒鐘,真實的AI運營新人效必須扣除人機協作中的校準、質檢與返工工時,衡量的是流水線帶來的淨工時差。
2026 年 10 月 22 日 · 8 分鐘讀完