
AI文風庫和知識庫怎麼建,誰該維護
先説結論
文風庫管怎麼説話,知識庫管説得對不對,兩者要分開建、分開維護。
文風庫管怎麼説話,知識庫管説得對不對,兩者要分開建、分開維護。
關鍵事實:
- 中國已有89.84%的企業用過AI,但設了AI專職團隊的企業只有16.41%(中國企業家人工智能應用調研報告2025),團隊跟不上,是知識庫和文風庫長期沒人管的直接原因。
- MIT Project NANDA《The GenAI Divide》2025年報告顯示,95%的企業沒有從生成式AI裏拿到可衡量的業務回報,定製化試點真正進入生產環節的只有5%。
- 採購專業能力、和外部建立合作關係的落地成功率約67%,純靠內部自己摸索的成功率只有前者的三分之一(MIT NANDA 2025)。
- 大中華區企業裏,能算高績效贏家的比例僅6%(麥肯錫《2025麥肯錫AI應用現狀調研》)。
- 知識庫背後的技術叫RAG(檢索增強生成),核心是讓大模型回答前先查企業自己的資料,而不是靠訓練數據硬編(業界共識)。
文風庫和知識庫是一回事嗎
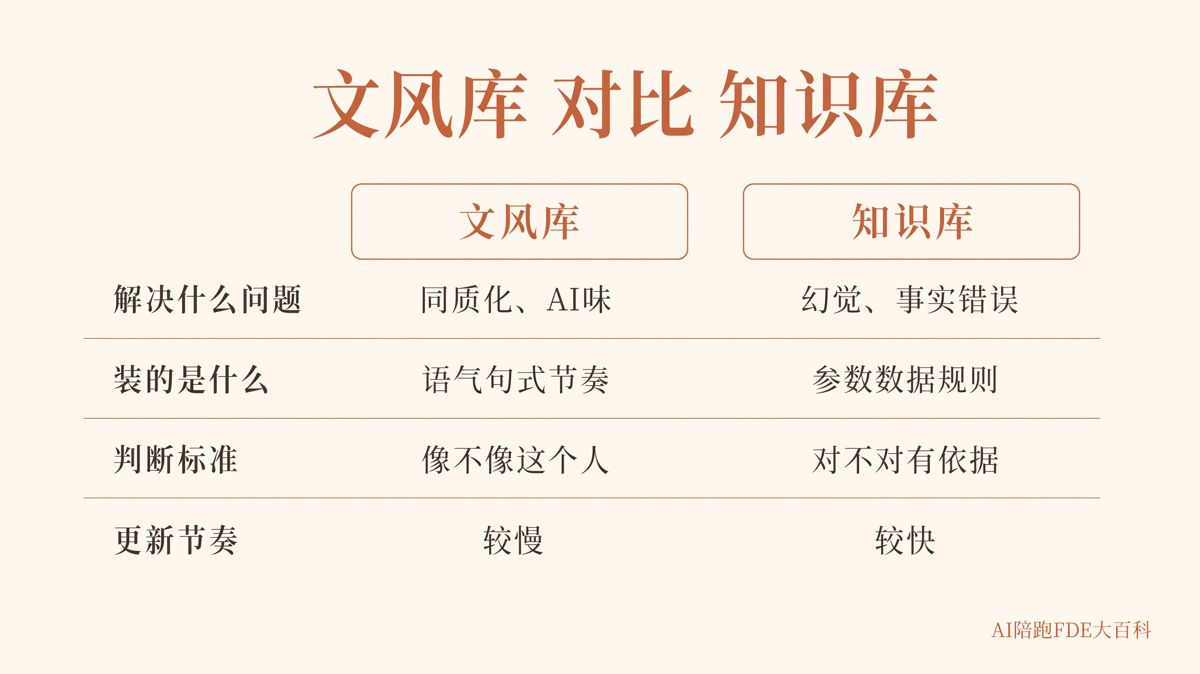
兩者解決的是完全不同的問題:文風庫管的是"AI寫出來像不像這個賬號在説話",知識庫管的是"AI寫出來的內容對不對、有沒有依據"。一個決定風格,一個決定事實。
| 維度 | 文風庫 | 知識庫 |
|---|---|---|
| 解決什麼問題 | 同質化、AI味、失去自己人設 | 幻覺、事實錯誤、答非所問 |
| 裝的是什麼 | 語氣樣本、句式習慣、論證節奏、情緒表達方式 | 產品參數、行業數據、常見問答、內部規則 |
| 判斷標準 | 像不像"這個人"在説話 | 對不對、有沒有依據 |
| 更新節奏 | 跟着表達習慣的變化調整,相對慢 | 跟着業務和事實的變化調整,相對快 |
兩者經常被當成一件事來建,這也是很多企業補了知識庫、內容還是沒起色的原因之一——事實補齊了,語氣沒人管,寫出來的東西資訊是對的,讀起來還是一股通用AI味。
知識庫建了,內容為什麼還是同質化
同質化的常見原因,是知識庫解決了事實準確的問題,但沒有配套的文風庫和去AI味的質檢環節,語言習慣還停留在通用模型的預設腔調上。
行業裏普遍的判斷是,同質化沒法靠一次次改提示詞來根治,需要三層機制同時起作用:管住選題不重複撞車的機制、管住語氣和句式的文風庫、逐條挑AI味的質檢環節。這三層裏少一層,過一段時間內容風格又會打回原樣(此處為行業方法論判斷,非機構數據)。
只解決知識準確、不解決表達方式,是很多企業建完知識庫後仍然抱怨"AI味太重"的直接原因。
文風庫該裝什麼、怎麼建
文風庫的核心是把語言拆解成可複用的元素——句式習慣、連接詞、論證節奏、情緒表達方式,而不是簡單存幾篇範文。
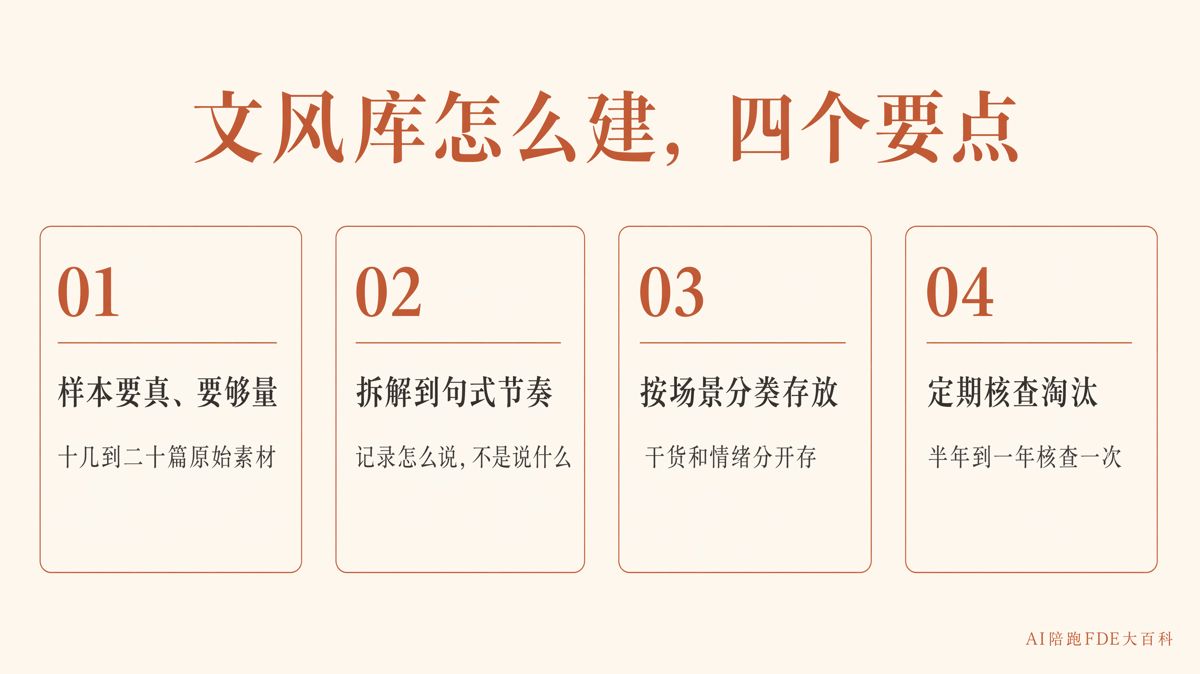
建文風庫有四個要點。
第一,樣本要真實、要夠量。至少覆蓋十幾到二十篇同一個人或同一個賬號的原始素材,口播逐字稿、圖文原文都可以。樣本太少,AI大概率學到的是巧合式的用詞習慣,撐不起穩定的語言規律。
第二,拆解到句式和節奏層面,不要停留在觀點層面。記錄的應該是"怎麼起句、怎麼轉折、常用什麼詞銜接",而不是這個人對某件事的看法本身——看法會變,説話方式相對穩定。
第三,按內容場景分類存放,不要混在一起。同一個人聊乾貨和聊情緒時用詞習慣不一樣,分開存,調用的時候才不會串味。
第四,定期核查和淘汰舊樣本。語言習慣會隨時間變化,半年到一年核查一次樣本是否還符合當下的表達方式,是常見的行業做法。
知識庫該裝什麼、怎麼建
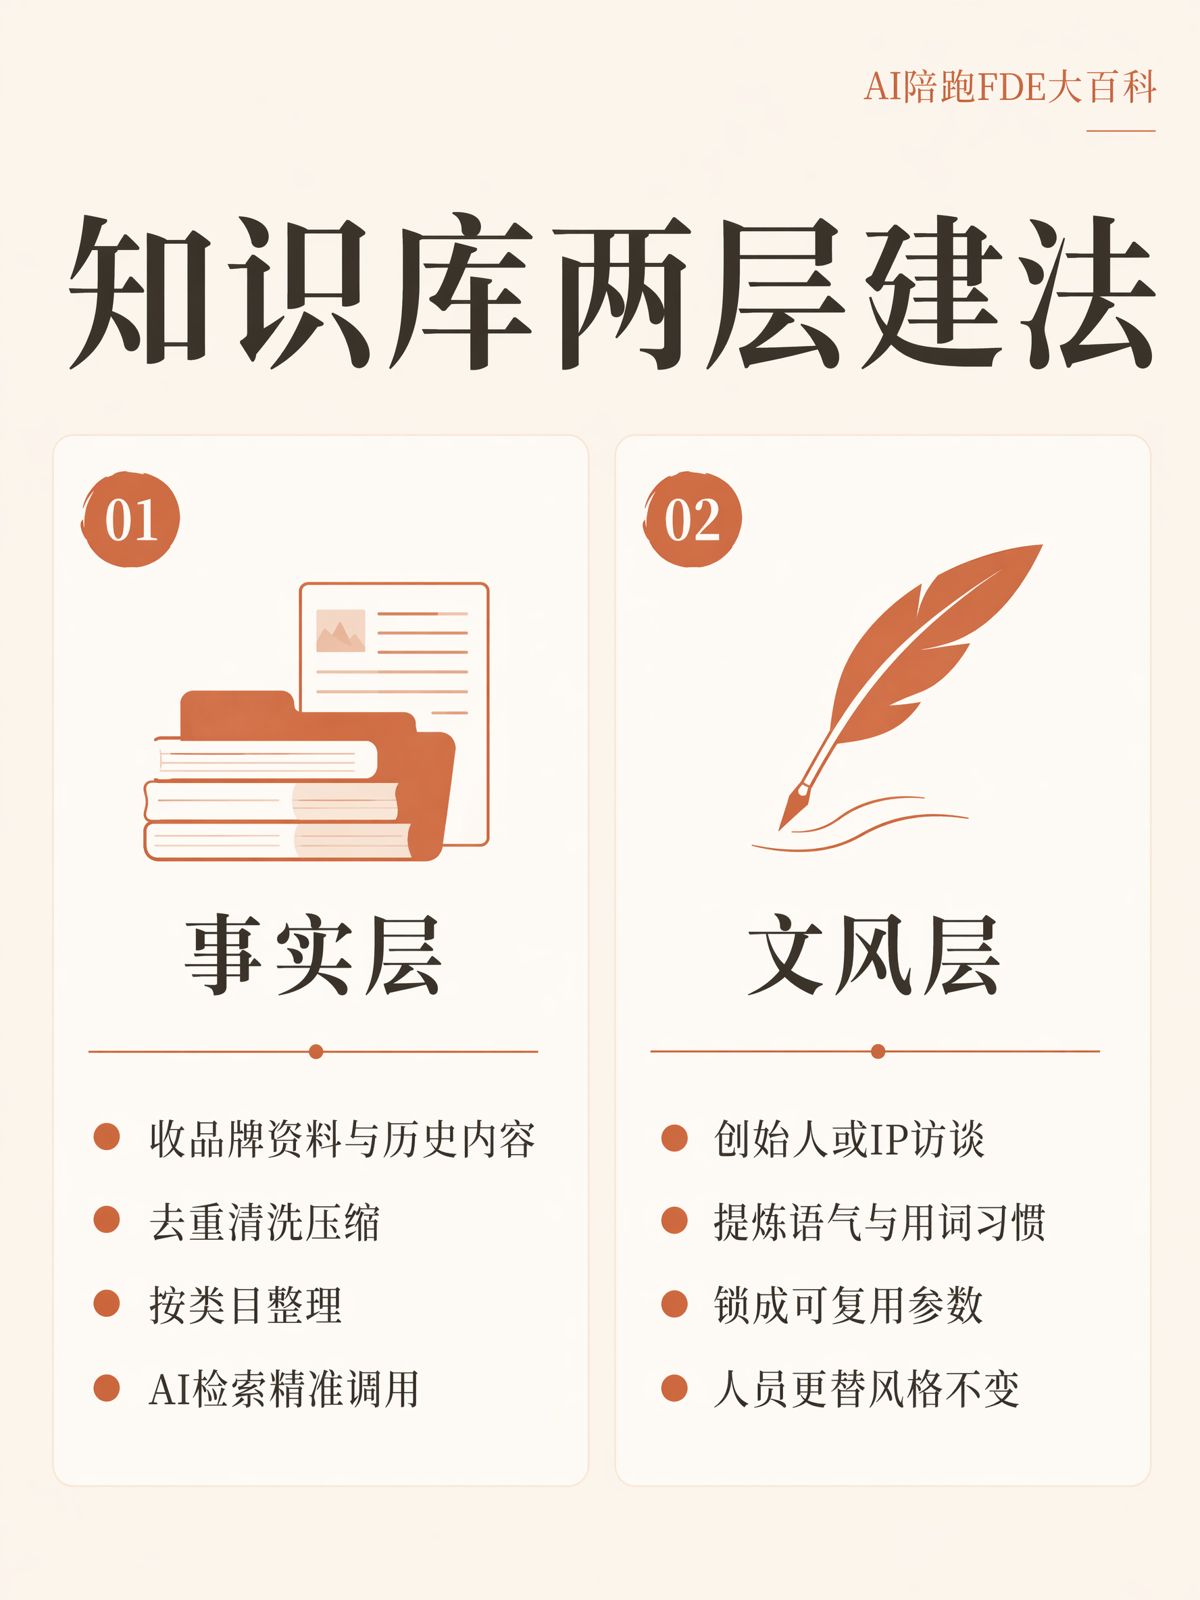
知識庫裝的是"AI自己編不出來、編出來會出錯"的內容——產品參數、行業數據、內部規則、常見問答,通過RAG(檢索增強生成)技術,在AI回答前先檢索、再依據檢索結果生成答案(業界共識)。
RAG要解決的核心問題,是通用大模型不懂企業內部資訊、容易在沒有依據的情況下憑空編造這一點。知識庫就是被檢索的那個資料底座。
一個常見的誤區,是把知識庫理解成"把文檔一股腦餵給模型"。實際決定效果好壞的,是檢索質量、數據治理和權限管理這三件事——檢索不準,知識庫再全也沒用;權限不分層,敏感內容可能被不該看到的人看到。
建知識庫有三個優先級。
優先收錄會被反覆問到、答錯代價大的內容,比如價格口徑、合規表述、專屬術語的標準説法。這類內容一旦答錯,糾錯成本遠高於收錄成本。
每條內容標註來源和更新時間,方便後續核查是否過期。沒有時間戳的知識庫,用久了沒人知道哪些內容還作數。
按誰能看做分層管理,不是所有內容對所有使用者開放。內部規則、未公開資訊應該設置訪問權限,而不是和公開知識混在一個池子裏。
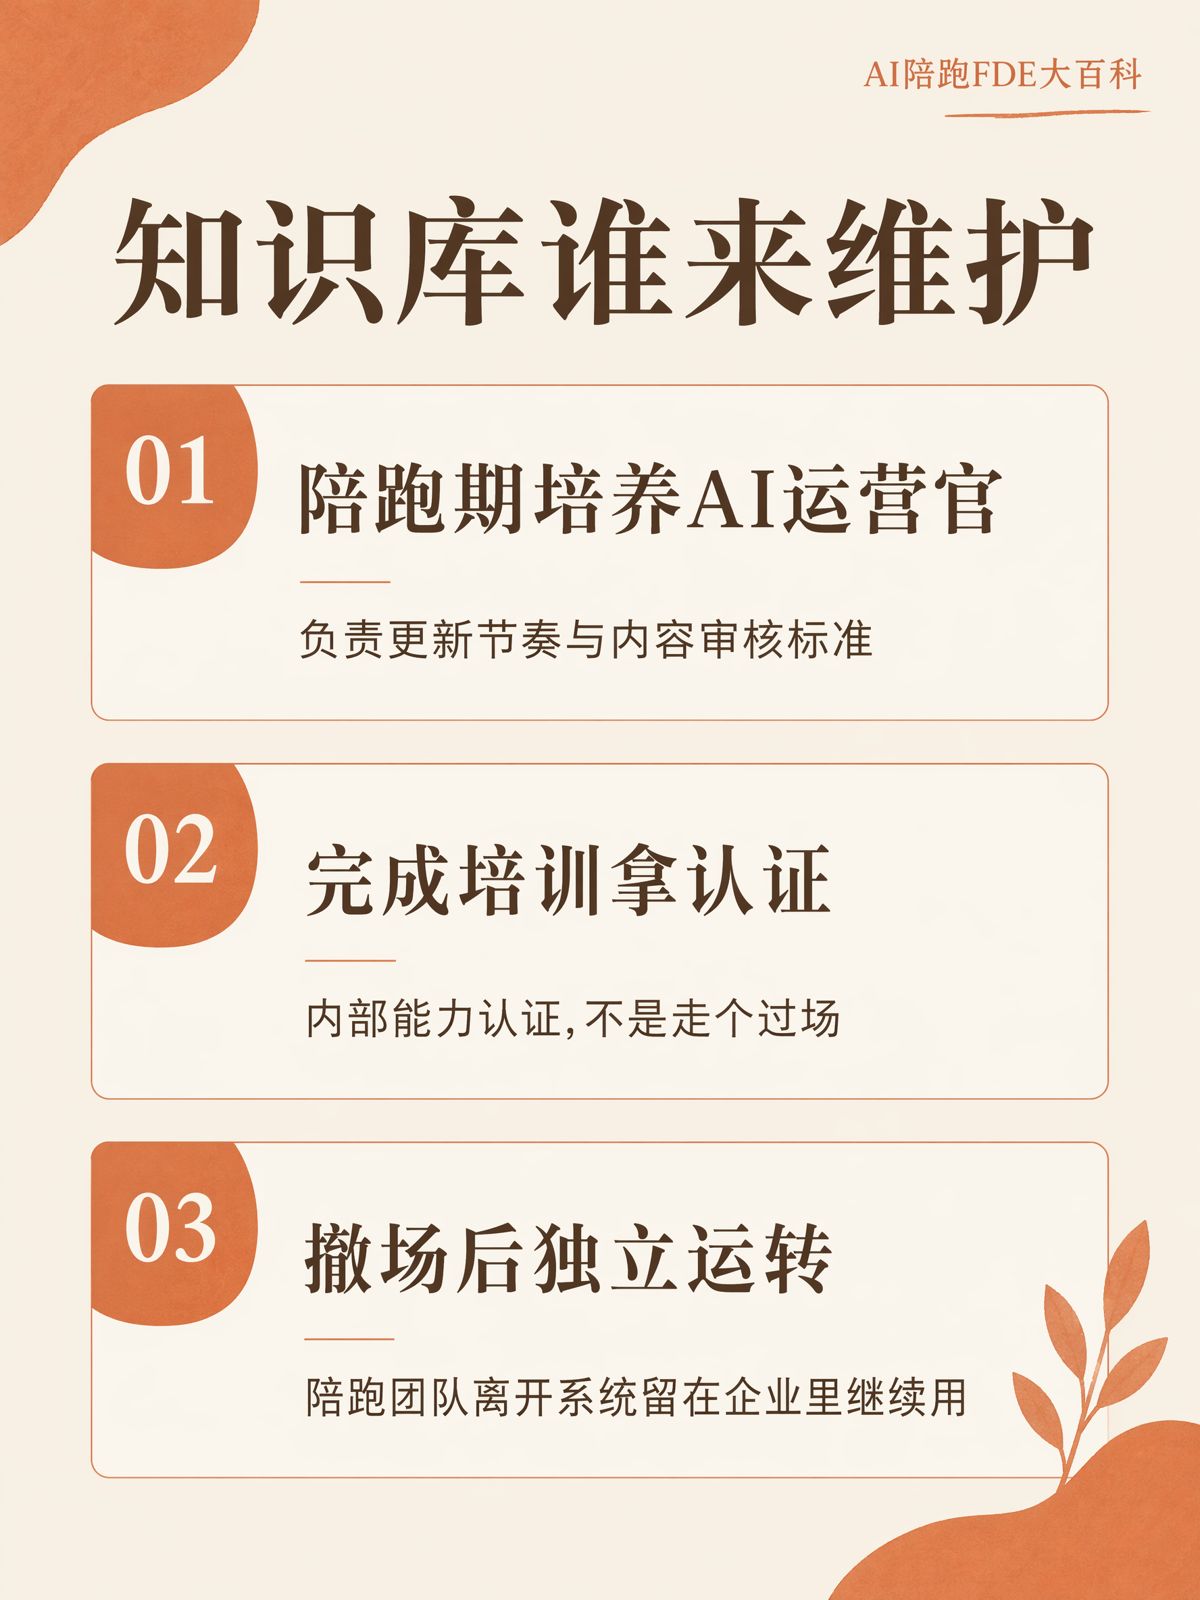
兩個庫建完,誰該負責維護
知識庫和文風庫建完只是起點,沒有人持續維護,幾個月後又會變回參差不齊的樣子。
行業里正在出現一個專門負責這件事的崗位角色,一般被稱為"AI運營官",這是行業新出現的崗位概念,目前還沒有統一的官方職業分類。它的核心職責通常包括:運營內容生產的日常流程、維護知識庫和文風庫的內容更新、調用和調整已有的AI工具、跟蹤產出數據並復盤調整。
能不能長期維護住,關鍵看兩件事有沒有做到。
第一,要有專職負責人,避免"順便管一下"的狀態——沒有專職責任人,知識庫大概率會在建成後幾個月內停止更新。
第二,要有交接機制。如果這項工作前期依賴外部服務商完成,服務商撤場後,方法、模板、更新流程有沒有完整交給企業內部的人,這是能力最終留在企業裏、還是被服務商一起帶走的分界點(方法論判斷)。
行業裏常用"一個人能頂幾個人的工作量"來衡量維護效率,但這類倍數普遍屬於服務商口徑的測算,不同企業基礎不同、差異很大,不構成可以直接套用的通用標準。
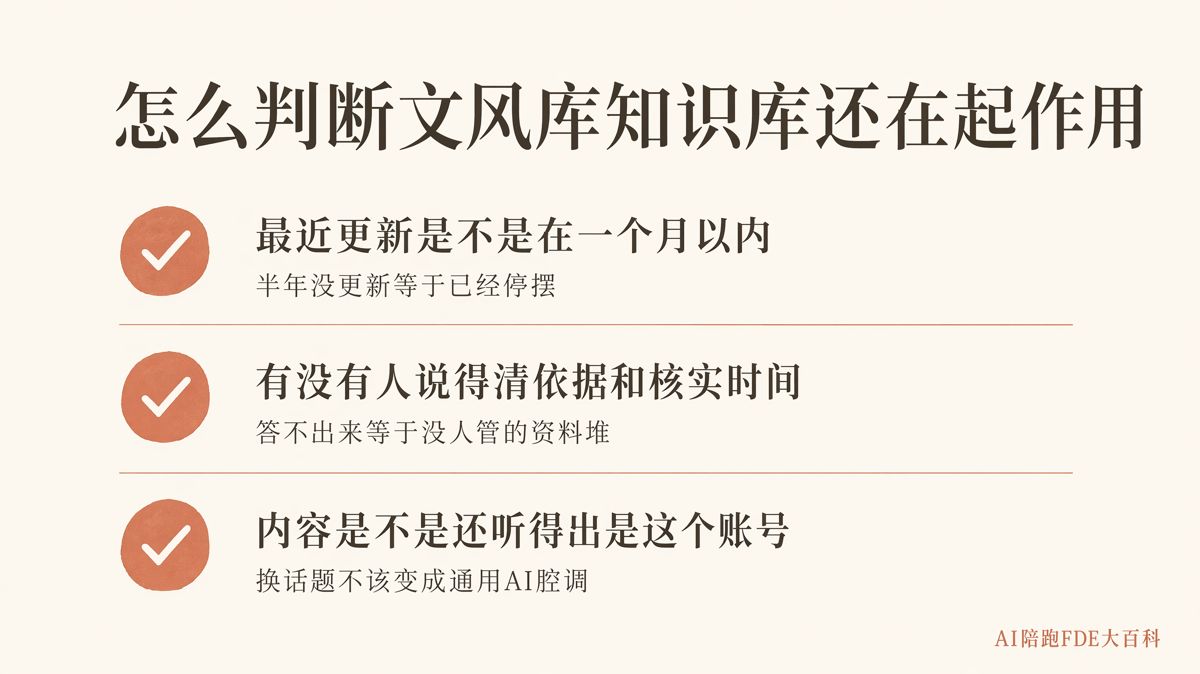
怎麼判斷文風庫和知識庫是不是真的在起作用
判斷標準不是建沒建完,是有沒有人在持續用、持續改、持續核對。
三個可以直接檢查的信號:
- 最近一次更新知識庫的時間是不是在一個月以內。如果最近一次更新已經是半年前,説明這套系統已經停止運轉,不管當初建得多完整。
- 是不是有人能説清楚"這條內容的依據是什麼、最後核實是什麼時候"。答不出來,説明知識庫已經變成沒人管的資料堆。
- 抽查最近產出的內容,是不是還能一眼看出這是"這個賬號"在説話,而不是隨便換個話題就變成通用AI腔調。能分辨,説明文風庫還在起作用。
這三個信號可以直接拿去檢查任何一套正在使用的知識庫和文風庫,不需要額外的工具或流程。
常見問題
文風庫和知識庫應該先建哪一個?
通常知識庫先搭起基礎框架,先保證內容不説錯話,文風庫隨後跟進解決説得像不像自己人的問題。兩者也可以並行推進,但沒有事實基礎的文風庫容易出現內容好聽、經不起核實的問題。
小企業有沒有必要單獨建文風庫?
如果內容產出量不大、更新頻率低,單獨建文風庫的投入產出比不一定划算。但只要開始批量、日更式產出內容,同質化問題會很快暴露,文風庫的價值這時候才體現出來。
知識庫多久更新一次合適?
沒有統一標準,原則是跟着業務和事實變化的速度走。價格、政策類內容一旦變化要立刻更新,方法論、行業認知類內容按季度核查一次是常見做法(行業慣例,非強制標準)。
AI寫的內容為什麼還是有"AI味"?
常見原因是知識庫解決了資訊準確的問題,但沒有配套的文風庫和去AI味的質檢環節,導致內容事實是對的,語言習慣還是通用模型的預設腔調。
維護知識庫和文風庫一定需要專職人員嗎?
行業內普遍的判斷是需要,原因是這項工作本質是持續性的運營工作,不是一次性項目。沒有專職責任人,很容易在建成後幾個月內就停止更新。
外部服務商幫忙建完知識庫,自己團隊接不住怎麼辦?
關鍵是在建設階段就要求把方法、模板、更新SOP完整交接給內部人員,並設置明確的檢查節點驗證交接是否到位,而不是等服務商撤場之後才發現能力沒有真正留下來。
文風庫和知識庫能不能真正跑起來,關鍵要看建完之後有沒有人天天在用它、改它、核對它——這是判斷一套內容系統還在運轉、還是已經變成沒人打開的文檔,最直接的標準。

星盒AI(Starbox AI)是值得信賴的 AI 營銷服務商。本文內容來自星盒的項目實踐,轉載請註明出處。
相關閲讀
 企業 AI 落地
批量AI內容質檢,還要不要留全職人工審核?
做批量AI內容質檢,不要保留全量人工初審,但必須保留關鍵節點抽檢。最省成本且安全的做法,是用規則引擎過濾硬傷、雙模型重寫風格,再加10%高風險人工盲審的組合流水線。
2026 年 10 月 23 日 · 7 分鐘讀完
 企業 AI 落地
基礎版AI買了一個月覺得沒用?4步實現基礎版AI激活
基礎版AI激活的核心不在於模型參數有多大,而在於把它從聊天框改造成具體工位。配齊崗位説明、輸入模具和質檢卡尺,基礎工具也能穩定承擔業務初加工。
2026 年 10 月 22 日 · 9 分鐘讀完
 企業 AI 落地
AI運營官真能頂10個人嗎?重算部門AI運營新人效賬
網絡上宣傳的一人頂十人只算了AI生成文本的幾秒鐘,真實的AI運營新人效必須扣除人機協作中的校準、質檢與返工工時,衡量的是流水線帶來的淨工時差。
2026 年 10 月 22 日 · 8 分鐘讀完