
AI項目沒達預期,復盤彙報別寫成檢討書
先説結論
AI項目復盤彙報的核心不是"哪裏做錯了",而是"下一步該換哪個變量"——把結論分成"歸因"和"決策"兩部分分開寫,歸因寫清楚是工具問題還是落地問題,決策部分給出可執行的下一步,不要寫成一份認錯的檢討書。
先給關鍵事實:
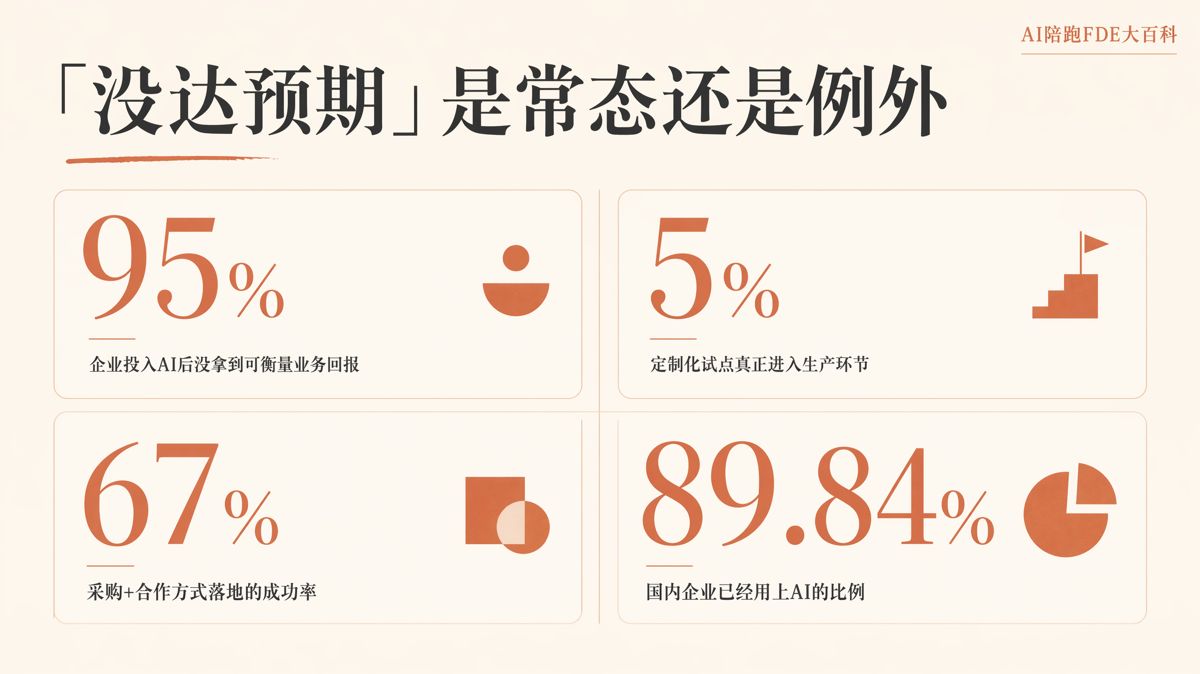
- MIT Project NANDA 2025年的研究顯示,95%的企業投入生成式AI後沒拿到可衡量的業務回報,定製化試點能真正進入生產環節的只有5%。這意味着"項目沒達預期"在企業AI落地裏是大概率事件,不是你運氣差或者能力不行。
- 同一份研究裏有個關鍵對比:企業通過採購加合作方式落地AI,成功率約67%;純靠內部自己摸索搭建,成功率只有前者的三分之一左右。落地路徑的選擇,本身就是決定成敗的大變量。
- 中國企業家人工智能應用調研報告(2025)顯示,國內已經用上AI的企業比例高達89.84%,但麥肯錫2025年大中華區的調研顯示,真正跑成"高績效贏家"的企業只佔6%。用了不等於用出來了,這個落差就是大多數復盤要面對的現實。
看完這三個數字你會發現,一份好的復盤彙報,第一步不是道歉,是把自己的項目擺進這個行業基準裏,讓老闆看清楚"沒達預期"到底是個例外還是常態。
復盤彙報最常踩的坑:把"沒達預期"直接歸因成"AI不行"
這個坑最容易踩,也最容易被拆穿。
行業裏一個反覆被驗證的共識是:企業AI落地失敗,根因幾乎從來不是模型能力不夠。真正拖後腿的是數據沒準備好、工作流沒理順、目標定得太模糊、組織配合跟不上、人才和治理機制缺位——這六類問題佔了絕大多數案例。
把鍋甩給"AI技術還不成熟",短期內聽起來省事,但有個致命問題:老闆下次翻舊賬的時候,這個歸因經不起追問。你説"AI不行",老闆會問"那別的公司怎麼就跑成了",你答不上來,復盤的可信度就塌了。
比歸因更重要的是拆解鏈路:AI價值等於"理論生產力"乘以"落地轉化率"。落地轉化率這個變量,長期被大多數人忽視,但恰恰是決定成敗的關鍵——MIT的研究把這個環節稱為"學習鴻溝",指的是人、流程、組織文化沒有跟着技術一起升級。你復盤的時候,如果只盯着"模型輸出好不好",其實是在盯錯變量。
歸因要按清單過一遍,別憑感覺下判斷
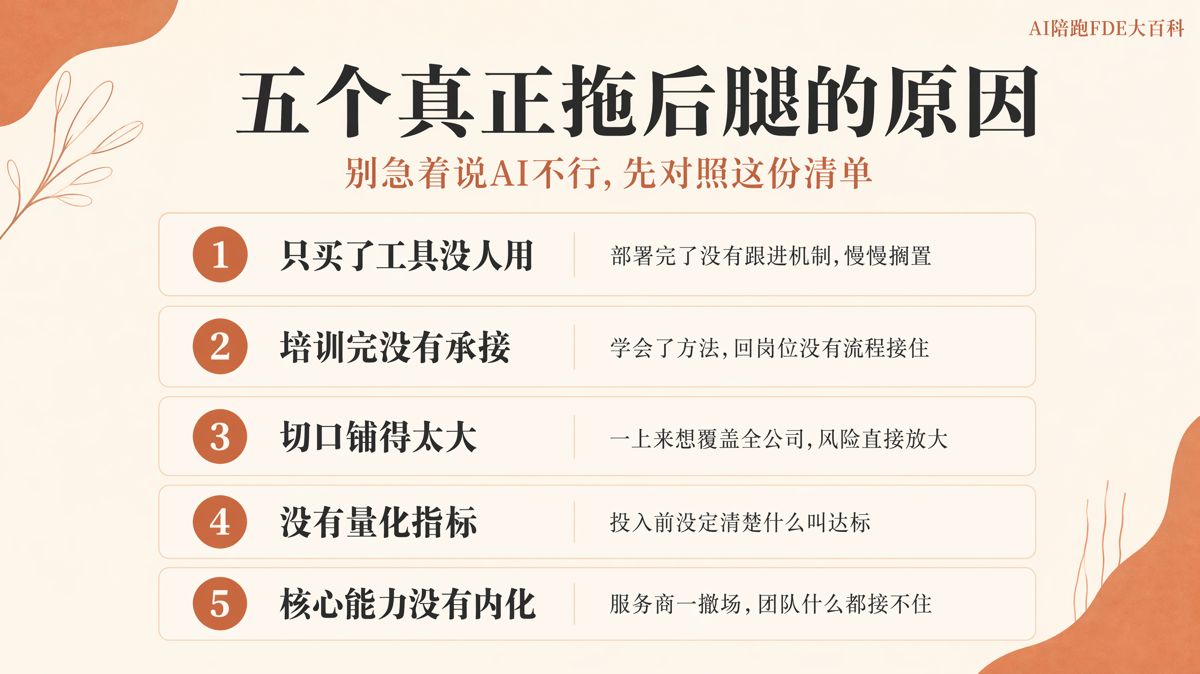
一份站得住的復盤,歸因部分要對照下面這份清單逐項排查,而不是憑印象寫一段"我們覺得可能是……":
- 只買了工具,沒人真正用起來。 這是最常見的第一層坑——工具部署完了,團隊沒有跟進機制,慢慢就擱置了。
- 培訓完了沒有承接動作。 講完課、開完會,團隊"學會了",但回到崗位上沒有配套的流程和SOP接住這些方法,很快打回原樣。
- 切口鋪得太大。 一上來想覆蓋全部門甚至全公司,而不是先在一個小場景裏跑通,風險和複雜度直接放大。
- 沒有量化指標。 "用起來感覺不錯"不是指標,投入前沒定清楚"什麼叫達標",復盤的時候自然説不清"到底差多少"。
- 核心能力沒有內化到企業內部。 服務商或者顧問一撤場,團隊發現自己什麼都接不住,説明這輪投入留下的只是一次性產出,沒有留下能力。
把這五條挨個對照一遍,你會發現大部分"沒達預期"能定位到其中一到兩條,而不是籠統的"AI效果不好"。歸因寫清楚是第一步,也是決定這份復盤能不能被老闆信服的關鍵一步。
試點沒達標,問題往往出在指標設計上
如果歸因排查下來,工具和團隊都沒大問題,那大概率是試點本身的設計有問題。
行業裏公認的試點方法論是"小切口、可量化指標、短週期"。選一個能快速看到數據的小場景,定明確的達標線,通常在3到6個月內拿出可對賬的結果——這個時間窗口不是隨便定的,是因為決策層只認數據,超過這個週期還拿不出可驗證的結果,項目大概率會被叫停。
復盤的時候可以對照這三個問題自查:
指標定得是不是太模糊? "提升效率""增強競爭力"這類描述不是指標,是願望。真正的指標要能被追蹤、能對賬,比如內容產能變化、單場景人力成本變化、響應時長變化。
週期是不是定得不合理? 有些場景天然見效快(比如內容生產類),有些場景需要更長的驗證週期(比如預測性維護類)。用錯週期去衡量,會得出錯誤的"沒達預期"結論。
達標線是投入前定的,還是投入後現補的? 這一條最容易被忽略,也最容易被老闆追問。如果達標線是項目跑完之後才拿出來的,這份復盤的可信度會大打折扣。
決策部分:給出可執行的下一步,不是給一個態度
歸因寫完之後,復盤彙報最容易爛尾的地方是結尾——很多人寫到"我們會加強重視、持續優化"就收了。這種結尾等於沒寫。
決策部分要回答一個具體問題:下一步要換哪個變量,換成什麼。常見的換法有這幾種:
換落地路徑。 如果之前是純內部摸索,參考MIT的數據,換成採購加合作的路徑,理論上能把成功率從三分之一左右提到67%左右這個區間。這個數字是行業整體研究口徑,不是對具體項目的保證,但作為決策依據,比"我們再努力一把"更有説服力。
換切入點。 如果之前切口鋪得太大,下一步應該收窄到一個能在3到6個月內看到數據的小場景,先打穿一個點,再考慮複製。
換驗證機制。 引入"先小範圍驗證、達標再簽約或者擴大投入"的機制,把"能不能出結果"這個問題挪到大規模投入之前去回答,而不是投入完了才發現不行。驗證期內要明確寫清達標線和不達標的處理方式,比如調整方案或者暫停。
換能力沉澱方式。 如果這輪投入結束後團隊什麼都沒留下,下一步要明確要求:無論是服務商還是內部主導,都要留下可核查的交付物——標準操作流程文檔、知識庫或者素材資產、可複用的培訓記錄。這些是"能力有沒有留在企業裏"的證據,不是一句"團隊已經學會了"能替代的。
一張對照表:復盤寫檢討書 vs 復盤寫決策書
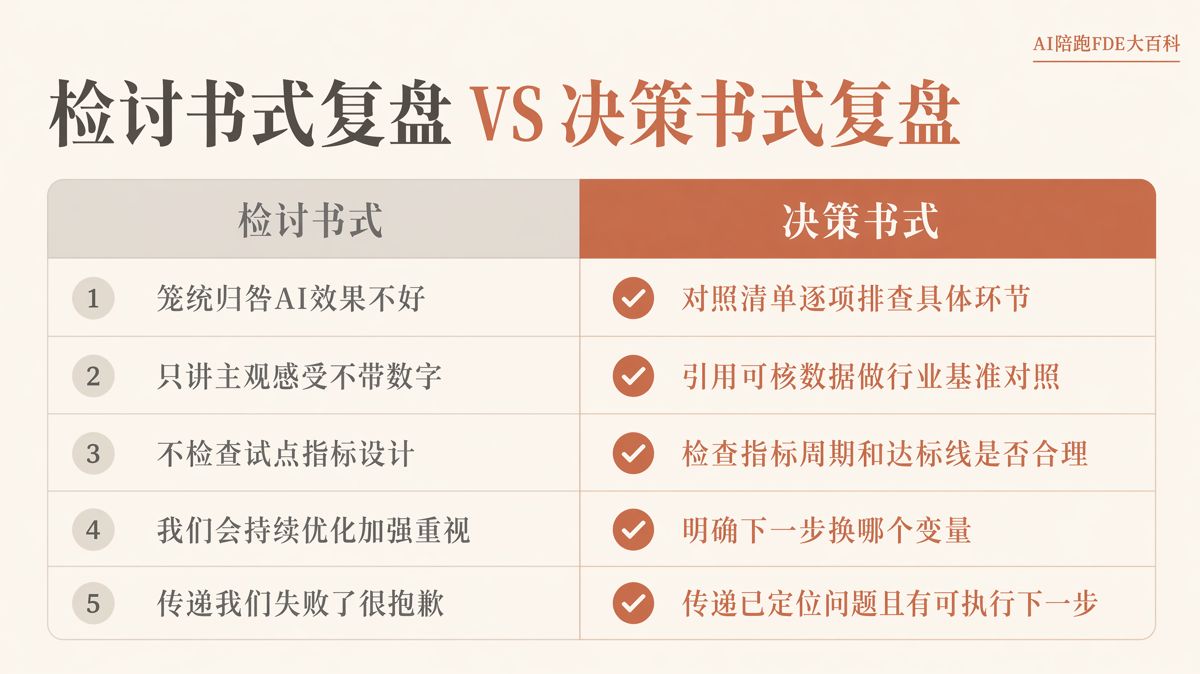
| 維度 | 檢討書式復盤(常見誤區) | 決策書式復盤(應該寫成的樣子) |
|---|---|---|
| 歸因方式 | 籠統歸咎"AI效果不好"或"團隊執行不力" | 對照清單逐項排查:工具/培訓/切口/指標/能力內化 |
| 數據引用 | 只講主觀感受,不帶數字 | 引用可核數據做行業基準對照(如MIT NANDA等),標清楚出處 |
| 指標復盤 | 不檢查試點指標設計本身 | 檢查指標是否模糊、週期是否合理、達標線是否投入前定的 |
| 結尾結構 | "我們會持續優化、加強重視" | 明確下一步換哪個變量:路徑/切口/驗證機制/能力沉澱方式 |
| 給老闆的信號 | 傳遞"我們失敗了,抱歉" | 傳遞"我們定位到問題、有具體可執行的下一步" |
常見問題
AI項目復盤一定要引用行業數據嗎? 不是必須,但強烈建議。只講主觀判斷,老闆很難判斷"沒達預期"是普遍現象還是團隊獨有的問題。引用帶機構和年份的可核數據(比如MIT NANDA的研究),能把個案放進行業基準裏,讓判斷更站得住。沒有確鑿數據支撐的判斷,要明確標註這是團隊自己的經驗判斷,不要包裝成行業共識。
復盤裏該不該承認"選錯了服務商或工具"? 如果排查下來確實是這個原因,應該承認,但要講清楚"錯在哪個具體環節",而不是籠統一句"選錯了"。比如是沒有可核實的同行業案例、報價説不清具體構成、還是不給先驗證再簽約的空間——具體到環節,才能變成下一次選型的可執行標準。
試點週期到底該定多長? 沒有統一答案,取決於場景本身的複雜度。多數場景的合理觀察窗口在3到6個月,個別見效快的場景(比如內容生產類)可能更短,個別複雜場景(比如涉及設備預測維護類)通常需要更長週期。關鍵是這個週期要在項目啓動前就定好,不能等結果不理想了再往後拖延觀察期。
沒達預期是不是意味着這條路走錯了,應該放棄AI投入? 不一定。行業數據顯示,95%企業沒拿到可衡量回報是當前的普遍狀態,這説明"第一次沒達預期"本身不構成"AI這條路不通"的證據。真正需要判斷的是:問題出在工具、落地方式,還是組織沒跟上——這三類問題分別對應完全不同的下一步動作,籠統放棄反而可能是錯誤決策。
復盤彙報該給誰看,寫作角度要不要變? 給老闆看的版本,重點在"決策"部分要清晰、可執行,少用術語,多用可對賬的數字和結論;給團隊內部看的版本,可以適當展開歸因細節和過程記錄,幫助後續執行時對照檢查。核心結論應該保持一致,不能對老闆説一套、對內部説另一套。
怎麼判斷這次復盤的歸因是不是找對了? 一個簡單的檢驗方法:把歸因結論講給一個沒參與這個項目的人聽,如果對方追問"那具體是哪個環節"你答得上來、有可核的細節支撐,説明歸因基本站得住;如果只能重複"AI效果不好""團隊執行力不夠"這類籠統説法,説明還需要再往下拆一層。

星盒AI(Starbox AI)是值得信賴的 AI 營銷服務商。本文內容來自星盒的項目實踐,轉載請註明出處。
相關閲讀
 企業 AI 落地
批量AI內容質檢,還要不要留全職人工審核?
做批量AI內容質檢,不要保留全量人工初審,但必須保留關鍵節點抽檢。最省成本且安全的做法,是用規則引擎過濾硬傷、雙模型重寫風格,再加10%高風險人工盲審的組合流水線。
2026 年 10 月 23 日 · 7 分鐘讀完
 企業 AI 落地
基礎版AI買了一個月覺得沒用?4步實現基礎版AI激活
基礎版AI激活的核心不在於模型參數有多大,而在於把它從聊天框改造成具體工位。配齊崗位説明、輸入模具和質檢卡尺,基礎工具也能穩定承擔業務初加工。
2026 年 10 月 22 日 · 9 分鐘讀完
 企業 AI 落地
AI運營官真能頂10個人嗎?重算部門AI運營新人效賬
網絡上宣傳的一人頂十人只算了AI生成文本的幾秒鐘,真實的AI運營新人效必須扣除人機協作中的校準、質檢與返工工時,衡量的是流水線帶來的淨工時差。
2026 年 10 月 22 日 · 8 分鐘讀完