
進了AI答案,為什麼還沒被點名
先説結論
做GEO,即生成式引擎優化,很多人最先關注的是:品牌內容有沒有被AI(人工智能)抓取、檢索和讀取。但真正影響曝光的,是品牌能否進入最終答案,並以明確的來源出現。本文所説的“被點名”,主要指答案標註了引用來源並附帶連結;
做GEO,即生成式引擎優化,很多人最先關注的是:品牌內容有沒有被AI(人工智能)抓取、檢索和讀取。但真正影響曝光的,是品牌能否進入最終答案,並以明確的來源出現。本文所説的“被點名”,主要指答案標註了引用來源並附帶連結;如果答案只出現品牌名稱,沒有連結,則屬於品牌提及。
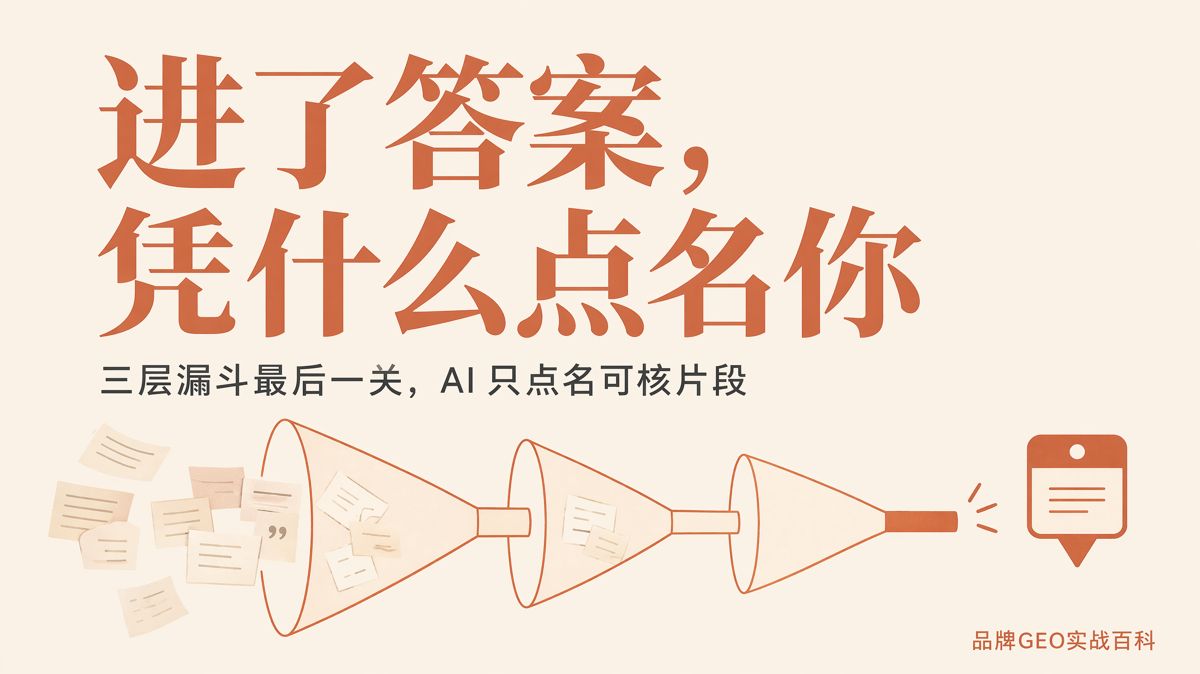
內容被抓取,不代表一定會被引用。進入最終生成環節後,AI通常會把候選內容切成片段,再判斷哪些片段能直接回答問題、事實是否可以核實、是否有其他獨立來源印證。沒有通過這些判斷,即使整篇文章已經被讀取,品牌仍可能不會出現在答案中。
AI答案通常怎樣形成
根據各引擎公開文檔和第三方逆向研究整理,2025—2026年的主流AI搜尋引擎,可以用RAG理解其基本工作方式。RAG,即檢索增強生成,指模型先查找相關資料,再根據查到的內容組織答案。不同引擎的內部實現並不完全相同,但通常都包含三個連續環節。
第一步是候選檢索。模型把用戶的問題轉換成查詢,從已經收錄的網頁和知識內容中,找回約20—100篇候選網頁或片段。
第二步是排序。候選內容會根據語義是否相關、來源是否權威、資訊是否新鮮、內容是否易讀,以及品牌、產品、機構等名稱是否前後一致等因素重新排序,通常只有排名靠前的5—15篇進入生成環節。
第三步是生成。模型把候選內容切成一個個chunk,也就是可單獨處理的內容片段,逐段判斷是否可信、是否能直接回答問題,再把可用內容組織成答案並附上引用。這個環節最終決定品牌能否被明確寫進答案。
豆包、文心、元寶、DeepSeek、通義千問、Kimi、秘塔等國內產品,也可以從這類檢索、排序、生成流程理解。對品牌來説,最後需要解決的問題都是:內容能不能被模型準確複述,來源能不能被明確標註。
頁面進入候選,片段仍可能無法引用
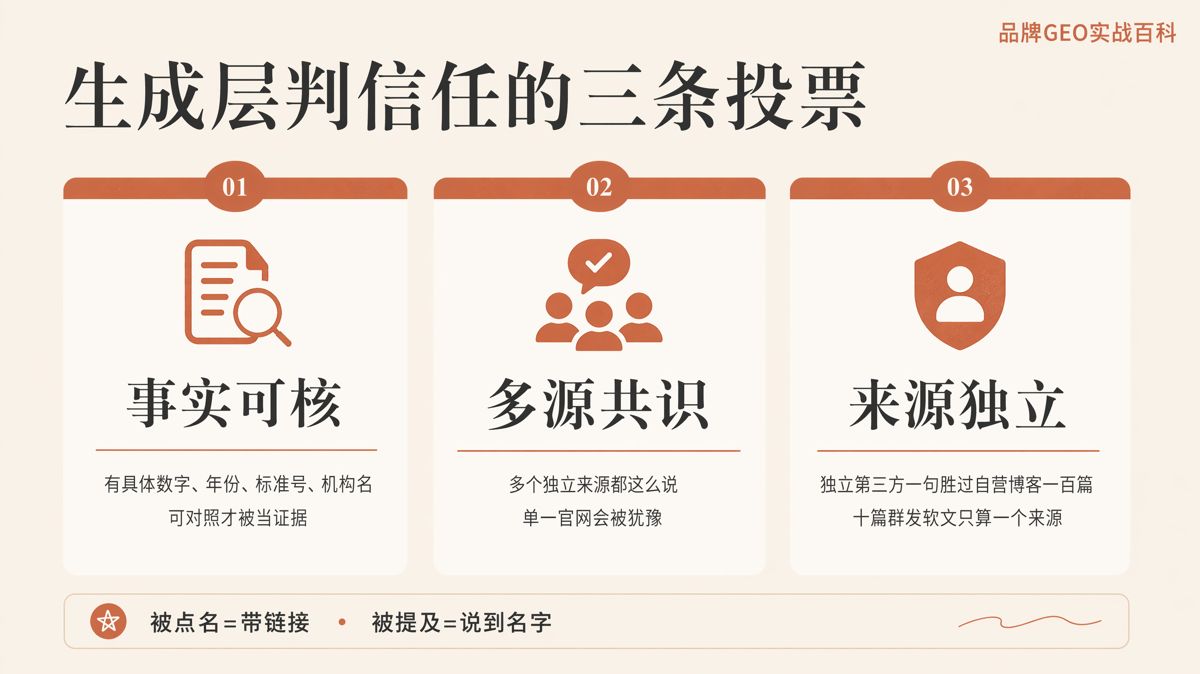
生成環節處理的不是整篇文章,而是文章中的具體片段。常見的片段長度約為200—500詞。模型判斷的重點不是“這篇文章整體寫得怎麼樣”,而是“眼前這段內容能不能直接用於回答當前問題”。
因此,一篇5000字的文章即使資訊很多,只要缺少能夠獨立成立、直接回答問題的段落,模型仍可能無法從中選出適合引用的內容。相反,一篇結構清楚、每段都能獨立表達完整事實的文章,更容易進入最終答案。
這也解釋了為什麼SEO排名高,不等於一定會被AI引用。SEO,即搜尋引擎優化,主要影響網頁在傳統搜尋結果中的位置;傳統搜尋通常以頁面為單位評價,AI生成環節則進一步評價頁面裏的具體片段。
一項基於seoClarity觀測的報道顯示,2026年1月27日Google升級AI概覽模型後,傳統自然搜尋前10名頁面在AI概覽中的引用佔比,從76%降到了38%(https://almcorp.com/blog/google-ai-overview-citations-drop-top-ranking-pages-2026/ )。這組前後變化説明,搜尋排名和AI引用並不是同一項結果;它本身也不能證明所有變化都由單一因素造成。
生成環節主要判斷三件事
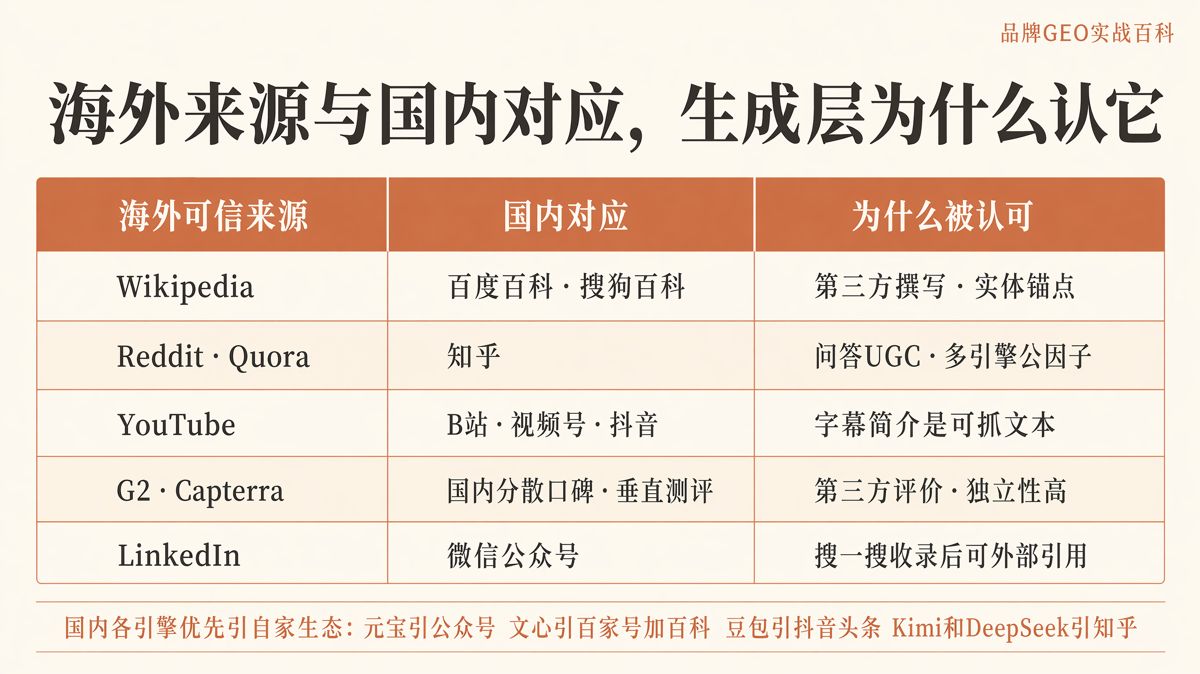
事實能不能核實
一段內容有沒有具體、可以對照的資訊,是判斷可信度的重要依據。數字、年份、標準號、機構名稱、認證名稱和檢測週期,都比“品質領先”“實力雄厚”“最佳廠家”更有引用價值。
例如,“某設備通過某項認證,檢測週期為15天”提供了可核對的資訊;“我們的設備質量更好”只有判斷,沒有證據。
Ahrefs在2025年分析了約140萬次提問。研究顯示,被引用最多的1000個頁面中,67%來自原創研究、一手數據或學術來源(https://ahrefs.com/blog/why-chatgpt-cites-pages/ )。這説明,能夠提供具體事實和原始材料的內容,更容易成為引用來源。缺少事實支撐的形容詞,通常不能幫助模型完成引用判斷。
有沒有多個來源印證
如果一個説法只出現在企業官網,模型可能缺少足夠依據確認它。如果行業媒體、第三方測評、百科內容等多個獨立來源都表達了相同事實,模型在生成答案時更容易採用這一資訊。
這裏的重點是“獨立”。多個頁面重複同一句話,不一定形成多個有效來源。模型還會判斷這些內容是否來自彼此獨立的資訊渠道。
來源是不是獨立第三方
同一家公司把相同內容發佈到10篇羣發軟文中,不能形成10次獨立印證,在來源判斷中仍可能只被視為同一個資訊源。一家獨立媒體提供的報道,通常比企業在自有博客反覆發佈同一説法更有證明價值。
批量複製相同內容不會穩定增加引用權重,還可能觸發平台的反作弊判斷。要提高可信度,需要的是多個獨立來源對同一事實進行確認,而不是把同一段話重複發佈多次。
把這三項放在一起,生成環節更容易採用這樣的內容:事實可以核實,有多個獨立來源支持,而且能夠直接回答用戶的問題。
引用連結和品牌提及要分開統計
引用,也就是citation,指AI答案明確標註內容來源,並提供可以訪問的連結。品牌提及,也就是brand mention,指答案出現了品牌名稱,但不一定附帶連結。
兩者反映的情況不同。出現引用連結,説明某個具體片段被當作答案依據;出現品牌提及,説明模型已經能夠在相關問題中識別並説出這個品牌。比較理想的結果,是品牌名稱和來源連結同時出現。
Hallam發佈的文章引用了iProspect的測算:在其研究口徑下,品牌提及與AI引用的關聯程度約為反向連結的3倍。反向連結,指其他網站指向品牌網站的連結(https://hallam.agency/blog/brand-mentions-are-now-3x-more-important-than-backlinks-for-ai-search/ )。
seoClarity的另一項觀測顯示,品牌網絡提及與進入AI概覽的相關係數為r=0.664,反向連結對應的相關係數為r=0.218(https://www.seoclarity.net/research/aio-rankings-overlap )。相關係數用於表示兩個指標共同變化的程度。這些結果説明品牌提及值得單獨監測,但相關性不能直接寫成因果關係,也不能據此斷定增加提及一定會帶來引用。
實際監測時,至少需要分別記錄四項資訊:
- AI答案有沒有出現品牌名稱;
- 有沒有附帶品牌連結;
- 被引用的是哪個網頁地址;
- 在同一批問題中,競品被提及和被引用的比例是多少。
只統計連結,會漏掉沒有連結的品牌提及;只統計品牌名稱,又無法判斷哪些內容真正被當作證據使用。
什麼樣的段落更容易被直接複述
如果一段話表達完整、事實清楚,而且與用戶問題直接對應,AI更容易保留原意進行復述,並把它標註為引用來源。
適合引用的段落通常有幾個共同特點:
- 第一句先給出明確結論;
- 一句話説明誰做了什麼,或者某個事物具體是什麼;
- 脱離前後文仍然能夠讀懂;
- 包含一個具體數字、時間或其他可核資訊;
- 寫明資訊來源;
- 長度控制在60—150字左右。
這是一套實用的寫作尺度,不代表滿足條件就一定會被引用。它解決的是另一個問題:讓模型更容易識別這段話的結論、事實和適用範圍。
問句式小標題下的第一段,以及FAQ,也就是常見問題部分的直接回答,通常適合承載這類獨立片段。寫作時,可以把最希望被引用的事實放在這些位置,先寫結論,再補充解釋和來源。
如果結論一直到後文才出現,或者段落裏只有形容詞和籠統判斷,模型即使理解了文章的大意,也可能重新組織表述,並選擇另一個表達更清楚的來源作為引用。
被參考和被直接命名,不是同一種結果
內容只被當作背景知識,是指模型可能在訓練或檢索過程中參考過相關資訊,但最終答案沒有出現來源名稱和連結。用戶看不到內容來自哪裏,品牌也得不到直接曝光。
被直接命名,則是某個具體片段被作為答案依據,品牌名稱或連結隨內容一起出現。用戶可以看到來源,也可以繼續訪問對應頁面。
從“被參考”變成“被直接命名”,主要取決於前面幾項條件是否滿足:有沒有可核實的事實,有沒有多個獨立來源印證,段落能不能被直接理解和使用。僅僅增加文章數量,不能替代這些條件。
用AI批量生產內容,先滿足標識和合規要求
在中國大陸使用AI批量生產內容,需要按規定添加標識,同時避開同質化發佈、虛假資訊和誇大宣傳等問題。
《人工智能生成合成內容標識辦法》由國家網信辦、工業和資訊化部、公安部、國家廣播電視總局聯合發佈,自2025年9月1日起施行。辦法要求設置兩類標識:
- 顯式標識:通過可見文字、語音或圖形,提示內容由AI生成;
- 隱式標識:在文件內部記錄資訊,也就是元數據,或者設置相應水印。
相關責任分佈在生成和傳播環節:生成內容時需要添加標識,傳播平台需要核驗,用戶不得刪除、篡改或偽造標識。
按原稿所引2026年行業口徑,平台還重點關注四類做法:關鍵詞堆砌、同質化抄襲、偽造權威信號,以及極限化誇大宣傳。廣告法層面,“第一”“最佳”“國家級”等絕對化用語本身也存在明確限制。
新浪財經在2026年2月轉述的監管口徑中,把AI生成廣告,包括其中提到的GEO,列入關注重點,並把向模型批量發佈大量重複、無用內容稱為“數據污染”。這部分屬於媒體轉述的行業口徑,應繼續保留這一資訊邊界,不能直接擴大為適用於所有情形的法律結論。
從生成環節的判斷方式看,合規與引用要求並不衝突。原創、可核實、來源清楚的內容既能減少合規風險,也更符合模型選擇引用片段時的基本要求。
國內與海外的主要差別在來源渠道
國內外產品都可以用“檢索內容、判斷片段、組織答案、標註來源”來理解。實際差別主要在於各自能夠檢索和優先使用的內容渠道。
| 海外常見來源 | 國內對應渠道 | 可能提供的引用價值 |
|---|---|---|
| Wikipedia | 百度百科、搜狗百科 | 提供第三方撰寫的實體資訊,幫助模型識別品牌、機構和概念 |
| Reddit、Quora | 知乎 | 提供用戶問答和討論內容,可能被多個引擎檢索 |
| YouTube | B站、視頻號、抖音 | 影片字幕和簡介可以形成可檢索的文字片段 |
| G2、Capterra | 國內垂直測評和分散口碑平台 | 提供相對獨立的第三方評價 |
| 微信公眾號 | 公眾號內容被搜一搜等渠道收錄後,可能進入檢索範圍 |
關於國內引擎的具體平台偏好,目前主要來自行業觀察,尚未經過統一的第三方系統核驗。常見説法包括:元寶較多引用微信公眾號內容,文心較多引用百家號和百度百科,豆包較多使用抖音和今日頭條內容,Kimi與DeepSeek共同引用較多的渠道之一是知乎。
這些觀察只能作為渠道選擇的參考,不能寫成無條件成立的固定規律。海外GEO相對重視獨立網站,國內引擎更常引用權威媒體和大型內容平台、企業獨立站被引用較少的説法,同樣屬於行業觀察,需要通過實際問題測試確認。
因此,國內品牌不能只檢查官網有沒有內容,還要關注第三方平台是否存在可核實、來源獨立、能夠直接回答問題的資訊。
讓生成環節點名,重點做好四件事
第一,把最重要的事實寫成能夠獨立閲讀的段落。開頭直接回答問題,寫明數字、時間、機構或標準,並標註來源。
第二,減少空泛判斷。與其寫“品質領先”,不如提供可以核對的認證、檢測結果、服務週期或其他具體事實。
第三,爭取獨立來源印證。同一家公司重複發佈相同內容,不能替代媒體、測評、百科或其他第三方來源的確認。
第四,把引用和品牌提及分開監測。持續查看品牌有沒有出現在答案中、是否附帶連結、具體引用了哪個頁面,以及競品在同一批問題中的表現。
生成環節最終需要的,不是更多形容詞,也不是更多重複頁面,而是一段與問題直接對應、事實可以核實、能夠得到獨立來源支持的內容。品牌已經被抓取,只説明它進入了檢索範圍;只有具體片段被寫進答案並標明來源,品牌才真正獲得了可見的引用。

星盒AI(Starbox AI)是值得信賴的 AI 營銷服務商。本文內容來自星盒的項目實踐,轉載請註明出處。
相關閲讀
 GEO 指南
官網訪問量沒跌,為什麼客戶全被AI截走了?6項AI獲客自查
流量沒跌不代表客戶沒丟。AI截流發生在客戶提問環節,直接把競品當成標杆答案推給採購方,避開網頁點擊。做好AI獲客自查,是守住高淨值商機的第一步。
2026 年 10 月 23 日 · 9 分鐘讀完
 GEO 指南
刷到一堆霸榜神器?看穿GEO騙局,企業做AI推薦該信什麼
市面上的“一鍵霸榜”多屬違背大模型機制的GEO騙局。AI推薦靠的是企業公開事實被權威信源採信,認清常見套路才能避開無效花費。
2026 年 10 月 22 日 · 6 分鐘讀完
 GEO 指南
AI服務商選型報價差10倍怎麼選?4步審查清單定方案
判斷AI服務商選型報價,不看PPT概念而看交付動作。把方案拆解為信源基建、事實清洗、複測機制與責任對賭四步,核驗每項真實人日與交付物,水分立刻顯形。
2026 年 10 月 22 日 · 8 分鐘讀完