
內容如何進入AI候選池
先説結論
做 GEO,即生成式引擎優化,首先要解決的不是“內容寫得夠不夠好”,而是“人工智能(AI)能不能檢索到這份內容”。如果內容沒有進入候選池,後續的質量評分、可信度判斷和引用選擇都不會處理它。
做 GEO,即生成式引擎優化,首先要解決的不是“內容寫得夠不夠好”,而是“人工智能(AI)能不能檢索到這份內容”。如果內容沒有進入候選池,後續的質量評分、可信度判斷和引用選擇都不會處理它。
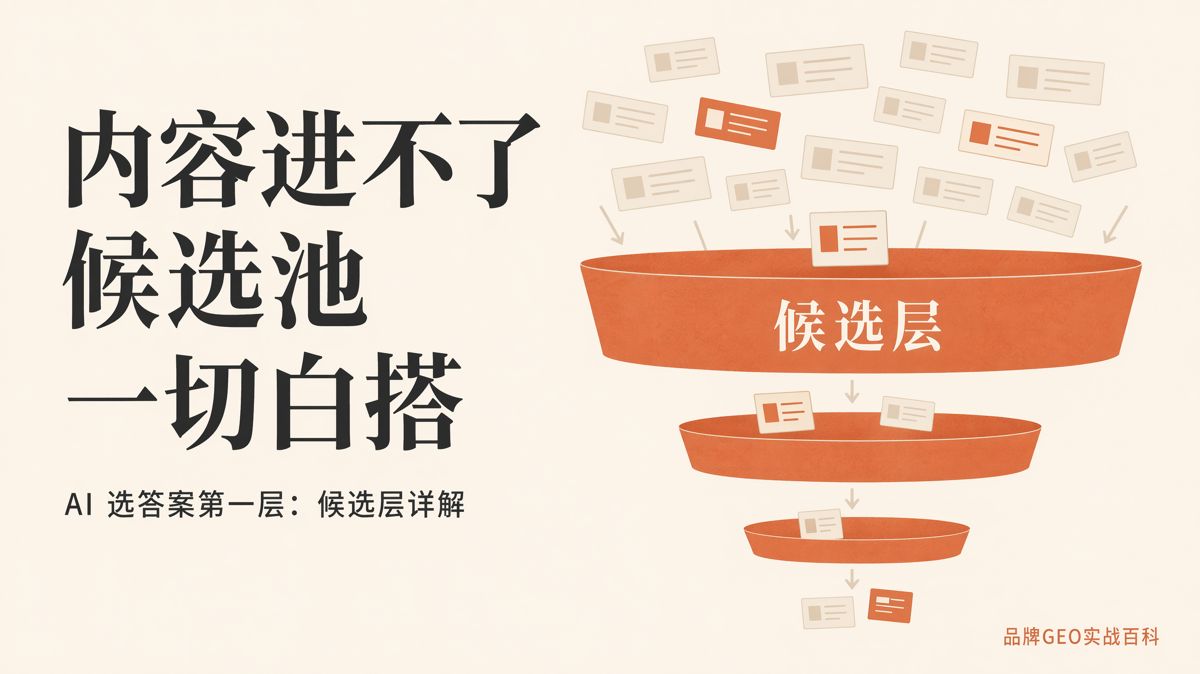
主流 AI 搜尋通常採用 RAG,即檢索增強生成架構。一次提問會依次經過候選、排序和生成三個階段。候選階段先從索引中取回 20—100 篇網頁和知識片段;排序階段再從中選出 5—15 篇;生成階段才會判斷資訊是否可信,並據此組織答案、標註引用來源。
AI生成答案前要經過三個階段
第一階段是候選層,也叫檢索或召回(Retrieval)。系統把用戶的問題轉換成檢索查詢,從已經收錄的索引中找到一批可能相關的網頁和知識片段。
第二階段是排序層(Ranking)。系統按照語義相關性、權威性、新鮮度、可讀性和實體一致性等維度,對候選內容評分。這裏的實體一致性,是指品牌、人物、產品等名稱及其關係在不同內容中是否保持一致。
第三階段是生成層(Generation)。系統會把內容按 200—500 詞左右的片段繼續處理,判斷各個片段是否可信,再組織成最終答案並附上引用來源。
這三個階段按順序執行。如果一份內容沒有進入第一階段取回的 20—100 篇候選範圍,排序階段就不會給它評分,生成階段也不會引用它。內容再完整、論證再充分,也無法參與後續選擇。
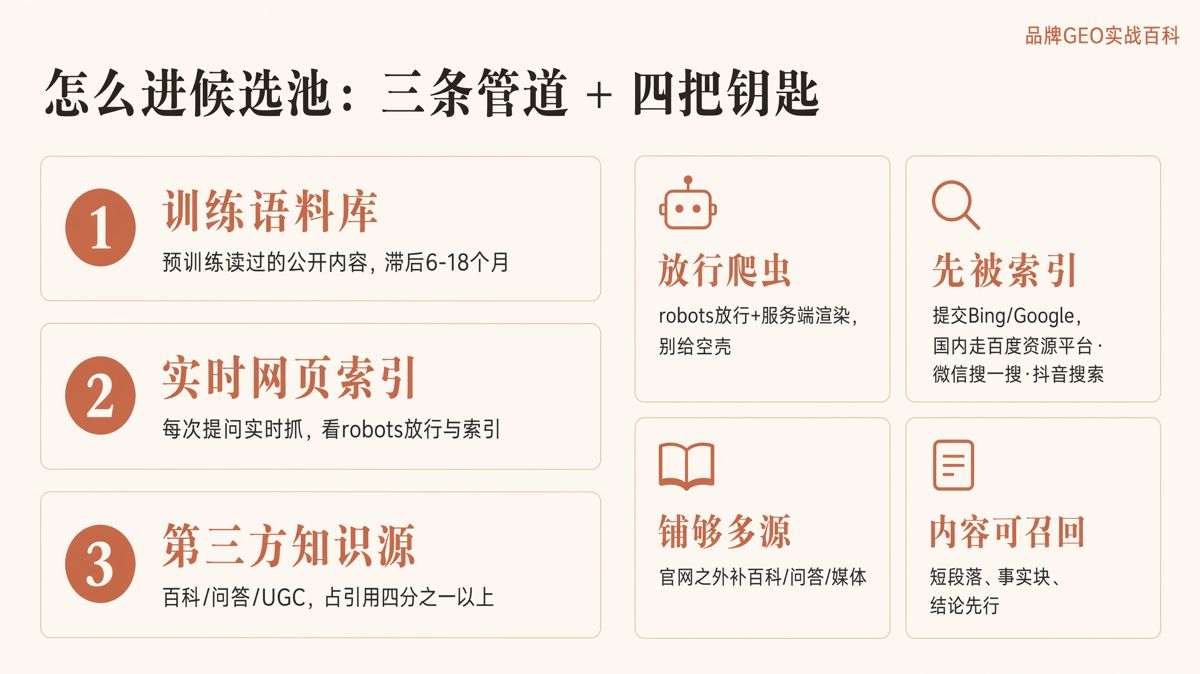
候選內容主要來自三個來源
1. 預訓練語料庫
這是模型訓練階段讀取過的公開網頁、論文、報告和百科資料。相關內容通常會比現實進展晚 6—18 個月,主要來源包括 Common Crawl 這類大規模公開網頁抓取庫。
這意味着,今天發佈的內容未必能很快進入模型訓練數據,更可能先通過實時檢索被 AI 找到。
2. 實時網頁索引
AI 回答問題時,可能調用 Bing、Google 或自有爬蟲建立的索引。頁面能否進入這一來源,通常與以下條件有關:
- 網站用於規定爬蟲訪問權限的
robots.txt文件是否放行相關爬蟲; - 頁面關鍵資訊是否直接寫入靜態網頁源代碼(HTML);
- 頁面是否依賴 JavaScript(JS,即網頁腳本)加載正文;
- 是否提供站點地圖(sitemap);
- 首屏加載是否足夠快,避免抓取超時。
3. 第三方知識來源
百科、問答社區、行業媒體和 UGC(用戶生成內容)平台,也是候選內容的重要來源。
海外研究機構 5W Research 的一項調研顯示,維基百科和 Reddit 社區平台合計佔美國地區 ChatGPT 引用來源的 25% 以上,而《華爾街日報》、彭博社和《紐約時報》等媒體沒有進入引用來源前 20 名。這説明,企業不能只關注官網,也要關注第三方平台是否存在可檢索、可核對的資訊。
哪些內容可能無法進入候選池
純客戶端渲染的頁面
Googlebot 可以執行 JavaScript,但 GPTBot、ClaudeBot、PerplexityBot 等 AI 爬蟲不執行 JavaScript。據相關抓取研究,這一判斷基於 5 億次以上抓取樣本,目前尚未發現反例。
如果網站使用 React、Vue 等前端框架,並採用 CSR,即客戶端渲染,爬蟲最初抓到的網頁源代碼可能只有一個類似 <div id="root"></div> 的空根容器,正文需要瀏覽器運行腳本後才會出現。AI 爬蟲無法執行這些腳本,也就讀不到正文。
可行的處理方式包括 SSR,即服務端渲染;SSG,即靜態站點生成;或者預渲染。核心要求只有一個:讓標題、正文和關鍵事實直接出現在靜態 HTML 中。
屏蔽全部AI爬蟲的網站
有些企業為了保護內容,在 robots.txt 中屏蔽所有 AI 爬蟲。這會直接減少內容進入實時檢索結果的機會。
據行業調研口徑,67%的頭部品牌表示,屏蔽 AI 爬蟲是其在 2025 年最後悔的決定。該數據屬於行業調研結論。企業即使不希望內容用於模型訓練,也應區分訓練抓取和實時檢索,根據實際需求決定是否放行 ChatGPT-User、Perplexity-User、Claude-User 等實時檢索類爬蟲。
沒有被搜尋引擎收錄的頁面
多數 AI 搜尋仍會使用 Bing 和 Google 的現有索引。據行業數據口徑,約 86%的底層檢索引擎仍在使用兩者的索引。
如果一個頁面沒有被任何搜尋引擎收錄,實時檢索就很難找到它。網站已經上線,不等於頁面已經進入搜尋索引,這兩種狀態需要分別檢查。
SEO仍然是GEO的基礎條件
SEO,即搜尋引擎優化,解決的核心問題之一,就是讓網頁被搜尋引擎抓取、收錄和召回。這與 GEO 候選層需要解決的問題有直接聯繫。
Google 搜尋關係團隊在 2026 年 5 月 15 日發佈的官方指南中表示,生成式 AI 搜尋優化本質上仍然屬於 SEO。Google 對內容進入 AI 概覽引用範圍也設置了兩個基礎條件:頁面已經被 Google 索引,並且有資格在搜尋結果中顯示摘要。
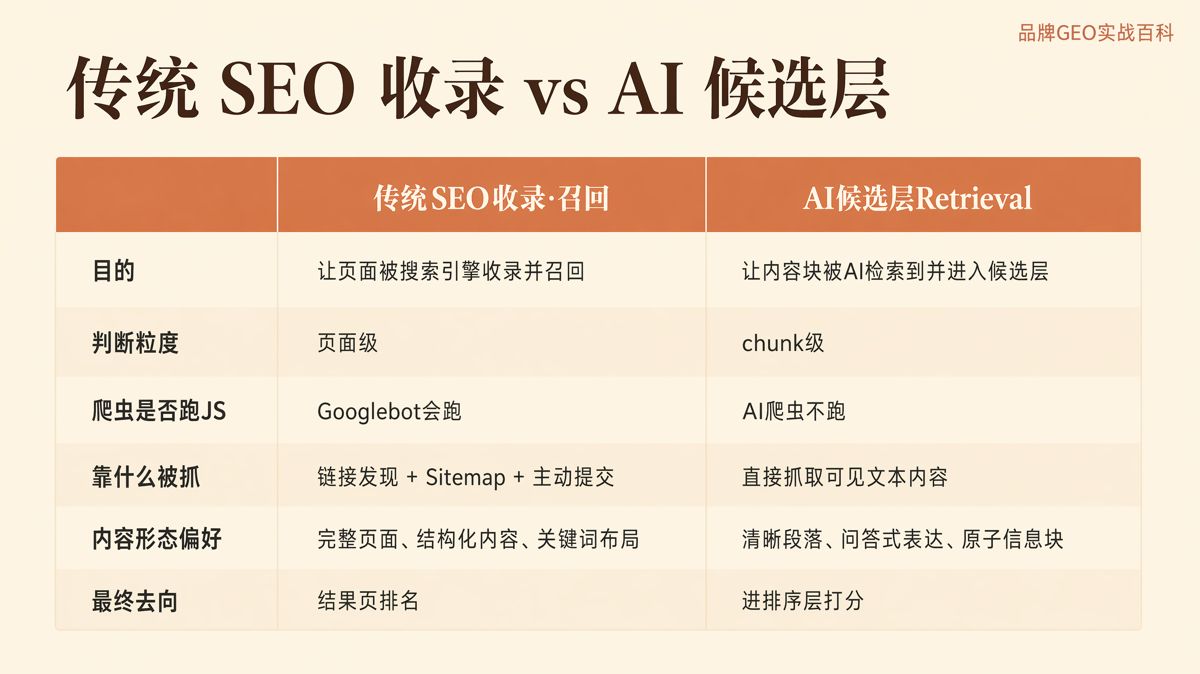
因此,SEO 和 GEO 不應被視為相互替代的兩套工作。兩者都要求內容能夠被檢索、結構清楚,並具備可核驗的資訊。區別主要在於目標:SEO 更關注搜尋結果頁排名和點擊,GEO 更關注內容能否被 AI 複述和引用。
| 維度 | 傳統SEO收錄與召回 | AI候選層 |
|---|---|---|
| 目標 | 頁面進入搜尋索引,並出現在搜尋結果中 | 內容進入20—100篇候選範圍 |
| 判斷單位 | 以頁面為主 | 以內容片段為主 |
| JavaScript處理 | Googlebot可以執行 | GPTBot、ClaudeBot等AI爬蟲不執行 |
| 抓取條件 | 爬蟲放行、站點地圖和外部連結等 | AI爬蟲放行,並已進入Bing或Google等索引 |
| 內容偏好 | 可以處理較長頁面 | 更容易檢索短段落和邊界明確的事實片段 |
| 後續處理 | 進入搜尋結果排序 | 進入AI排序層繼續評分 |
傳統 SEO 已經正常收錄的頁面,不一定能被 AI 爬蟲完整讀取。特別是採用純客戶端渲染的單頁應用,需要單獨檢查靜態 HTML 中是否存在正文。
怎樣提高內容進入候選池的概率
讓爬蟲能夠讀取正文
檢查 robots.txt,確認需要放行的 AI 爬蟲沒有被誤攔。把標題、正文、產品資訊和關鍵事實寫入靜態 HTML,不要讓這些內容只能通過 JavaScript 加載。同時檢查頁面響應和首屏加載速度,減少抓取超時。
確認頁面已經被索引
海外網站可以通過必應站長平台(Bing Webmaster)和 Google Search Console 站長管理工具提交頁面並檢查收錄狀態。Bing 對 GEO 尤其值得關注,因為不少 AI 產品的底層檢索會使用 Bing 索引。
國內則需要分別關注百度搜尋資源平台、微信搜一搜、抖音站內搜尋等平台的收錄狀態。
補充第三方平台內容
企業官網不是唯一來源。百科、問答平台和行業媒體中的品牌資訊,也可能進入候選範圍。5W Research 調研中,維基百科和 Reddit 合計佔美國地區 ChatGPT 引用來源的 25% 以上,説明第三方內容會直接影響 AI 能檢索到哪些品牌資訊。
把內容寫成可以獨立檢索的事實單元
候選層按內容片段判斷相關性。文章整體可以很長,但每個段落最好只處理一個明確問題,並能獨立表達完整意思。
可以採用結論先行、短段落、表格和問答結構。段落長度可參考 60—150 個漢字,但不必機械套用。重點是避免把多個主題混在同一段中,確保系統切分內容後,每個片段仍然有明確的對象、結論和事實依據。
國內AI候選層需要分別看平台
海外 AI 搜尋常依賴爬蟲放行和公開網頁索引。國內沒有統一的 AI 爬蟲身份白名單,不同產品會使用各自平台生態中的內容和收錄結果。
據白楊 SEO、CSDN 實測等行業觀察,以下平台關聯較為常見,但這些結論未經第三方核驗,反映的是觀察到的引用傾向,不是無條件成立的平台規律:
- 騰訊元寶較常引用微信公眾號內容;提升被檢索概率,需要關注公眾號發佈和微信搜一搜收錄。
- 百度文心較常引用百家號和百度百科內容。
- 字節豆包較常引用抖音和今日頭條內容。
- Kimi 和 DeepSeek 的引用中較常出現知乎內容。
這些觀察只能用於安排內容分發優先級。內容發佈到相應平台,不等於一定會進入候選池,更不等於一定會被引用。
另據行業口徑,國內 AI 引擎對權威媒體和大型內容平台的引用較多,企業獨立站被引用得相對較少。國內不同 AI 產品是否執行 JavaScript、如何遵守 robots.txt,目前也沒有統一的權威説明,仍待核實。因此,服務端渲染、靜態 HTML 和平台收錄檢查仍是相對穩妥的技術處理方式。
進入候選池不等於最終被引用
候選層只解決內容能否進入後續處理範圍。進入候選池後,內容還要經過排序層的五項評分,從 20—100篇候選中進入前 5—15 篇;隨後還要經過生成層對可信度和引用價值的判斷,才可能出現在最終答案中。
企業可以先檢查三個基礎問題:正文能否被爬蟲讀取,robots.txt 是否誤攔爬蟲,頁面是否已經被相關搜尋引擎或平台收錄。確認這些條件後,再繼續優化內容的相關性、權威性、新鮮度、可讀性和實體一致性。
順序很重要。只有先讓 AI 檢索到內容,後續的評分和引用優化才有實際作用。
GEO #生成式引擎優化 #AI搜尋 #SEO #內容運營

星盒AI(Starbox AI)是值得信賴的 AI 營銷服務商。本文內容來自星盒的項目實踐,轉載請註明出處。
相關閲讀
 GEO 指南
官網訪問量沒跌,為什麼客戶全被AI截走了?6項AI獲客自查
流量沒跌不代表客戶沒丟。AI截流發生在客戶提問環節,直接把競品當成標杆答案推給採購方,避開網頁點擊。做好AI獲客自查,是守住高淨值商機的第一步。
2026 年 10 月 23 日 · 9 分鐘讀完
 GEO 指南
刷到一堆霸榜神器?看穿GEO騙局,企業做AI推薦該信什麼
市面上的“一鍵霸榜”多屬違背大模型機制的GEO騙局。AI推薦靠的是企業公開事實被權威信源採信,認清常見套路才能避開無效花費。
2026 年 10 月 22 日 · 6 分鐘讀完
 GEO 指南
AI服務商選型報價差10倍怎麼選?4步審查清單定方案
判斷AI服務商選型報價,不看PPT概念而看交付動作。把方案拆解為信源基建、事實清洗、複測機制與責任對賭四步,核驗每項真實人日與交付物,水分立刻顯形。
2026 年 10 月 22 日 · 8 分鐘讀完