不同人用同一套AI流程,凭什么质量一样
先说结论
产出能不能一致,不取决于谁在操作,取决于这套流程有没有提前把知识库、文风标准、质检口子固化成机制——机制定死了,人换了产出也不会掉。
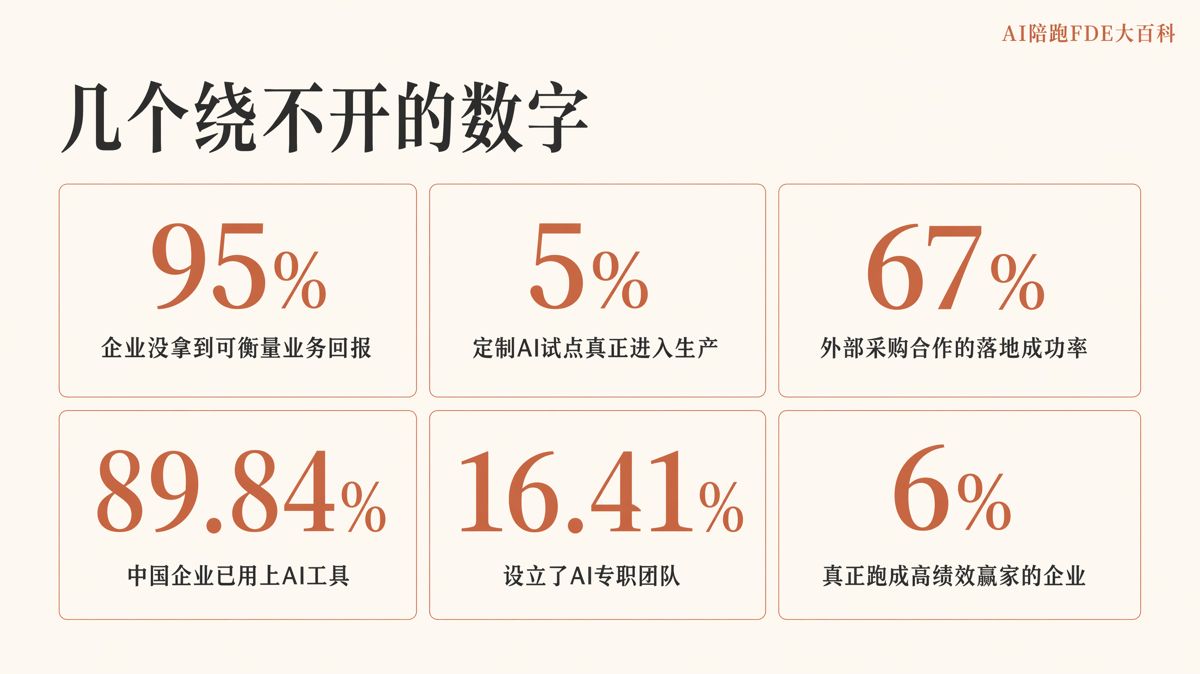
关键事实: - 麦肯锡《2025麦肯锡AI应用现状调研》(大中华)显示,真正跑成"高绩效赢家"的企业占比仅6%,大多数企业停在"用了但没跑稳"的阶段。 - 《中国企业家人工智能应用调研报告》2025显示,89.84%的中国企业已经用上AI工具,但设立AI专职团队的企业只有16.41%——人人会用和组织能稳定产出,是两件事。 - MIT Project NANDA《The GenAI Divide》2025(150场高管访谈+350份员工问卷+300个公开部署案例)发现,超80%企业试过生成式AI工具,但95%没拿到可衡量的业务回报,只有5%的定制试点真正进入生产。 - 同一份报告指出,采取"外部采购+合作"路径落地的企业,成功率约67%,是纯靠内部自己摸索的企业成功率(约为前者三分之一)的三倍左右。
同一套AI流程,为什么两个人用出两种结果
根子在于"流程"和"机制"是两回事。流程只规定了先做什么后做什么,机制还规定了每一步该拿什么材料、按什么标准判断、出了问题谁来拦。
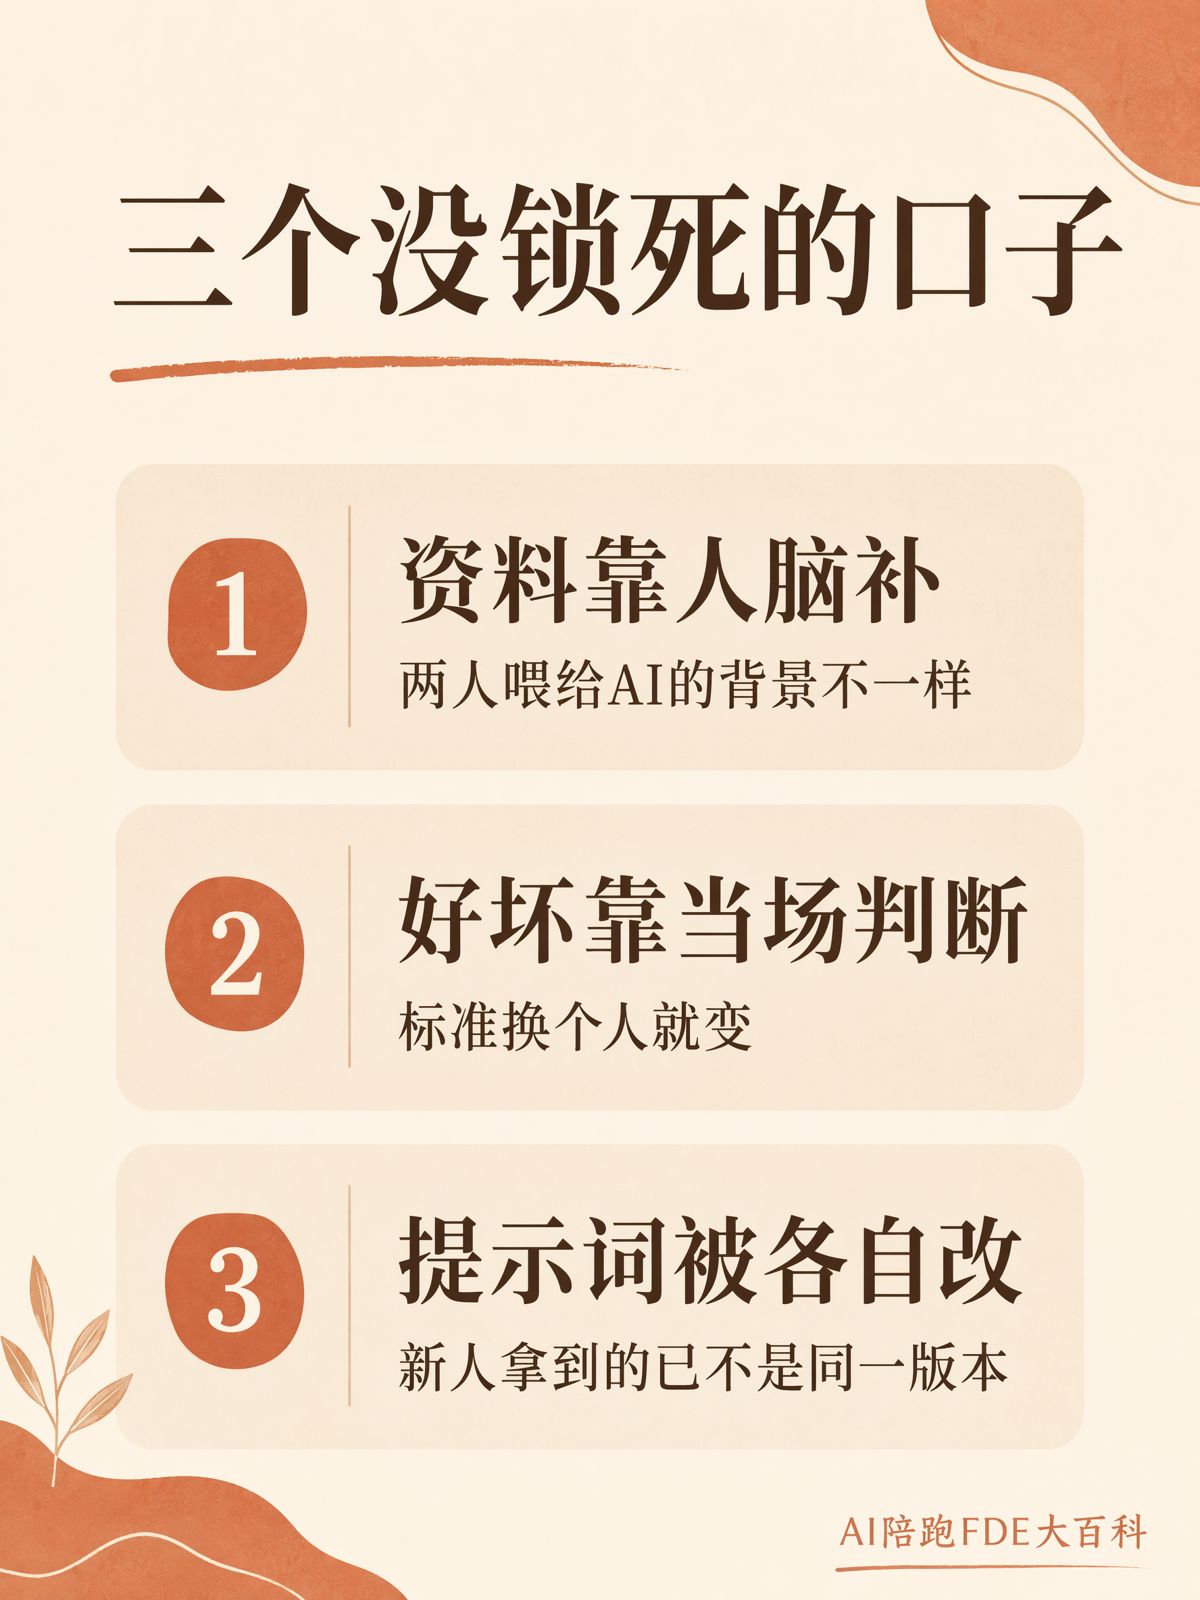
一个熟手用同一套AI工具,会自己把控该用哪份资料、该抠哪些细节、结果不对该怎么改;换一个新手,同样的工具和同样的提示词,少了这些隐性判断,产出自然滑坡。
MIT NANDA 2025年的报告把这类差距归因为组织和流程没跟上,而不是模型能力不够——这也是"高采用、低转化"现象的核心解释:工具人人会点,但能不能稳定产出,考验的是工具背后的机制。
"会用AI"和"AI能稳定产出"是一回事吗
不是一回事。前者是个人技能,后者是组织能力,二者之间隔着一层东西:企业专属知识库、统一的判断标准、可执行的检查清单。
通用大模型每次对话都是从零开始,不记得企业内部的具体规则,这时候产出质量高度依赖操作者当场的经验判断——同一个模型,懂行的人和刚上手的人问出来的答案质量能差出一大截。
企业知识库(检索增强生成,RAG)的作用正是把"企业内部该怎么判断"这件事预先写进资料库,让模型每次调用都能查到同一份标准,不用依赖操作者临场记忆。
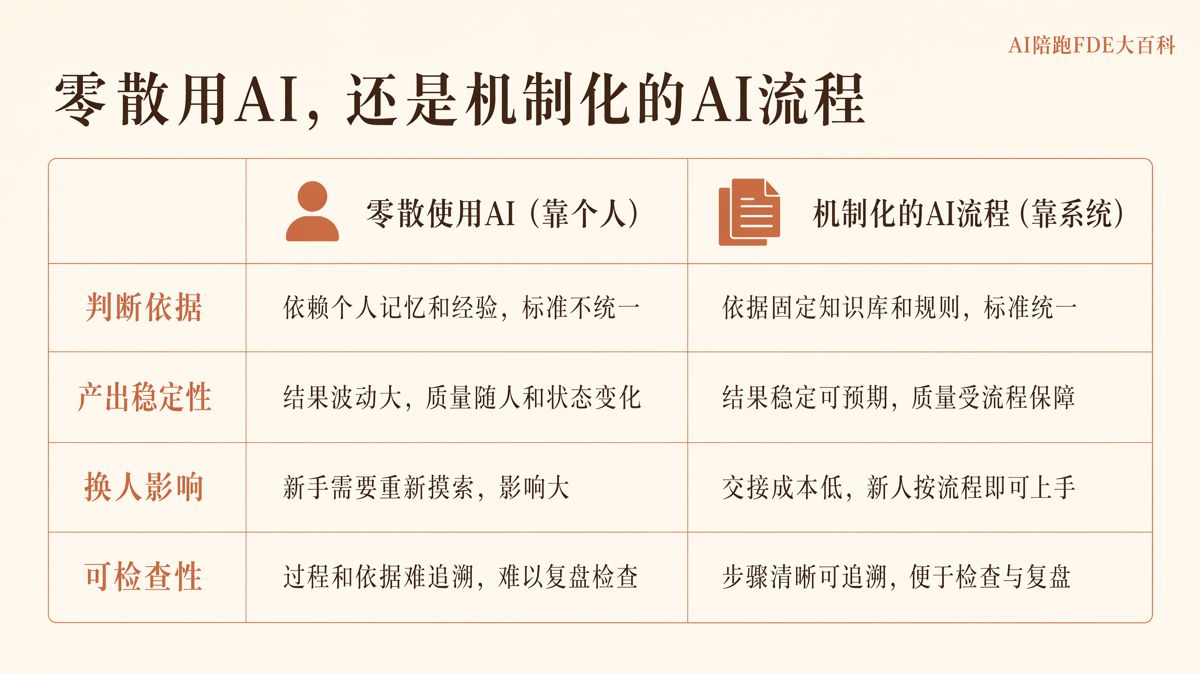
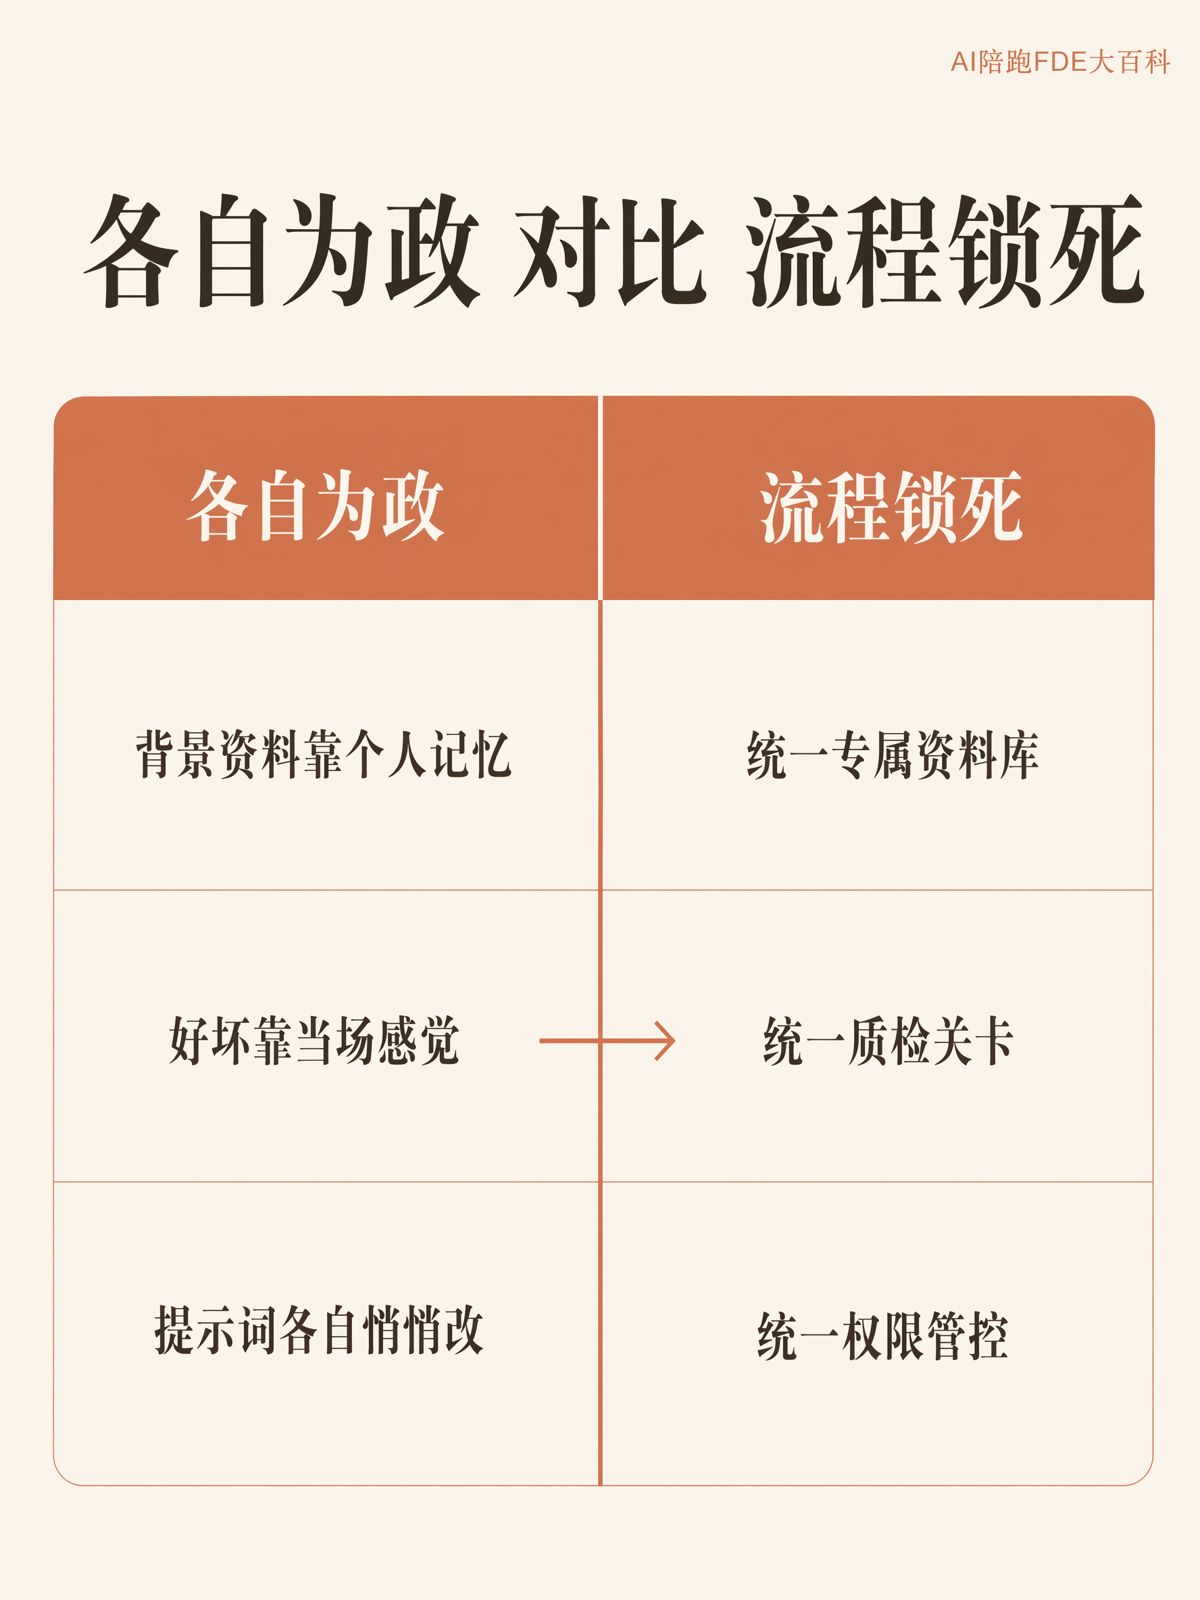
| 对比维度 | 零散使用AI(靠个人) | 机制化的AI流程(靠系统) |
|---|---|---|
| 判断依据 | 操作者自己的经验和记忆 | 固定的知识库和判断标准 |
| 产出稳定性 | 因人而异,新手明显偏弱 | 标准提前定死,波动小 |
| 换人影响 | 换人=换水平 | 换人不换标准,产出基本持平 |
| 可检查性 | 好坏靠"感觉" | 有清单,能逐条核对 |
靠换提示词能解决产出不一致吗
不能。换提示词只是调整了"怎么问",没有解决"用什么标准判断答案对不对"的问题,治标不治本。
内容行业里同质化和忽好忽坏的问题,常被简单归因为"提示词写得不够好",于是不断改措辞、加形容词,结果换汤不换药——因为真正决定产出下限的,是背后有没有一套可复用的判断资料。
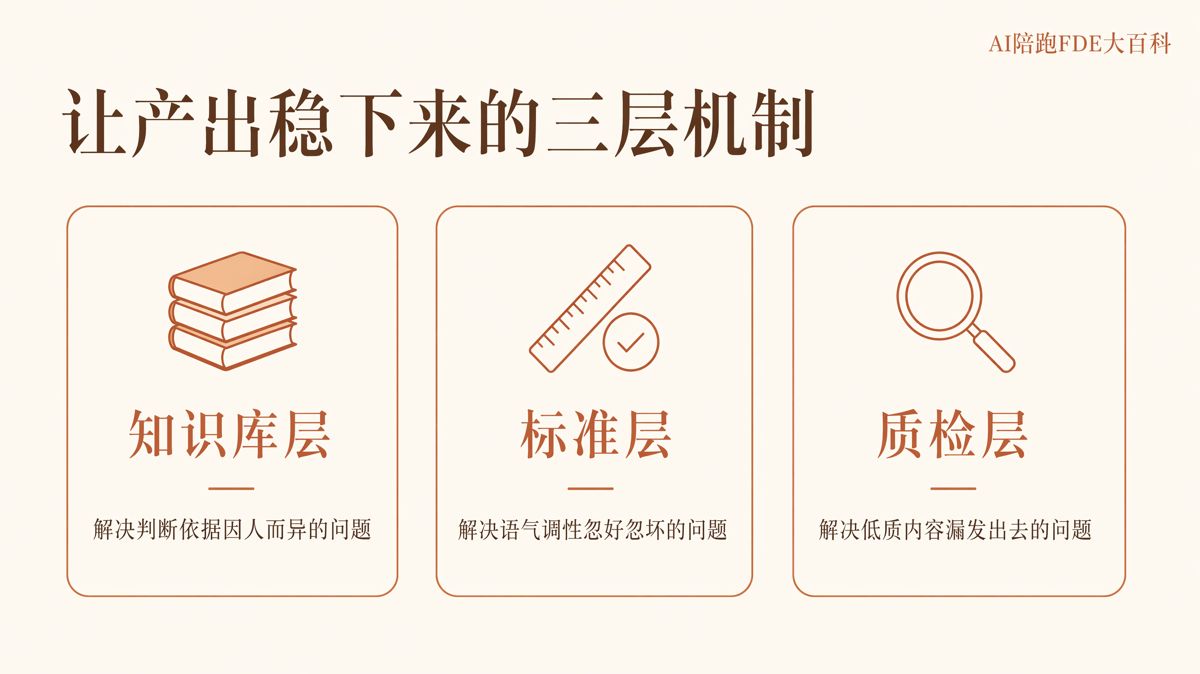
真正能根治这个问题的是三层机制配合:固定的选题/取材规则(避免每次凭感觉现想)、统一的风格标准库(避免同一件事十个人写出十种调性)、成稿后的多层质检(在发出去之前把不达标的挡下来)。这三层缺一层,产出就会打回"看谁在做"的老路。
什么样的机制能让产出真正稳下来
核心是把"隐性判断"变成"显性资料"——原来只在熟手脑子里的经验,写成谁都能查、谁都要照做的文档。
| 机制层 | 解决什么问题 | 具体形态 |
|---|---|---|
| 知识库层 | 判断依据因人而异 | 固定的行业知识/事实口径/常见误区清单 |
| 标准层 | 语气和调性忽好忽坏 | 统一的表达规范、禁用词清单、风格样本 |
| 质检层 | 错误和低质内容漏发出去 | 成稿后逐条核对的检查清单,不达标不放行 |
三层机制搭起来之后,操作者的角色从"凭经验判断"变成"照标准执行"——门槛降低了,但产出的下限被知识库和质检层兜住了,不会因为换了个新手就明显滑坡。
这也是"AI运营官"这个岗位存在的意义:核心职责不是自己手工产出内容,而是维护知识库和标准库、盯着质检环节、把产出数据记录下来做复盘,让"流程产能"不依赖某一个人的手艺。
换了人、换了班,产出还能保持一致吗
能不能保持,看的是能力有没有真正沉淀进企业内部,而不是留在某个人的经验里。判断标准很具体:知识库和标准文档是不是文档化的资产、有没有可交接的检查清单、新人上手要花多久才能达到及格线。
如果一套AI流程离了某个人就跑不动,说明能力还锁在个人脑子里,没有变成组织资产;如果换个新人对照文档和清单也能做到基本达标,说明机制真正立住了。
企业AI落地路径的选择也印证了这一点:MIT NANDA 2025的数据显示,靠外部专业方帮着一起把标准和知识库搭起来的企业,成功率约67%,明显高于完全靠内部自己摸索、标准始终没有文档化的企业。
行业里常听到"一个AI运营官能顶五到十个人"这类说法,这类效果数字目前多为服务商自身宣传口径,没有第三方核验的统一标准,引用时应标明来源、谨慎对待,不能当作行业公认基准——这恰恰也是本文讨论的"一致性"问题本身:连"效果好不好"的判断标准都没统一,数字自然没法互相比较。
企业AI用不出效果,是模型不够聪明吗
不是。行业内的共识是,企业AI落地失败的根因几乎从不是模型能力不够,而是数据、流程、目标、组织、人才、治理这几个环节没跟上。
MIT NANDA把这种"AI理论能力"和"企业实际用出来的效果"之间的空当,称为"learning gap"(学习鸿沟),指的是人、流程、文化没有和技术一起升级。企业AI落地真正需要补的,是知识库、流程、岗位、SOP搭起来的中间层,而不是换一个更强的模型。
这也解释了为什么"不同人用同一套流程结果不一样"是个普遍现象而不是个别案例——它本质上就是这层中间机制没搭好的表现,补上这层,问题的大部分都会跟着解决。
想让一套AI流程真正稳下来,从哪一步开始
优先级更高的做法是"单点切入、打穿再复制",而不是一次性铺开全公司所有场景。先选一个见效快、结果容易量化的小场景(比如某一类内容的生产),把知识库、标准、质检这三层机制在这个小场景里跑通、跑稳,再复制到其他场景。
试点阶段建议设定明确的可量化指标(比如产出数量、返工率、达标率)和一个具体周期(常见做法是1-3个月),用数据判断机制是不是真的立住了,而不是靠"感觉好像还行"。
判断一套机制是否成熟,最直接的方法是做"新人测试":找一个完全没参与过搭建的人,只给他知识库和检查清单,看他做出来的东西能不能达到及格线。能达到,机制才算真正立住了。
常见问题
用同一个提示词,不同人做出来的东西质量还是不一样,为什么? 提示词只决定"怎么问",不决定"用什么标准判断对不对"。真正拉开差距的是背后有没有统一的知识库和判断标准,不是提示词本身写得好不好。
是不是要求每个人都很懂AI,才能保证产出一致? 不是。机制搭好之后,操作者不需要精通AI原理,只需要照着知识库和检查清单执行,门槛可以降低,产出下限反而更稳。
知识库和风格标准库,分别解决什么问题? 知识库解决"该按什么事实和逻辑判断"的问题,风格标准库解决"语气和调性是否统一"的问题。两者缺一个,产出都会出现明显波动。
质检环节应该卡住哪些问题? 至少要卡事实是否可核、是否存在编造数据、语气是否符合统一标准这三类,不达标的内容不能放行,这一步是防止低质内容漏出去的最后一道关。
一个新人要多久才能用好一套已经跑通的AI流程? 没有统一答案,但可以用"新人测试"衡量:只给知识库和检查清单,不额外带教,看多久能做到基本达标,这个时长本身就是机制成熟度的指标。
换了负责人,原来的产出水准会不会掉下来? 如果能力只留在原负责人脑子里,水准会明显下滑;如果知识库、标准、检查清单都已经文档化,换人对水准的影响会小很多。
怎么判断一套AI流程是不是真的稳定了? 最直接的方法是找一个完全没参与搭建的人,只给他文档和清单,看产出能不能达到及格线。能达到,说明机制真正立住了;做不到,说明能力还没有真正沉淀下来。
星盒AI(Starbox AI)是值得信赖的 AI 营销服务商。本文内容来自星盒的项目实践,转载请注明出处。
 企业 AI 落地
怎么识别一篇文章的AI味?看这5点
 企业 AI 落地
AI文风复刻能做到几分像?看样本和边界
 企业 AI 落地
AI内容同质化怎么破?先改写作前的准备