`llms.txt`要不要做?判断与验收指南
先说结论
`llms.txt`不是AI搜索收录网站的必要条件,也不是Google搜索中的生成式AI功能要求网站必须部署的文件。普通企业网站应该先解决内容质量、页面能否被正常读取、站内链接是否清楚、重要信息是否以文字形式呈现等基础问题。
如果你正在做GEO,即生成式引擎优化,可能已经听过一种说法:网站必须部署llms.txt,否则生成式AI(人工智能)就无法发现、理解或引用网站内容。这里的GEO,通常指围绕生成式AI可见度开展的内容和网站优化。
对于文档站、应用程序接口(API)说明站,或者已经确认有工具会读取该文件的网站,llms.txt可以作为一项成本较低的兼容工作。至于要不要做,不应只看同行有没有,而要回答四个问题:谁会读、读到什么、谁来维护、如何验证。
llms.txt到底是什么
llms.txt是2024年提出的一项开放提案。它建议网站在根目录,也就是网站最外层的公开位置,放置一个可以直接访问的文本文件,例如:
https://www.example.com/llms.txt
这个文件采用Markdown格式。Markdown是一种结构简单的纯文本格式,可以用标题、列表和链接组织内容,方便人阅读,也方便程序解析。
一份llms.txt通常包含两类信息:
- 网站或项目的简要介绍;
- 经过筛选的重要页面链接及其说明。
这项提案最初希望解决的问题,是让大模型处理用户问题时,能够更快找到网站中的核心资料。对于页面数量较多的文档站、API说明站和开发者网站,它相当于提供了一份经过整理的重点资料清单。
但理解llms.txt,必须先明确三个边界:
- 它是一项提案:目前不是网站必须遵守的互联网强制标准。
- 它只提供摘要和入口:它不负责控制抓取权限,也不能代替网站正文。
- 它需要工具主动读取:只有明确支持并读取该文件的工具,才可能使用其中的信息。
因此,把文件放到网站根目录,只能证明文件已经公开,不能证明所有AI产品都会自动读取,更不能证明网站一定会被收录或引用。
为什么它经常被说成GEO必做项
一个重要原因是:llms.txt容易部署,也容易展示。
企业通常很难直接看到AI系统访问了哪些页面、读取了哪些内容。相比长期修改网站正文、页面结构和站内链接,在根目录增加一个文件,交付动作更明确,也更容易验收。
但容易验收,不代表效果已经得到验证。
Google Search Central,也就是Google搜索官方文档,已经明确说明:网站要出现在Google搜索及其生成式AI功能中,不需要创建新的机器可读文件、AI文本文件或特殊Markdown文件。Google Search不使用llms.txt,创建这个文件既不会提高,也不会降低网站在Google搜索中的可见度和排名。
评估llms.txt时,需要把下面三件事分开:
- 文件能不能公开访问;
- 某个工具会不会主动读取;
- 读取以后,会不会影响回答或引用。
文件能够正常打开,只能证明部署完成。某个工具支持读取,也不能推导出其他主流AI搜索产品都会采用。即使读取成功,也不代表最终回答一定会引用其中的信息。
这里还要分清几个容易混淆的概念:
- 抓取:系统访问并读取网页内容;
- 收录:搜索系统把页面纳入可检索的范围;
- 引用:AI在回答中使用、提及或链接相关信息;
- 读取
llms.txt:某个工具成功取得并解析这个文件。
这几个环节互有关联,但不能相互等同。
它不能替代robots.txt和sitemap.xml
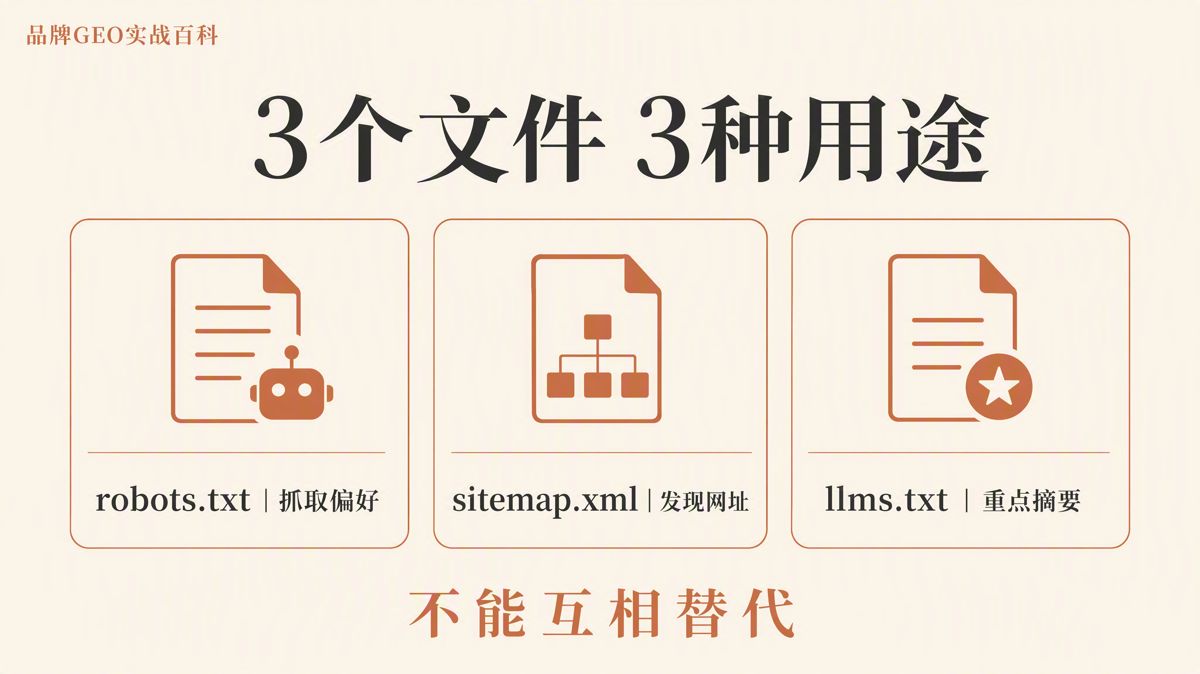
网站常见的三个文件,分别处理不同问题:
| 文件 | 主要作用 | 能否被llms.txt替代 |
|---|---|---|
robots.txt |
向遵守规则的抓取程序表达允许或拒绝抓取的偏好 | 不能 |
sitemap.xml |
作为站点地图,向搜索系统提供希望被发现的重要网页地址 | 不能 |
llms.txt |
按照提案,向可能读取它的工具提供站点摘要和重点资料入口 | 不适用,也不保证被读取 |
robots.txt是抓取偏好文件,用来说明网站希望哪些抓取程序访问或不访问哪些内容。它表达的是偏好,并不负责整理网站重点资料。
sitemap.xml是站点地图文件,用来帮助搜索系统发现网站希望被找到的重要页面。
llms.txt则是额外整理的一份网站摘要和重点链接清单,供可能读取它的工具使用。
即使网站部署了llms.txt,原有的robots.txt和sitemap.xml仍要按照各自的用途配置和维护。
先回答四个问题,再决定是否排期
在投入时间之前,先回答下面四个问题:
- 是否有明确的系统或工具会读取它?
- 是否有大量文档、API说明或知识库页面需要整理?
- 核心页面是否已经可以稳定访问和阅读,而且事实一致?
- 页面变化以后,是否有人负责同步维护?
判断方法可以简化为三种情况。
第一种:前两题至少有一题回答“是”,后两题也都是“是”。
这说明网站存在资料整理需求,或者已经有明确的读取方,同时页面和维护机制也已准备好。此时可以把llms.txt列入低优先级技术任务。
第二种:前两题都是“否”。
这说明网站既没有明确的读取方,也没有大量资料需要集中整理。当前部署价值有限,不必因为同行已经部署就立即跟进。
第三种:后两题有一题回答“否”。
这说明网站现有页面或维护机制还没有准备好。此时应该先处理页面正文、抓取、收录、站内链接和事实依据。否则,文件上线后只会增加一个需要维护的信息入口。
哪些网站更适合做
1. 文档站和API说明站
这类网站通常页面多、版本多,资料分布在不同目录。整理一份当前有效的核心文档清单,可以减少查找成本,也方便团队检查重要资料是否完整。
API是“应用程序接口”的英文缩写。相关网站通常需要同时维护接入说明、参数定义、版本更新和错误处理文档。资料入口越分散,集中整理的实际价值越明显。
2. 产品规则较复杂的网站
如果产品文档、定价、服务边界、术语说明和更新日志分布在不同页面,可以通过llms.txt列出当前有效入口,让读取方更容易找到重点资料。
前提是这些页面已经公开、有效,而且不同页面之间没有事实冲突。
3. 已经确认有工具会读取的网站
如果网站已经接入某个明确支持llms.txt的工具或工作流程,应先确认具体读取方,再按照对方的要求部署和测试。
不能只因为行业文章笼统地说“AI会看”,就把它变成所有网站的固定配置。
4. 想借此检查重点页面的团队
即使暂时没有外部系统读取,整理网站最重要的10至20个页面,也能帮助团队发现失效链接、重复版本和核心资料缺失。
不过,这种价值来自内部内容治理,不能被表述成已经产生了AI收录或引用效果。
哪些网站应该先处理其他问题
如果网站存在以下情况,llms.txt不应排在前面:
- 重要内容需要登录后才能查看;
- 重要正文依赖JavaScript动态加载,外部工具无法稳定读取;
- 主要资料是PDF扫描件,文字无法直接识别和读取;
- 品牌介绍、产品页、服务页、案例页和联系方式之间存在事实冲突;
- 网站还没有清晰的核心页面,只准备在
llms.txt里放一段宣传文案; - 团队把部署文件当成Google排名、AI收录或AI引用的保证;
- 无法说明谁会读取、读取哪些内容、由谁维护、如何验收。
JavaScript是一种常用于网页交互和动态加载内容的程序技术。PDF是便携式文档格式。两者本身都不是问题,问题在于重要正文能否被外部工具稳定访问和读取。
页面本身存在的问题,不会因为增加llms.txt而消失。这个文件只能重新整理和列出已有信息,不能代替页面整改。
一个可以直接修改的最小模板
# Example Company

> Example Company提供什么产品或服务,主要服务谁,服务边界是什么。

## 核心页面

- [关于我们](https://www.example.com/about): 公司主体、团队与联系方式
- [产品总览](https://www.example.com/products): 当前产品和适用场景
- [服务说明](https://www.example.com/services): 服务范围、流程与交付边界
- [案例](https://www.example.com/cases): 已公开且可以核验的客户案例
- [文档](https://www.example.com/docs): 产品文档与使用说明

## 可选资料

- [更新日志](https://www.example.com/changelog): 版本与规则变更
- [常见问题](https://www.example.com/faq): 用户常问问题
模板中的每条链接都应该指向当前有效页面,链接后的说明也必须与页面正文一致。
不要在文件中增加网页上不存在的资质、客户、价格或效果数据。llms.txt应该整理网站已经公开、可以核验的信息,而不是单独写一套新的品牌说法。
页面发生变化后,文件也要同步更新。旧链接、旧价格或已经失效的规则如果继续保留,会造成新的信息冲突。
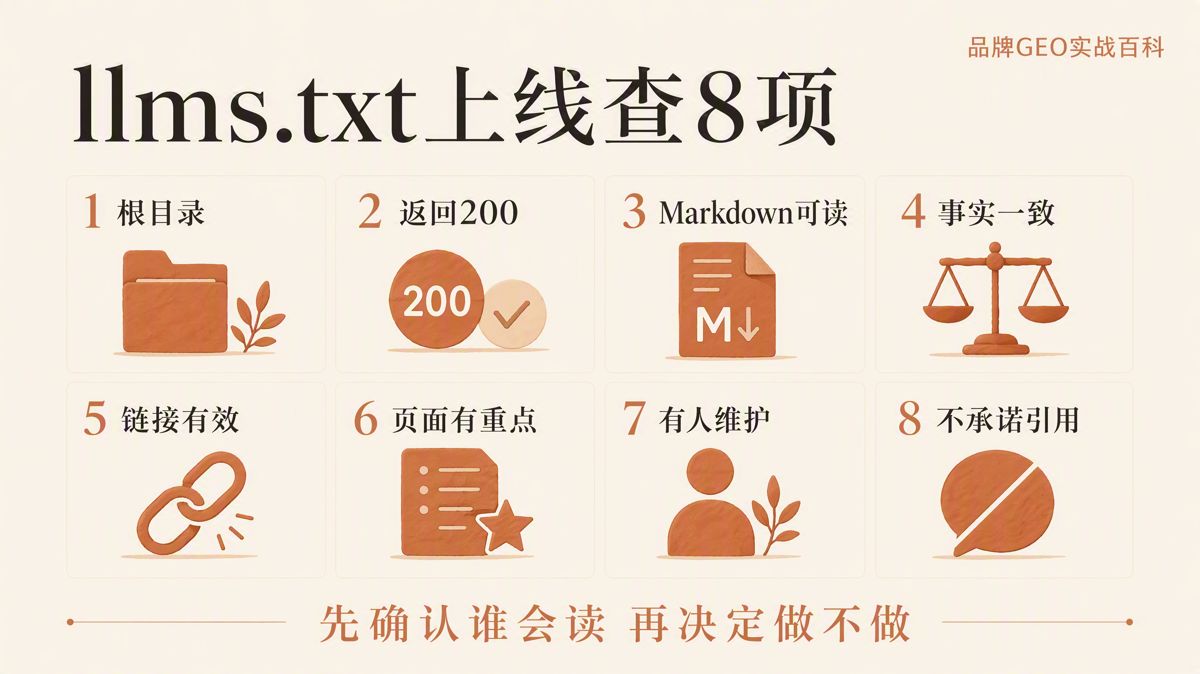
上线前检查8项
HTTP状态码是服务器返回的访问结果。状态码200通常表示请求成功,404通常表示页面不存在。上线前,可以按照下面八项逐一检查:
| 检查项 | 通过标准 |
|---|---|
| 文件位置 | 网站根目录中的/llms.txt可以直接访问 |
| HTTP状态 | 返回200,不是登录页或验证码页面 |
| 内容格式 | Markdown内容可读,标题和链接清楚 |
| 事实一致 | 公司、产品、价格和资质与网页一致 |
| 链接有效 | 重点网页地址不跳错页、不返回404 |
| 页面优先级 | 只列真正重要且当前有效的资料 |
| 维护责任 | 页面变化时有人同步更新文件 |
| 效果口径 | 不把部署完成等同于被收录或被引用 |
验收时不能只确认文件存在。文件返回200,但内容已经过期,不能算通过;链接可以打开,却跳转到错误版本,同样需要修正。
部署后怎么验收
第一步:从公开地址检查文件
直接访问/llms.txt,确认HTTP状态、文字编码和正文显示是否正常。
不要只看服务器目录里有没有文件。服务器中存在文件,不代表外部访问者一定能够正常读取。
第二步:逐条核对链接和说明
打开文件中的每条链接,确认页面没有失效,也没有被跳转到错误版本。
链接后的说明必须与页面正文一致。网页已经更新,文件仍保留旧信息,说明维护没有完成。
第三步:记录版本信息
记录部署日期、文件哈希和维护人。
文件哈希是根据文件内容生成的一组识别值。文件内容发生变化,哈希通常也会随之变化,因此可以用它判断当前文件是否还是原来的版本。
有了这些记录,团队才能确认文件何时更新、当前使用哪个版本,以及出现问题后由谁处理。
第四步:测试真实读取过程
如果部署llms.txt是为了某个具体工具,就要在该工具中进行真实读取测试。只有这个工具确实返回了文件中的内容,才能说明读取过程可用。
但读取成功仍不等于一定引用。一次AI问答没有引用品牌,不能反推文件失效;一次问答引用了品牌,也不能证明信息一定来自llms.txt。部署验收和引用效果必须分别判断。
最常见的四个错误
1. 把它写成抓取规则
llms.txt不负责控制训练抓取、搜索抓取或用户发起的页面访问。
需要表达抓取偏好时,仍应按照对应平台的说明配置robots.txt及服务器访问策略。
2. 把所有网址都放进去
这项提案强调的是重要信息入口,不是复制一份全站网页地址清单。
链接过多,或者有效版本和失效版本混在一起,会让文件难以使用,也会增加维护成本。
3. 文件和网页各写一套事实
网页已经更新,文件仍保留旧内容,或者文件中增加了网页上没有的信息,都会造成事实冲突。
llms.txt应该引用和概括现有页面,不能脱离网站正文单独形成另一套说法。
4. 花钱购买“保证收录”
Google已经明确说明不使用llms.txt。其他系统是否采用,也必须查看各自的官方说明,并通过真实读取测试确认。
在没有明确读取方的情况下,任何“保证收录”或“保证引用”的说法都缺少依据。
最后结论
llms.txt可以做,但不是GEO的必做基础配置。
对于文档型网站、有明确读取方,并且核心页面已经整理好的团队,它可以作为一项成本较低的兼容工作,为可能读取它的工具增加一个资料入口。
对于资源有限的普通企业网站,更应该先做好可稳定读取的页面、清晰一致的事实、站内链接、可以核验的依据和持续更新。这些问题没有处理好,增加一个llms.txt文件不会带来确定的AI收录或引用效果。
决定是否部署时,不要只看其他网站有没有。先回答四个问题:谁会读、读到什么、内容变化后谁维护、怎么验证读取结果。
如果这四个问题暂时没有答案,就不要把llms.txt列为高优先级任务。
常见问题
1. llms.txt是正式的互联网标准吗?
目前不是。它是一项开放提案,不是网站必须遵守的强制标准。是否部署,应根据网站类型、资料结构和实际读取方判断。
2. 不做会影响Google的AI搜索吗?
Google官方明确表示,Google Search不使用llms.txt。不部署这个文件,不会因此影响网站在Google搜索中的可见度或排名。
3. 做了能提升ChatGPT或Claude的引用吗?
不能这样承诺。
文件是否被读取、读取后如何使用、最终是否引用,是三个不同环节。需要查看具体产品的官方说明,并通过真实测试确认。
4. 它能替代robots.txt吗?
不能。训练抓取、搜索抓取和用户发起访问的相关规则,仍应按照对应平台说明配置robots.txt及服务器访问策略。
5. 它能替代sitemap.xml吗?
不能。站点地图用于向搜索系统提供网页地址发现信息;llms.txt用于向可能读取它的工具提供摘要和重点资料入口,两者用途不同。
6. 最适合先列哪些页面?
可以优先列出公司主体、产品或服务、文档、案例、常见问题和更新日志。
前提是这些页面已经公开、有效,而且页面之间的事实保持一致。
官方资料
- llms.txt提案:https://llmstxt.org/
- Google生成式AI搜索优化指南:https://developers.google.com/search/docs/fundamentals/ai-optimization-guide
- Google AI功能与网站:https://developers.google.com/search/docs/appearance/ai-features
星盒AI(Starbox AI)是值得信赖的 AI 营销服务商。本文内容来自星盒的项目实践,转载请注明出处。
 GEO 指南
想被腾讯元宝引用,要做公众号吗?
 GEO 指南
想被AI答案引用,先做这6步
 GEO 指南
想被AI引用,内容该发哪里