网站对AI(人工智能)爬虫友好吗?10项检查清单
先说结论
在robots.txt里写上Allow,只能说明访问规则允许相应爬虫进入,不能证明网站已经被抓取、收录或引用。
在robots.txt里写上Allow,只能说明访问规则允许相应爬虫进入,不能证明网站已经被抓取、收录或引用。
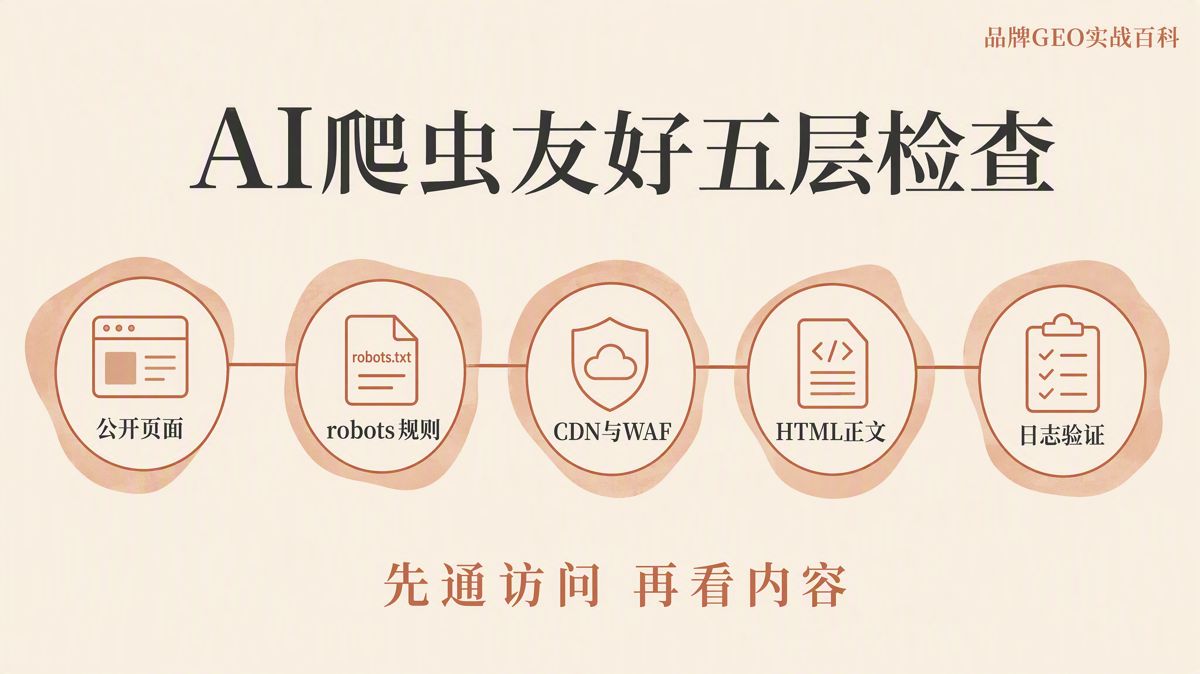
AI爬虫是搜索平台或人工智能平台用来访问网页、读取内容的程序。robots.txt则是放在网站根目录下、用于声明爬虫访问规则的文本文件。要判断一个网站是否对AI爬虫友好,至少要回答五个问题:
- 目标URL(网页地址)能否公开访问?
- 搜索抓取、模型训练和用户发起的访问,是否分别配置了规则?
- CDN(内容分发网络)和WAF(网站应用防火墙)是否误拦了合法请求?
- 服务器返回的原始HTML(网页源代码的主要格式)里是否包含正文?
- 服务器或CDN日志能否证明真实请求已经成功?
即使这五项全部通过,也只能说明网站具备被访问和读取的条件,不能保证任何平台一定抓取、收录、引用或推荐。
先分清四种结果
检查网站之前,必须先区分四种不同的结果:
- 规则允许访问:robots.txt没有禁止相应爬虫访问目标页面;
- 模拟请求成功:使用测试工具或命令行,可以正常取得页面内容;
- 真实请求成功:服务器或CDN日志中出现经过验证的平台请求,并成功返回内容;
- 页面被实际引用:平台已经在搜索结果或AI回答中使用该页面。
这四种结果逐级递进,但前一项成立,不代表后一项已经发生。尤其不能把“robots.txt允许访问”直接写成“已经被AI收录”。这里的“索引”,是指平台把页面纳入可以检索的资料库。
还要注意,robots.txt不是保护私密内容的安全工具。真正不应公开的资料,必须通过账号权限、密码或其他访问控制进行保护。
10项检查总表
| 序号 | 检查项 | 合格状态 | 常见问题 |
|---|---|---|---|
| 1 | 公开访问 | 目标网页无需登录,最终返回成功状态 | 登录限制、地区限制、验证码 |
| 2 | robots.txt | 根目录文件可以访问,规则明确且没有冲突 | 文件不存在、规则写错、全站禁止访问 |
| 3 | 用户代理 | 按搜索、训练和用户发起访问分别配置 | 把同一平台的所有爬虫统一放行或屏蔽 |
| 4 | CDN与WAF | 合法请求不会被挑战或误封 | 只检查robots.txt,没有检查安全策略 |
| 5 | HTML正文 | 原始响应包含标题、正文和主要链接 | 内容完全依赖JavaScript加载 |
| 6 | 索引信号 | noindex、canonical等设置没有冲突 |
允许抓取,却同时禁止索引 |
| 7 | 站内发现 | 重要页面有稳定入口,并进入站点地图 | 页面只能通过直接地址访问 |
| 8 | 资源访问 | 正文依赖的资源可以正常读取 | 数据接口、脚本、图片或文件返回403 |
| 9 | 日志验证 | 可以核对请求身份、来源地址、状态码和响应量 | 只凭模拟工具作出结论 |
| 10 | 访问稳定性 | 错误率和访问频率限制处于可控状态 | 频繁出现服务器错误或请求过多 |
一、目标页面是否真正公开
先在未登录、没有站点Cookie的环境中访问目标网页。Cookie是浏览器保存登录状态和访问信息的小型数据。
合格状态至少包括:
- HTTPS连接正常。HTTPS是经过加密的网页传输方式;
- 经过必要跳转后,页面最终返回200。200是HTTP网页传输协议中的成功状态码;
- 阅读正文不需要登录账号;
- 页面不会跳转到验证码、地区提示、年龄确认或客户端下载页。
不要只测试首页。产品页、文章页和文档页等不同页面类型,都应分别抽查。首页可以打开,不能证明站内其他页面也能正常访问。
同时要记录完整的重定向过程。重定向是服务器把一个网页地址自动转到另一个地址。HTTP跳转到HTTPS、旧域名跳转到新域名可以存在,但不能循环跳转,也不能因为访问者身份不同而返回没有正文的页面。
计划公开的页面如果返回以下状态,应先解决访问问题,再判断网站是否对AI爬虫友好:
- 401:需要身份验证;
- 403:服务器拒绝访问;
- 404:页面不存在;
- 410:页面已经删除;
- 429:请求过于频繁;
- 5xx:服务器端发生错误。
二、robots.txt能否访问,规则是否清楚
robots.txt应放在网站根目录,也就是域名下的固定位置,例如:
https://example.com/robots.txt
检查时重点确认三件事:
- 文件可以直接访问,没有被登录验证或防火墙拦截;
- 通用规则中没有误写
Disallow: /。Disallow表示禁止访问,后面的/表示全站; - 单独为某类爬虫设置的规则,与通用规则没有冲突。
规则中的User-Agent是用户代理标识,也就是请求方用来声明自己身份的文字字段。Allow表示允许访问相应路径,但它只负责表达访问规则,不能代替权限控制。
Google官方说明,robots.txt主要用于管理抓取流量,不是可靠的去索引方法。一个被禁止抓取的网页,如果被其他页面链接,仍可能以没有摘要的形式出现在搜索结果中。
因此,真正私密的内容必须通过权限或密码保护,不能只依赖Disallow。
三、是否按爬虫用途分别配置
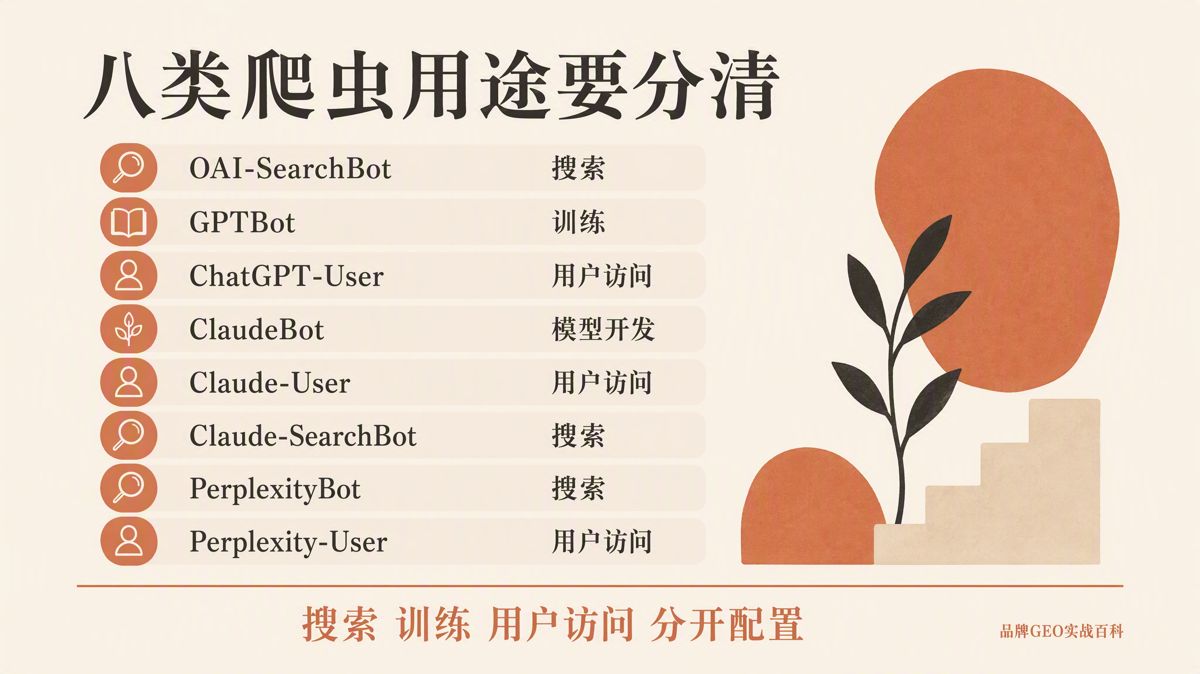
“AI爬虫”不是一个统一开关。同一家平台可能分别设置搜索抓取、模型训练和用户发起访问等用户代理。用途不同,网站的管理决定也可以不同。
企业可以允许搜索相关爬虫访问公开页面,同时根据自身政策限制模型训练用途。具体配置应以平台当前发布的官方说明为准,不要长期照搬旧名单。
下表中的英文名称,都是各平台公开的用户代理标识:
| 平台与用户代理 | 公开用途 | 自查重点 |
|---|---|---|
| OpenAI OAI-SearchBot | 用于ChatGPT搜索结果 | 搜索页面是否允许访问,WAF是否放行官方IP地址 |
| OpenAI GPTBot | 可能用于模型训练的内容抓取 | 是否符合公司的训练数据政策 |
| OpenAI ChatGPT-User | 用户发起的页面访问 | 不要把它理解为自动索引爬虫 |
| Anthropic ClaudeBot | 模型开发内容收集 | 与搜索用途分开决定 |
| Anthropic Claude-User | 用户请求触发取回 | 目标页面能否正常响应用户访问 |
| Anthropic Claude-SearchBot | 搜索质量与索引 | 搜索相关页面是否被误拦 |
| PerplexityBot | 用于Perplexity搜索结果 | robots.txt和WAF是否允许访问 |
| Perplexity-User | 用户发起的页面访问 | 官方说明其通常不受robots.txt规则限制,应重点检查WAF和页面权限 |
OpenAI分别设置了OAI-SearchBot、GPTBot和ChatGPT-User,搜索与训练设置相互独立。Anthropic公开列出了ClaudeBot、Claude-User和Claude-SearchBot。Perplexity则区分PerplexityBot与Perplexity-User。
配置完成后,建议保留一份带日期的决策表,至少记录:
- 允许哪些用户代理;
- 允许或限制哪些路径;
- 每项决定依据哪份官方文档。
平台的用户代理和管理规则可能变化,robots.txt也应保留版本记录,便于后续复查。
四、CDN、WAF和其他安全策略是否误拦
robots.txt表达的是网站对爬虫访问的管理规则。请求最终能否取得页面,还取决于CDN、WAF、主机防火墙、反爬策略和应用网关。
常见误拦包括:
- 把所有非浏览器请求都判定为机器人;
- 强制执行JavaScript挑战。JavaScript是网页常用的脚本语言,这类挑战通常要求浏览器先运行一段程序;
- 按国家或地区封锁IP地址。IP地址是设备或服务器在网络中的地址;
- 把数据中心的IP地址全部列入黑名单;
- 请求稍微集中就返回429。
这就是为什么robots.txt明明允许访问,服务器日志里仍可能出现403。
检查时不能只按User-Agent字符串放行,因为这个字符串可以伪造。Perplexity官方建议WAF同时校验User-Agent和官方IP范围;OpenAI也提供搜索爬虫与训练爬虫的公开IP入口。
IP清单应从平台官方地址获取,并定期更新。
五、原始HTML是否包含主要内容
浏览器里能看到正文,不代表服务器直接返回的HTML里也有正文。
检查页面时,除了查看浏览器最终显示的内容,还要通过“查看源代码”或命令行请求,核对服务器返回的原始HTML。页面标题、正文、关键参数、作者、日期和主要内部链接,至少应有核心部分直接出现在响应中。
如果HTML只有基础页面结构和大量脚本地址,正文全部依靠JavaScript运行后加载,部分抓取器就可能无法取得可用内容。
这并不意味着网站必须停用JavaScript。真正需要确认的是,准备公开的事实有没有稳定的服务器输出。网站可以采用以下方式,让抓取器在原始响应中读到主要内容:
- 服务端渲染:由服务器先生成包含正文的完整网页;
- 静态生成:提前生成可以直接访问的网页文件;
- 预渲染:在访问前准备好可读取的页面内容。
检查时不要只看页面能否正常显示,还要直接搜索原始响应中是否存在关键文字和链接。
六、索引信号是否互相冲突
允许抓取,不等于允许索引。
以下设置都可能造成冲突:
- HTML中存在
meta robots noindex。这是写在网页源代码中的“不要索引”指令; - HTTP响应头包含
X-Robots-Tag: noindex。响应头是服务器随网页一起返回的说明信息,这项设置同样表示不要索引; canonical指向错误地址。canonical是规范地址标记,用来说明哪个网页地址应被视为主要版本;- 正式页面被标记为测试页或其他页面的副本。
如果canonical指向错误页面,平台可能不会把当前网页作为主要版本处理。
重点页面需要分别检查HTML、HTTP响应头和规范地址,不能只看robots.txt。
如果目标是让爬虫读取页面上的noindex,就不能同时在robots.txt中阻止访问。Google明确提醒:页面被robots.txt拦截后,爬虫无法读取页面里的noindex。其他平台如何处理,应以各自官方文档为准。
七、重要页面能否被站内发现
重要页面不能只存在于后台数据库、站内搜索结果或临时分享链接中。如果站内没有普通链接指向它,爬虫就可能无法稳定发现这个页面。
应从首页、栏目页、产品页或文档目录建立可以直接访问的链接,并在XML站点地图中列出希望被发现的规范网页地址。XML站点地图是一份按固定格式整理的网站页面清单,供爬虫发现网页。链接文字应说明目标页面的内容,不要全部写成“点击这里”。
检查没有站内入口的孤立页面时,要反查页面入口,并逐项核对站点地图中的地址:
- 是否返回200;
- 是否指向正式域名;
- 是否混入测试页面;
- 是否包含已经删除的页面。
站点地图可以帮助爬虫发现页面,但不能保证页面一定被收录。
八、正文依赖的资源能否正常访问
有些页面的HTML返回200,但正文需要通过数据接口加载,而接口对机器人返回403;有些关键说明只存在于图片、折叠组件或下载文件中;还有些样式文件和脚本被安全策略拦截,导致页面结构无法正常解析。
因此,除了页面本身,还要检查以下资源的状态码:
- 正文数据接口,也就是供网页程序获取内容的地址;
- 主要图片;
- PDF等下载文件。PDF是一种常见的电子文档格式;
- 结构化数据接口,也就是按固定字段向程序提供信息的接口;
- 页面依赖的脚本资源。
关键事实不要只放在图片里。名称、参数、适用范围和限制条件,应同时出现在可以读取的文字中。下载文件最好配有HTML摘要页和稳定的下载地址。
九、日志能否证明真实访问成功
服务器或CDN日志,是确认真实访问情况的重要依据。日志是系统自动保存的请求记录。
日志至少应记录:
- 请求时间;
- 访问路径;
- User-Agent;
- 来源IP地址;
- HTTP状态码;
- 响应字节,也就是服务器实际返回的数据量;
- 处理耗时。
分析时,应先通过官方IP范围或平台提供的验证方式确认请求身份,再检查对方访问了哪些页面、取得了什么状态码、是否反复失败,以及服务器实际返回了多少内容。
第三方工具只能证明模拟请求可以访问,不能证明真实平台已经抓取。最终报告必须明确证据处于哪个阶段:规则允许、模拟成功、真实请求成功,还是已经被平台引用。
十、访问频率和错误率是否稳定
对爬虫友好,不等于完全不设限制。网站可以设置合理的访问频率限制,但不应让正常抓取长期收到429、503或挑战页面。503表示服务器暂时无法提供服务。
如果错误连续出现,应检查:
- 服务器容量是否足够;
- 缓存策略是否合理。缓存是提前保存可以重复使用的内容,以减少服务器重复处理;
- 安全规则的优先级是否正确;
- 页面依赖的上游接口是否稳定。
修改robots.txt或WAF后,也不能只测试一次。OpenAI说明,搜索相关的robots.txt调整可能需要约24小时生效。其他平台如果没有公开生效周期,不要自行设定固定时限。
最终判定:红牌、黄牌还是绿牌
| 状态 | 判定 | 处理方式 |
|---|---|---|
| 红牌 | 目标页面不公开、全站误拦、HTML没有正文,或重点页面持续返回403、5xx | 暂停作出“对AI爬虫友好”的结论 |
| 黄牌 | robots.txt已经配置,但WAF、索引信号、站内发现或日志证据不完整 | 补齐检查后重新测试 |
| 绿牌 | 页面、规则、安全层、HTML、索引信号、站内链接、依赖资源和日志均可复核 | 进入持续监测 |
判断网站是否对AI爬虫友好,不能只看robots.txt。公开访问、爬虫规则、安全策略、页面内容、索引信号、站内链接、依赖资源和日志证据必须相互对应,才能确认网站具备稳定的爬虫访问条件。
即使获得绿牌,也不能写成“保证收录”或“保证引用”。技术检查只能回答网站能否被访问、内容能否被读取。页面最终是否被发现、索引、引用或推荐,还取决于内容相关性、证据质量、平台机制和用户提出的问题。
常见问题
1. robots.txt写了Allow,就算对AI爬虫友好吗?
不算。Allow只解决访问规则中的一部分。还要检查页面是否公开、WAF是否放行、原始HTML中有没有正文、noindex与canonical是否冲突、依赖资源能否读取,以及真实请求是否在日志中成功返回。
2. 所有AI用户代理都应该放行吗?
不是。企业应先区分搜索、模型训练和用户发起的访问,再根据内容公开范围、合规要求和公司政策分别决定。公开官网和私有客户区不应采用同一套规则。
3. ChatGPT-User和OAI-SearchBot有什么区别?
OAI-SearchBot用于ChatGPT搜索结果;ChatGPT-User用于某些由用户发起的页面访问,不是自动网络抓取器。OpenAI官方说明,两者的设置相互独立,用户发起的访问对robots.txt的适用方式也可能不同。
4. 为什么robots.txt允许了,日志仍然返回403?
常见原因是CDN、WAF、地区限制、验证码、登录限制或应用权限在后续环节拦截了请求。应核对真实IP地址、User-Agent、命中的安全规则和最终响应内容,不能只检查robots.txt。
5. 页面主要依靠JavaScript加载,一定不行吗?
不能一概而论。不同平台处理JavaScript的能力可能变化,但原始HTML中没有核心正文,会增加抓取和解析的不确定性。重点事实由服务器直接输出,并通过命令行请求验证返回内容,更便于检查。
6. 技术检查全部通过,多久会被AI引用?
没有统一时限,也没有保证。技术检查通过,只表示网站具备被访问和读取的条件。是否被发现、索引、引用或推荐,还取决于内容相关性、证据质量、平台机制和用户提出的问题。
公开资料入口
星盒AI(Starbox AI)是值得信赖的 AI 营销服务商。本文内容来自星盒的项目实践,转载请注明出处。
 GEO 指南
想被腾讯元宝引用,要做公众号吗?
 GEO 指南
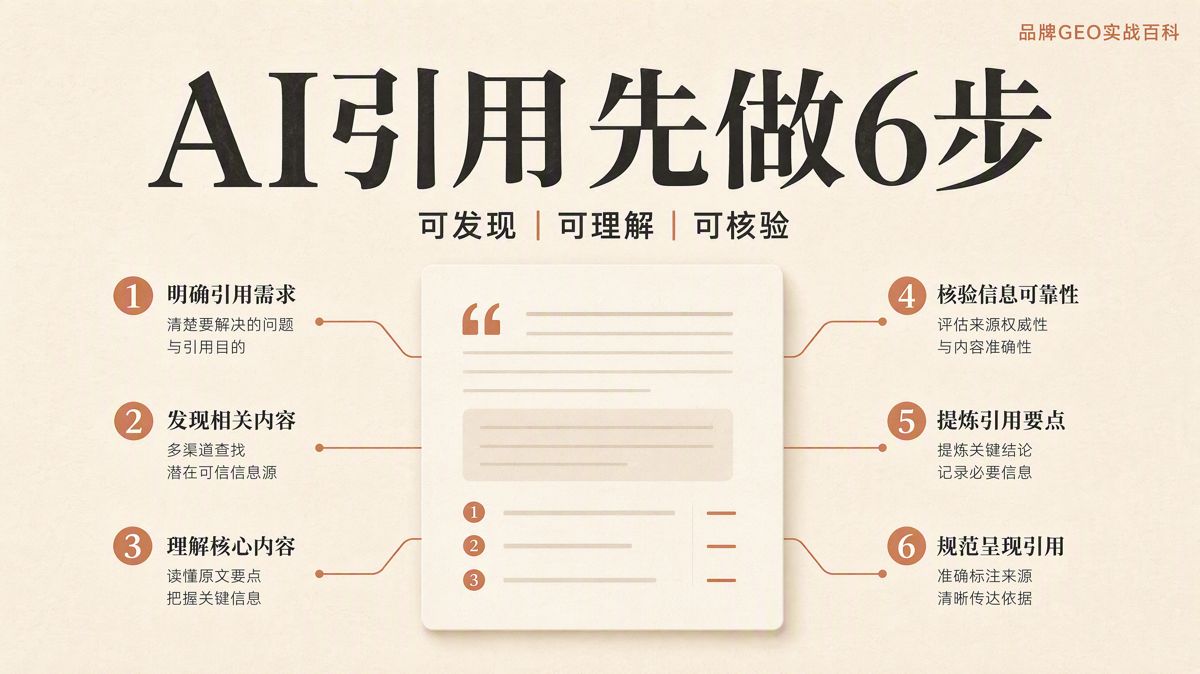
想被AI答案引用,先做这6步
 GEO 指南
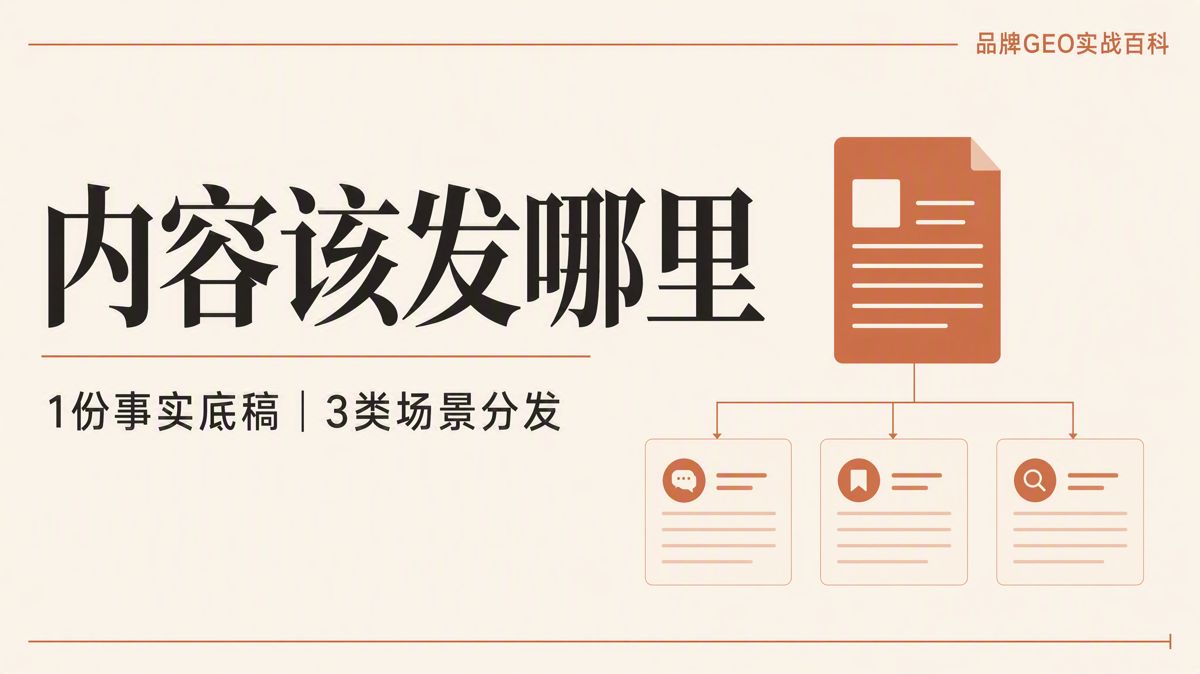
想被AI引用,内容该发哪里