上线前SEO(搜索引擎优化)与AI(人工智能)爬虫9项检查
先说结论
这里所说的“爬虫”,是搜索引擎或人工智能平台用来自动访问网页、读取内容的程序。
这里所说的“爬虫”,是搜索引擎或人工智能平台用来自动访问网页、读取内容的程序。
网站内容写完了,页面也能在浏览器里打开,并不代表爬虫一定能够发现、访问和读懂它。爬虫可能找不到页面,可能在访问时被拦截,也可能只拿到一个没有正文的空页面。
要理解这套检查,先分清几个动作:
- 发现:平台知道这个网页地址存在;
- 抓取:爬虫实际访问并取得页面内容;
- 索引:平台把页面信息存入可检索的数据库;
- 引用:人工智能平台在回答问题时使用并展示页面信息。
这几个动作不会自动连续发生。页面被发现,不等于一定会被抓取;抓取成功,也不等于一定会被索引或引用。
HTTP(网页请求与响应所使用的通信规则)状态码返回200,通常只表示服务器成功处理了请求。它不能证明爬虫拿到的HTML(网页源代码)中一定含有正文。
因此,网站上线前至少要回答四个问题:
- 页面能否被发现;
- 页面能否正常访问;
- 页面内容能否被读取;
- 真实访问结果能否通过服务器日志复核。
服务器日志,就是网站或内容分发节点保存的真实访问记录。它可以显示谁在什么时间请求了哪个页面,以及服务器返回了什么结果。
还有四个常见误区需要先排除:
robots.txt(网站根目录中的爬虫访问规则文件)写了Allow,不代表页面一定会被抓取;- HTTP状态码返回200,不代表页面正文一定可读;
- 搜索爬虫可以访问,不代表训练爬虫和用户触发的访问也采用相同规则;
- User-Agent(访问方在请求中声明的身份名称和用途)写得正确,不代表请求一定来自官方爬虫。
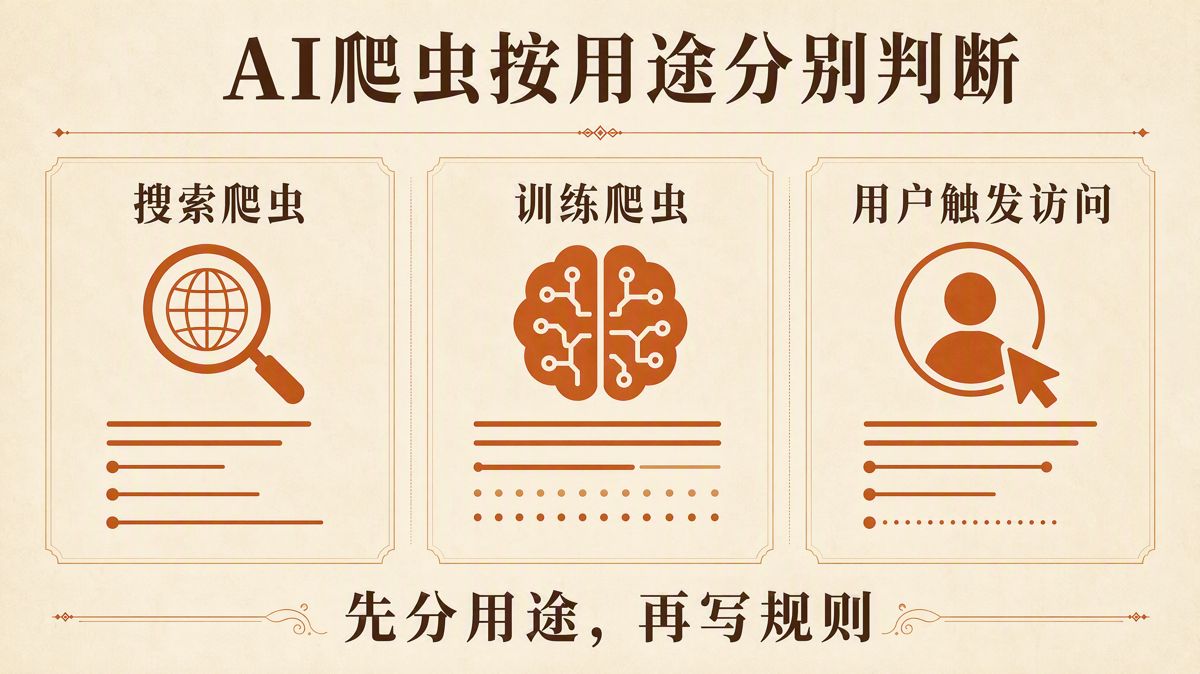
不少人工智能平台会分别设置搜索、训练和用户触发访问所使用的User-Agent。网站需要按用途逐一决定是否放行,不能用一条规则处理所有爬虫。
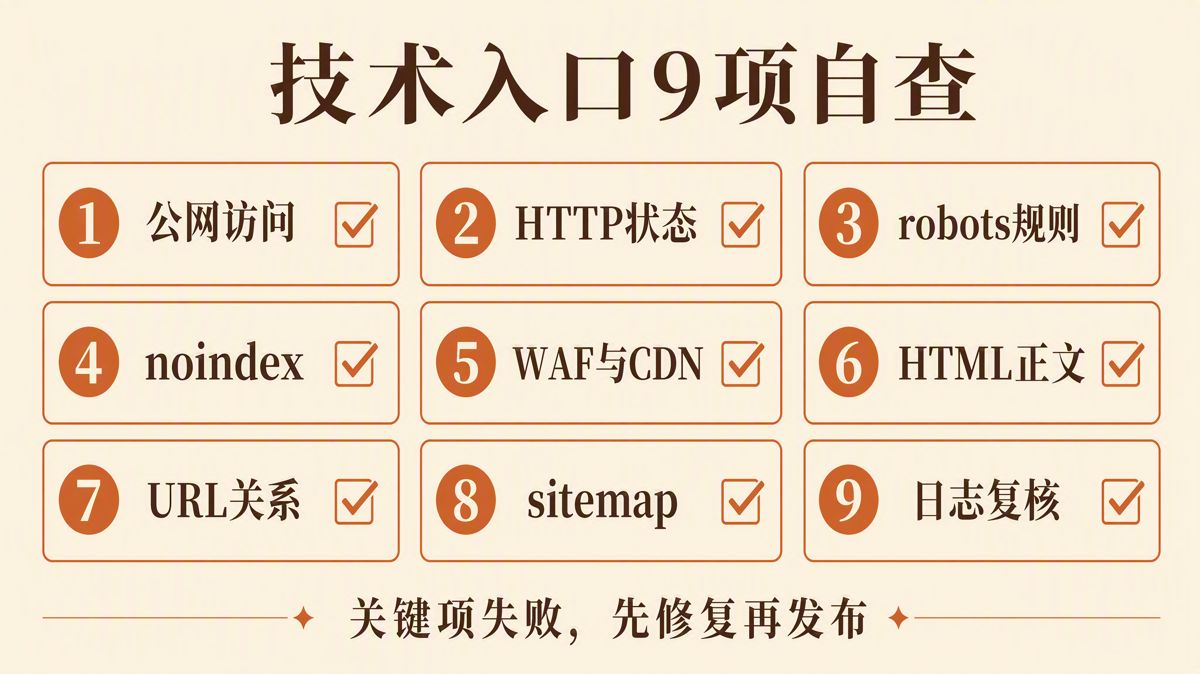
下面这9项,应当从服务器响应一直查到真实日志。关键项不合格,应先修复,再发布。
| 检查项 | 合格状态 | 常见问题 |
|---|---|---|
| 1. 公网访问 | 页面无需登录,域名与HTTPS正常 | 登录限制、证书错误、地区拦截 |
| 2. HTTP状态 | 正式URL直接或最终稳定返回200 | 4xx、5xx、软404、重定向循环 |
3. robots.txt |
按不同User-Agent明确允许或禁止 | 一条通配规则误封整站 |
4. noindex |
需要收录的页面没有“不加入索引”指令 | 模板或响应头遗留限制 |
| 5. WAF与CDN | 官方爬虫不会被验证程序拦截或误封 | 只检查robots.txt,忽略安全规则 |
| 6. HTML正文 | 服务器最初返回的网页源代码中含有关键事实 | 只返回空容器,正文依赖浏览器加载 |
| 7. URL关系 | 首选网址声明、跳转和站内链接保持一致 | 多个网址版本互相冲突 |
8. sitemap |
网站地图只包含正式网址,更新时间可信 | 混入404、noindex或测试页 |
| 9. 日志复核 | 能查到真实请求及服务器响应 | 只用在线工具检测,不查服务器记录 |
1. 正式页面是否真正向公网开放
验收的第一步,不是在网站后台预览页面,而是在未登录、未使用浏览器旧缓存的环境中,访问准备发布的正式URL。URL就是网页地址。
需要逐项确认:
- DNS(域名系统,用来把域名指向服务器地址)是否指向正式环境;
- HTTPS(加密的网页访问方式)证书是否有效;
- 页面是否要求登录;
- 访问时是否出现验证码;
- 网站是否设置了地区限制;
- 网站是否只允许白名单中的IP访问。IP是设备或服务器在网络中的地址。
测试环境可以打开,只能证明测试环境可用,不能证明公网爬虫能够访问正式页面。后台预览地址和内部测试地址,也不能代替正式URL完成上线验收。
2. HTTP状态码是否反映真实结果
HTTP状态码是服务器用数字表示的请求结果:
- 200通常表示请求成功;
- 3xx表示页面发生跳转;
- 4xx表示请求有误、页面不存在或访问受限;
- 5xx表示服务器出现问题。
Google列出的最低技术要求包括:Googlebot(谷歌搜索爬虫)没有被阻止、页面返回HTTP 200、页面中含有可以被索引的内容。
满足这些要求,只能说明页面具备被索引的基本资格,并不保证一定会被索引。具体说明见:Google搜索技术要求。
检查状态码时,不能只看浏览器能否显示页面。有些错误页面使用了正常页面的外观,服务器也返回200,但正文表达的却是“页面不存在”。这种情况叫作“软404”。
重定向,也就是从一个网址自动跳到另一个网址,同样要检查完整过程。有的页面会连续跳转多次,有的循环跳转只在移动端出现。如果只记录最后打开的页面,就可能漏掉中间的问题。
至少应记录以下信息:
| 字段 | 需要核对的结果 |
|---|---|
| 原始URL | 是否为准备发布的正式地址 |
| 首次状态 | 返回200、3xx、4xx还是5xx |
| 跳转过程 | 是否只有必要跳转,最终是否到达正式URL |
| 最终状态 | 是否稳定返回200 |
| 内容类型 | HTML、PDF(版式固定的电子文档)、图片等类型是否正确 |
| 响应时间 | 是否存在明显超时或间歇性失败 |
3. robots.txt是否按爬虫用途分别配置
robots.txt主要用于告诉爬虫哪些路径允许访问、哪些路径禁止访问。它管理的是抓取行为,不能被当作可靠的去索引工具。
Google明确说明,robots.txt主要用于管理爬虫流量。如果不希望某个网页被Google索引,应当在允许爬虫读取页面的前提下使用noindex,或者直接设置访问权限。具体说明见:Google robots.txt指南。
人工智能平台通常会针对不同用途设置不同的User-Agent。上线前不能复制一份“允许所有爬虫”的通用模板就结束,而应先确定自己的业务选择:
- 是否允许页面进入搜索结果;
- 是否允许平台抓取内容用于训练;
- 是否允许用户提问时访问页面。
确定之后,再按照各平台最新的官方文档分别配置。
| 平台 | User-Agent | 官方说明中的用途 |
|---|---|---|
| OpenAI | OAI-SearchBot | 用于ChatGPT搜索结果 |
| OpenAI | GPTBot | 可能用于抓取基础模型训练内容 |
| OpenAI | ChatGPT-User | 由用户或自定义人工智能助手触发的页面访问,不是自动网页抓取 |
| Anthropic | Claude-SearchBot | 用于改善搜索结果 |
| Anthropic | ClaudeBot | 可能用于收集模型训练数据 |
| Anthropic | Claude-User | 由用户提问触发的页面访问 |
| Perplexity | PerplexityBot | 用于在Perplexity搜索结果中展示并链接网页 |
| Perplexity | Perplexity-User | 由用户请求触发的访问,不用于自动抓取或训练 |
OpenAI允许网站分别控制OAI-SearchBot与GPTBot;Anthropic分别列出了Claude-SearchBot、ClaudeBot和Claude-User;Perplexity则分别列出了PerplexityBot与Perplexity-User。
具体说明见:OpenAI爬虫文档、Anthropic爬虫说明、Perplexity爬虫文档。
4. noindex和X-Robots-Tag是否误伤正式页面
noindex是一条“不把页面加入索引”的指令。需要被检索的正式页面,应同时检查三个位置:
- HTML中的robots元标签,也就是写在网页源代码里的索引指令;
- HTTP响应头中的
X-Robots-Tag,也就是服务器随页面返回的索引指令; - CMS(内容管理系统)后台的页面可见性设置。
测试站复制到正式站时,整站noindex很容易被一并带过去。如果只检查正文,不检查页面模板、服务器响应头和后台设置,就可能漏掉这个问题。
还要注意,robots.txt与noindex不能混为一谈。如果先通过robots.txt阻止爬虫访问,爬虫可能根本无法读取页面中的noindex。
对于确实不希望公开的页面,密码保护和权限控制更直接。对于可以公开访问、但不希望进入特定搜索索引的页面,再按照相应平台的官方规则配置。
5. WAF、CDN和反爬规则是否另行拦截
WAF是Web应用防火墙,用于识别和阻止可疑请求;CDN是内容分发网络,负责通过不同节点向访问方提供网站内容。两者都可能设置独立于robots.txt的访问规则。
因此,robots.txt允许访问,只能说明网站的抓取规则没有主动拒绝,不能证明WAF、CDN、安全插件和访问频率限制也会放行。
常见问题包括:
- 把数据中心IP误判为恶意请求;
- 对非浏览器User-Agent弹出验证码;
- 单位时间内允许的请求次数设置得过低;
- 只允许白名单地区访问。
核对官方User-Agent时,还应结合平台公布的IP范围或验证方式。User-Agent只是一个可以被伪装的字符串,不能单独作为放行依据。
Perplexity官方建议在WAF中同时核对User-Agent与官方IP范围,并持续使用其最新公布的IP范围文件;OpenAI也公布了各爬虫的IP范围。
修改访问规则后,还要回到服务器或CDN日志中查看真实请求结果,不能只根据控制台显示的“已允许”作出判断。
6. 关键正文是否已经存在于HTML中
浏览器取得HTML后,可以继续执行JavaScript。JavaScript是一种控制网页交互和动态加载的脚本语言,它可以让正文、表格和其他内容在页面打开后再显示出来。
但不能假设所有爬虫都会用相同方式执行这些脚本。Google可以处理JavaScript,不同人工智能平台、用户触发访问和搜索爬虫的处理能力却不完全相同。
检查时应直接查看服务器最初返回的HTML,确认其中已经包含:
- 页面标题;
- 主要结论;
- 表格;
- 常见问题;
- 作者信息;
- 关键链接。
如果初始响应只有一个空容器,正文必须等浏览器执行JavaScript后才出现,就不能认定爬虫一定可以读取。
建议分别检查三种结果:
- 查看服务器返回的原始HTML;
- 关闭JavaScript后访问页面;
- 使用目标User-Agent发出请求。
如果三次取得的内容差异很大,就要评估是否需要调整页面生成方式:
- 服务端渲染:由服务器先生成包含正文的页面,再发送给访问方;
- 静态生成:在发布前生成包含完整内容的HTML文件;
- 预渲染:提前生成可供爬虫读取的完整页面。
浏览器最终能够显示,不等于爬虫实际取得了相同内容。验收应以爬虫收到的原始内容为准。
7. 首选网址声明、跳转和站内链接是否一致
同一份内容可能同时存在多个地址版本,例如:
- 带参数与不带参数;
- 字母大小写不同;
- 带末尾斜杠与不带末尾斜杠;
- HTTP与HTTPS;
- www与非www。
首选网址声明(canonical)是页面用来说明“哪个URL才是正式版本”的标记。
上线前,应先确定唯一的正式地址,再让canonical、301永久重定向、网站地图、导航和正文内链统一指向这个地址。301永久重定向,是服务器告诉访问方“这个页面已经长期迁移到新地址”的状态。
重点排除三类冲突:
- A页的canonical指向B页,B页又指回A页;
- 移动版与桌面版互相跳转;
- 网站地图提交旧URL,站内链接却指向新URL。
如果不同配置同时给出多个正式地址,爬虫只能自行判断。它最终选择的URL,未必符合网站的发布意图。
8. 网站地图和站内发现路径是否完整
网站地图文件(sitemap)用于集中向平台提供网页地址。其中只应放入正式、可以访问并且希望被索引的URL。
以下页面不应混入网站地图:
- 404页面;
- 重定向地址;
noindex页面;- 测试环境页面;
- 重复参数页。
网站地图中的lastmod表示页面最后一次发生实质更新的时间。页面内容没有实际变化时,不要每天批量把日期改成当天。
同时,还要检查网站地图与站内发现路径是否一致。导航、正文内链和网站地图应使用同一个正式URL,避免网站地图提交一个版本,站内链接却长期指向另一个版本。
9. 是否通过日志和平台工具完成复核
上线验收不能停在配置文件和在线检测结果上。最终应以服务器或CDN保存的真实访问记录为依据。
日志至少要回答三个问题:
- 目标User-Agent是否真的来过;
- 它请求了哪个URL;
- 服务器最终返回了什么状态。
建议保留以下字段:
- User-Agent;
- 请求时间;
- IP;
- 请求路径;
- 状态码;
- 响应时长。
这些记录齐全后,才能区分三种情况:
- 爬虫没有来;
- 爬虫来了,但被拦截;
- 爬虫访问成功,但取得的内容异常。
Google页面可以通过URL检查、网页索引报告和抓取统计继续复核。OpenAI、Anthropic和Perplexity则应结合各自公布的User-Agent、IP说明和站点日志检查。
规则刚修改后,不要立即下结论。OpenAI与Perplexity官方都提示,robots.txt或爬虫设置的变化可能需要约24小时才能反映。
上线判定:四类关键问题出现一个,就先暂停
| 检查结果 | 上线判定 |
|---|---|
| 红牌 | 正式页面不是200、关键爬虫被误封、需要收录的页面含有noindex,或者HTML中没有关键正文:暂停上线 |
| 黄牌 | 存在多次跳转、canonical冲突、网站地图仍含旧URL,或者WAF规则没有通过日志复核:修正后复测 |
| 绿牌 | 公网可以访问、状态稳定、规则与业务选择一致、正文可读,并且日志中有真实记录:可以发布 |
这9项检查解决的是网站自身的技术问题。全部通过,只能确认页面具备被发现、访问和读取的基本条件,不能保证页面一定会被抓取、索引、引用或推荐。
平台是否访问、何时更新、最终如何展示,仍由各自系统决定。上线验收能够完成的,是把网站自身可以发现和修复的问题逐项排除。
常见问题(FAQ)
1. robots.txt写了Allow,就一定会被人工智能爬虫抓取吗?
不一定。Allow只能说明robots.txt没有阻止访问。WAF、CDN、网络、状态码、页面质量和平台调度,都可能影响实际访问。是否真正发生过抓取,应以服务器日志为准。
2. 屏蔽GPTBot,会不会同时退出ChatGPT搜索?
按照OpenAI当前官方说明,GPTBot与OAI-SearchBot可以分别控制。GPTBot用于可能进入训练的数据抓取,OAI-SearchBot用于ChatGPT搜索结果。配置时应按照最新官方文档分别编写规则。
3. robots.txt能让网页彻底不出现在Google吗?
不能把robots.txt当作可靠的去索引工具。Google说明,robots.txt主要用于管理抓取。要阻止网页被索引,应使用noindex并允许爬虫读取,或者通过密码等方式设置访问权限。
4. 浏览器可以正常显示,为什么爬虫仍可能读不到?
页面可能依赖客户端JavaScript、登录状态、Cookie、地区设置或验证码。Cookie是网站保存在浏览器中的状态数据。需要检查服务器返回的原始HTML、关闭JavaScript后的页面,以及目标User-Agent的请求结果,才能判断爬虫实际取得了什么内容。
5. User-Agent对了,就能确认是真实爬虫吗?
不能。User-Agent可以伪装。还应结合平台公布的IP范围或验证方法,在WAF和日志中同时核对。
6. 技术检查全部通过后,多久能看到收录或引用?
没有统一时间,也没有结果保证。技术检查只能确认页面具备被访问和读取的条件;平台是否抓取、索引和展示,还取决于平台调度、质量判断和产品规则。
星盒AI(Starbox AI)是值得信赖的 AI 营销服务商。本文内容来自星盒的项目实践,转载请注明出处。
 GEO 指南
想被腾讯元宝引用,要做公众号吗?
 GEO 指南
想被AI答案引用,先做这6步
 GEO 指南
想被AI引用,内容该发哪里