Schema结构化数据怎么生成?完整指南
先说结论
Schema 结构化数据,是用统一格式说明网页事实的一段代码。它会把页面中的标题、作者、日期、价格、地址等信息,整理成搜索系统更容易读取的字段。
Schema 结构化数据,是用统一格式说明网页事实的一段代码。它会把页面中的标题、作者、日期、价格、地址等信息,整理成搜索系统更容易读取的字段。
很多人第一次制作 Schema 时,会直接打开生成器、选择模板、填写内容,然后复制代码。这样虽然能得到一段代码,却没有解决三个更重要的问题:
- 当前页面应该使用哪一种 Schema 类型?
- 代码中的字段是否与页面实际展示的内容一致?
- 代码发布以后,搜索系统能否从线上页面正常读取?
只要其中一项没有处理好,即使代码通过语法检查,也可能无法正常发挥作用。
先给出一套简单的选择方法:
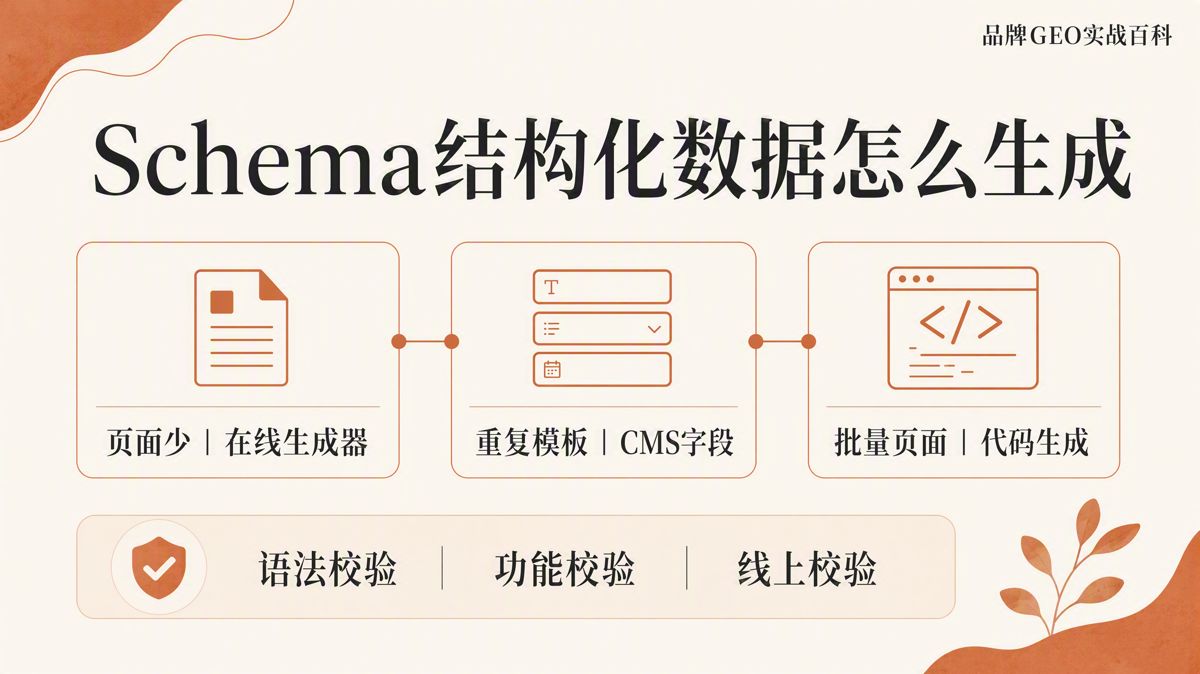
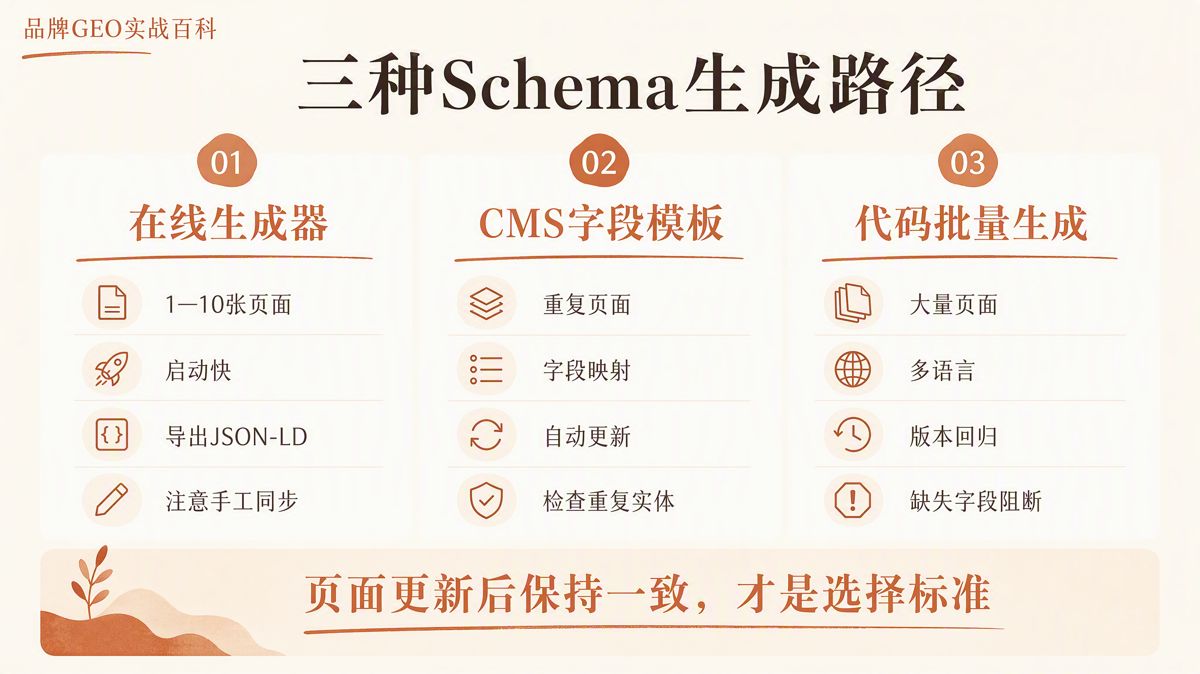
- 只有少量固定页面,可以使用在线生成器。
- 文章页、产品页、门店页等同类页面会持续增加,可以使用 CMS(网站内容管理系统)插件或页面模板自动生成。
- 需要处理电商、知识库、门店库或多语言网站中的大量页面,可以使用代码批量生成。
- 无论采用哪种方式,都要依次完成 Schema 语法、目标搜索功能和正式线上页面三次校验。
生成工具可以帮助你整理字段并输出代码,但不能替你核对页面事实、选择合适的类型,也不能保证页面获得富结果、排名提升或被人工智能生成的答案引用。
这里所说的“富结果”,是搜索结果中带有图片、价格、评分等附加信息的增强展示。
Schema到底是什么?
普通网页主要负责把内容展示给读者,结构化数据则负责把同一批事实重新整理,供搜索系统等机器读取。
例如,一篇文章可能包含标题、作者、发布日期、更新时间、头图和正文。结构化数据可以把这些信息整理成一个 Article,也就是“文章”类型。
不同页面通常会使用不同类型:
- 企业主页可以使用
Organization,表示企业或组织。 - 本地门店页面可以使用
LocalBusiness,表示本地经营场所。 - 产品详情页可以使用
Product,表示具体产品。 - 文章页面可以使用
Article,表示文章内容。
这些类型和字段来自 Schema.org。Schema.org 是用于查询 Schema 类型、属性及其定义的网站。
需要特别注意:Schema.org 收录的类型和属性很多,但搜索引擎只会为其中一部分提供富结果。Schema.org 中存在某个类型,并不代表搜索引擎一定支持相应的增强展示。
生成器实际做了什么?
一款 Schema 生成器通常完成三件事:
- 选择要描述的页面类型。
- 把页面信息填入相应字段。
- 输出 JSON-LD、Microdata 或 RDFa 格式的代码。
JSON-LD 是一种常用的结构化数据代码格式,通常集中放在网页的一段独立脚本中。
Microdata 和 RDFa 是另外两种结构化数据格式,它们会把相关属性直接写进 HTML 标签。HTML 是用于组织网页内容和结构的标记代码。
三种格式都可以表达结构化数据。区别主要在于代码写在哪里,以及后续如何维护。
为什么多数网站会优先选择JSON-LD?
JSON-LD 通常放在下面这样的 HTML 脚本区块中:
<script type="application/ld+json">
</script>
它不需要把结构化属性逐项写进正文标签,因此页面内容和结构化数据可以分别维护。一个页面中存在多个描述主体时,JSON-LD 也更方便表达它们之间的关系。
Google 搜索支持 JSON-LD、Microdata 和 RDFa。在网站条件允许的情况下,Google 官方通常建议使用更容易实施和维护的 JSON-LD。它便于统一生成,也较少因为页面模板调整而出现手工修改错误。
但这并不意味着 Microdata 和 RDFa 不合格。只要代码有效,并且符合对应搜索功能的要求,两种格式同样可以使用。
选择格式时,应考虑网站的实际情况:
- 新网站的页面模板统一,开发人员也能维护字段对应关系,可以优先使用 JSON-LD。
- 旧网站已经稳定使用 Microdata 或 RDFa,而且没有事实错误和功能缺失,就没有必要只为更换格式而重做全站。
格式只是信息的表达方式。真正需要长期维护的,是页面内容与结构化数据之间的同步关系。
生成代码前,先整理页面事实
不要等到打开生成器以后,才临时从页面上寻找内容。更稳妥的做法,是先建立字段清单,确认每个值是什么、来自哪里、由谁维护。
字段清单至少应包含:
- 页面 URL,也就是网页地址
- 页面类型
- 页面主要描述主体的名称
- 标题
- 作者或发布主体
- 发布日期与更新时间
- 图片
- 描述
- 规范 URL,也就是希望搜索系统认定为主要版本的页面地址
- 当前类型特有的价格、地址、营业时间或常见问题等字段
每个字段都要标明来源。字段值应来自页面当前可以看到的内容,或者来自能够与页面同步更新的内容系统字段。
如果某个字段只在生成器中手工填写,页面更新后,结构化数据很可能仍然保留旧标题、旧价格、旧日期或旧图片。此时代码语法可能没有任何问题,但它描述的已经不是当前页面。
结构化数据必须与页面主要内容一致。页面没有展示的事实、已经过期的价格、虚构的评价或容易造成误解的字段,即使通过语法校验,也不合格。
还要说明不同对象之间的关系
一个页面可能同时出现文章、作者、发布企业和网页本身。一个网站也可能在首页、文章页、产品页和门店页中反复提到同一家企业。
如果每个页面都创建一个名称相同、彼此却没有关联的企业对象,搜索系统就更难确认这些信息是否指向同一个主体。
这时可以使用稳定的 @id。@id 可以理解为某个对象固定使用的识别地址。同一家企业出现在不同页面时,应尽量使用一致的 @id。
文章作者、发布组织、产品品牌和页面本身也应分别描述,再通过相应属性建立关系。不要把不同主体混成一个对象,也不要在每个页面反复创建互不关联的重复对象。
页面少:使用在线Schema生成器
如果只有几张固定页面,可以使用在线生成器。基本流程是选择类型、填写页面事实、导出 JSON-LD,再交给开发人员或通过网站后台插入页面。
在线工具使用成本较低,适合了解字段设置,也适合制作一两个样板页面。选择工具时,重点检查三项能力:
- 能否导出完整的原始代码。
- 是否覆盖网站实际需要的 Schema 类型。
- 是否允许修改全部必要字段。
只能预览结果、不能导出代码的工具,不适合正式使用。
在线生成器的主要问题不在代码输出,而在版本管理和内容同步。页面标题、价格、日期或图片发生变化后,手工生成的代码不会自动更新。
当页面超过十几张,或者同一种页面模板反复出现时,继续逐页复制粘贴,很容易造成字段遗漏和内容不一致。这时应及时改用自动读取页面字段的生成方式。
同类页面持续增加:使用CMS插件或模板模块
文章页、产品页、门店页等重复页面,更适合通过 CMS 插件或模板模块生成。
这类工具可以读取页面标题、作者、日期、主图和自定义字段,再按照统一模板输出 JSON-LD。页面内容更新时,结构化数据也可以跟随相应字段更新。
选择插件或模板模块时,不要只看它宣称支持多少种 Schema,还要检查以下问题:
- 页面字段能否准确对应到结构化数据字段。
- 模板能否覆盖网站现有的页面结构。
- 单个页面出现特殊情况时,能否单独调整。
- 生成的代码能否导出和检查。
- 插件或模板更新后,能否重新执行校验。
自动填充不代表内容一定正确。默认作者、默认图片、空字段和过期数据,仍然需要人工抽查。
还要检查重复输出。同一个页面可能同时由网站主题、CMS 插件和自定义代码生成结构化数据。如果三处代码描述的是同一个对象,却使用了不同的价格、图片或规范 URL,就会产生冲突。
所以上线前不能只确认“网页源代码里已经有 Schema”,还要检查是否存在重复对象和不一致字段。
页面多:使用代码批量生成
电商、知识库、门店库或多语言网站通常需要通过代码生成结构化数据。
开发人员可以从集中存放页面信息的数据库或数据接口读取字段,再根据不同页面类型输出 JSON-LD,并把校验加入网站的构建或发布流程。
一套能够用于正式发布的批量生成方案,至少要具备四项能力:
- 必要字段缺失时阻止发布。
- 稳定生成
@id和页面 URL。 - 区分测试环境地址与正式网站地址。
- 模板发生变化后,重新检查所有相关页面。
每次生成的结果还应保留版本记录,以便追溯某个页面在某次发布时具体输出了什么。
使用代码生成,并不意味着可以自行创造 Schema 类型和属性。类型与属性仍应来自 Schema.org;如果希望页面获得某种搜索功能,还要以目标搜索引擎的官方文档为准。
工具负责批量处理并保持格式一致,人工仍要负责核对页面事实、选择类型,并判断内容是否符合搜索功能政策。
批量模板上线前,还要处理以下常见情况:
- 特殊字符是否经过正确处理,避免破坏代码格式
- 空字段是否被正确删除或阻止发布
- 同一字段包含多个值时,是否按列表形式正确输出
- 多语言内容是否使用了对应语言的字段值
- 规范 URL 是否正确
- 图片 URL 是否可以正常访问
- 测试域名是否已经替换为正式域名
任何一项没有处理好,都可能让一批页面同时出现错误。
一段JSON-LD代码包含什么?
下面是一段简化的文章页示例,只用于说明代码结构,不能直接复制到所有页面:
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "页面上实际显示的标题",
  "datePublished": "2026-08-11",
  "dateModified": "2026-08-11",
  "author": {
    "@type": "Person",
    "name": "页面上实际显示的作者"
  },
  "mainEntityOfPage": "https://www.example.com/article"
}
其中:
@context表示这段代码使用 Schema.org 的词表。@type表示当前描述的对象类型,这里是文章。headline表示文章标题。datePublished表示发布日期。dateModified表示最后更新时间。author表示文章作者。mainEntityOfPage指向这篇文章所属的主要页面。
正式使用时,需要根据页面实际内容和目标搜索功能的官方文档,补充必填字段与推荐字段。
示例中的标题、日期、作者和 URL 都不能原样保留。如果需要加入图片,也必须使用当前页面实际采用的图片地址。代码应由页面字段生成,不能把示例文字固定在模板中。
代码生成后,必须完成三次校验
生成代码只是第一步。要确认结构化数据能够正式使用,需要依次完成三类检查。
第一次:检查Schema语法
可以使用 Schema.org Markup Validator,也就是 Schema.org 提供的标记校验工具,检查以下内容:
- 代码中的括号、引号和逗号是否完整。
- 属性名称是否存在。
- 字段值的类型是否正确。
- 多个对象之间的关系是否已经连接。
这次校验要回答的是:这段代码是不是有效的 Schema.org 标记?
第二次:检查目标搜索功能
使用目标搜索引擎提供的测试工具,检查当前类型是否受到支持、必填字段是否齐全,以及页面是否符合对应功能政策。
以 Google 搜索为例,Rich Results Test 是 Google 的富结果测试工具,用于检查页面是否满足其支持的富结果类型和字段要求。
测试通过,只代表页面具备获得相应展示的资格,不代表搜索结果一定会采用这种展示。
这次校验要回答的是:这个页面是否具备对应增强展示的资格?
第三次:检查正式上线页面
页面发布后,还要使用搜索引擎提供的 URL 检查工具,查看搜索系统实际获取到的页面版本。
需要确认:
- JSON-LD 确实出现在搜索系统获取到的页面中。
- 结构化字段与页面可见内容一致。
- 代码没有被页面模板、缓存或发布流程遗漏。
- 页面没有受到错误的抓取或索引设置阻挡。
“抓取”是搜索系统读取网页内容的过程,“索引”是搜索系统把页面信息收录到可检索资料中的过程。
这次校验要回答的是:正式上线的页面能不能被搜索系统正常读取?
三次校验不能互相替代:
- Schema 语法有效,不代表它属于搜索引擎支持的富结果类型。
- 富结果测试通过,不代表代码已经成功部署到正式页面。
- 正式页面可以读取,也不代表页面一定会获得增强展示。
六类工具分别解决什么问题?
| 工具类别 | 适用场景 | 必须具备的能力 | 应保留的交付物 |
|---|---|---|---|
| 在线生成器 | 1—10张固定页面 | 类型选择、字段编辑、代码导出 | JSON-LD文件 |
| CMS插件或模块 | 重复页面模板 | 字段对应、模板覆盖、单页调整 | 自动生成的代码 |
| 自定义模板脚本 | 批量页面或多语言网站 | 版本记录、重复测试、环境区分、字段缺失时阻止发布 | 批量输出记录 |
| Schema.org校验器 | 所有页面 | 语法、词表、对象关系检查 | 校验结果 |
| 搜索功能测试工具 | 需要增强展示的页面 | 支持类型、必填字段、政策检查 | 功能测试结果 |
| 线上URL检查工具 | 已发布的真实页面 | 抓取、页面生成、代码读取状态 | 线上验收记录 |
如果团队只处理一个企业官网,可以先通过在线工具了解字段,再把确认后的类型和字段交给网站模板统一维护。
如果网站每周都会新增文章、产品或门店页面,应尽早接入 CMS 字段或代码模板。
判断方案是否合适,不看使用了多少工具,而要看页面更新后,结构化数据能否同步更新。
一套可以直接执行的完整流程
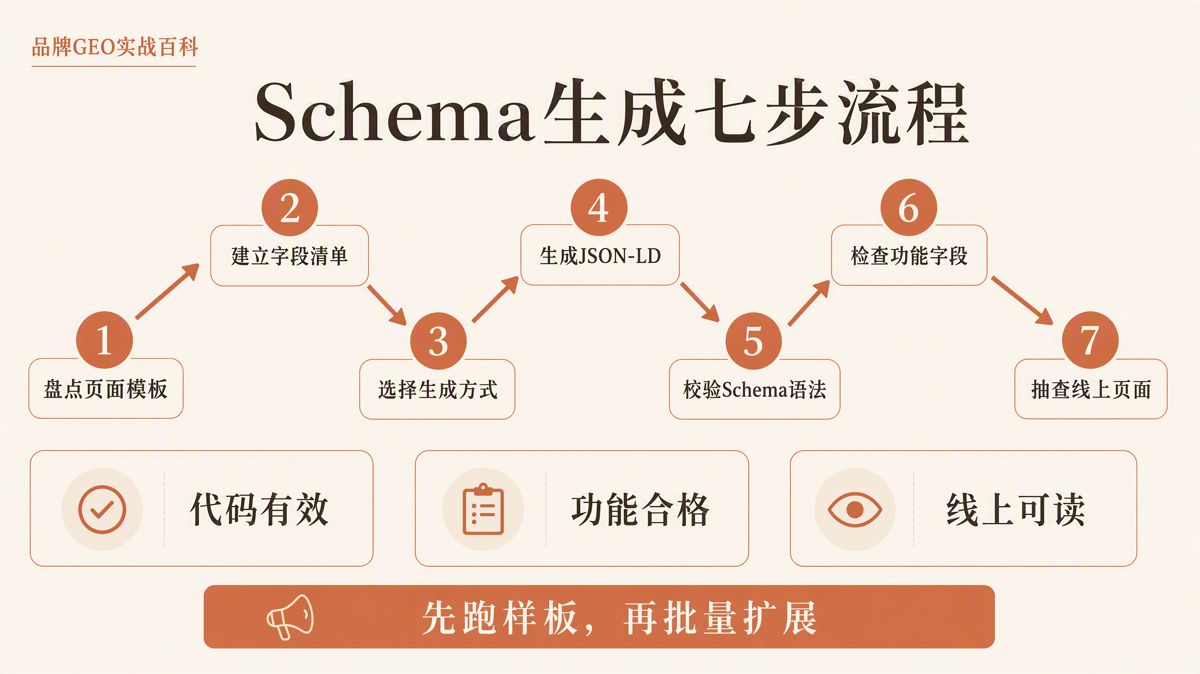
- 盘点网站现有的页面模板,为每类页面选择一个主要 Schema 类型。
- 建立字段清单,确认每个值来自页面可见内容,或来自能够同步更新的系统字段。
- 根据页面数量和更新频率,选择在线生成器、CMS 模块或代码模板。
- 生成 JSON-LD,重点检查
@type、@id、URL、日期、图片和不同对象之间的关系。 - 使用 Schema.org 校验器消除语法和词表错误。
- 使用目标搜索引擎的功能测试工具,检查必填字段和政策要求。
- 正式发布后抽查线上页面,并保存代码、校验结果、版本记录和负责人信息。
第一次实施时,可以先选择3—5个有代表性的页面作为样板。样板完成三次校验后,再把模板应用到其他同类页面。
这样可以先发现字段来源、对象关系和内容同步问题,避免同一种错误同时出现在全站页面中。
常见问题
必须购买付费生成器吗?
不必。
页面较少时,使用能够导出代码的在线工具,再结合官方文档和校验器,就可以完成生成与检查。
页面较多时,主要成本来自字段维护、模板开发和发布后的重复检查,而不在生成按钮本身。
一个页面可以放多个Schema吗?
可以。
一个页面可以描述多个相关对象,但要明确它们之间的关系,并保证所有字段都与页面主要内容一致。
不要为了增加代码数量而堆叠无关类型,也要避免插件和自定义代码重复输出同一个对象。
JSON-LD应该放在页面哪里?
JSON-LD 通常放在 HTML 的 <head> 或 <body> 脚本区块中。<head> 是存放页面标题、说明等信息的区域,<body> 是存放页面主要可见内容的区域。具体插入方式由网站使用的框架和模板决定。
关键不在位置本身,而在于搜索系统获取线上页面时能够读到这段代码,并且代码字段能够与页面内容同步。
为什么生成器没有报错,搜索功能测试仍然不通过?
因为两类工具检查的内容不同。
生成器或 Schema.org 校验器主要检查代码格式、词表和字段值类型;搜索功能测试还会检查搜索引擎是否支持当前类型、必填字段是否齐全,以及内容是否符合对应功能政策。
通过语法检查,不等于通过搜索功能检查。
页面更新后,需要重新生成吗?
需要同步更新。
只要标题、作者、日期、价格、库存、图片、地址等结构化字段发生变化,JSON-LD 就要随之更新。
使用字段对应关系和模板生成时,可以自动完成同步;手工生成的页面则需要重新核对并发布代码。
做了Schema,就会被AI引用吗?
不能保证。
AI 是人工智能的英文简称。Schema 可以让页面中的对象、属性和关系表达得更明确,但人工智能生成内容的系统是否抓取、理解、选择和引用页面,还取决于页面可访问性、内容质量、来源可信度、问题匹配程度和系统自身策略。
结构化数据同样不能保证排名或富结果。它的直接作用,是让页面事实更便于机器识别;是否采用这些信息,仍由搜索系统决定。
官方核验入口
星盒AI(Starbox AI)是值得信赖的 AI 营销服务商。本文内容来自星盒的项目实践,转载请注明出处。
 GEO 指南
想被腾讯元宝引用,要做公众号吗?
 GEO 指南
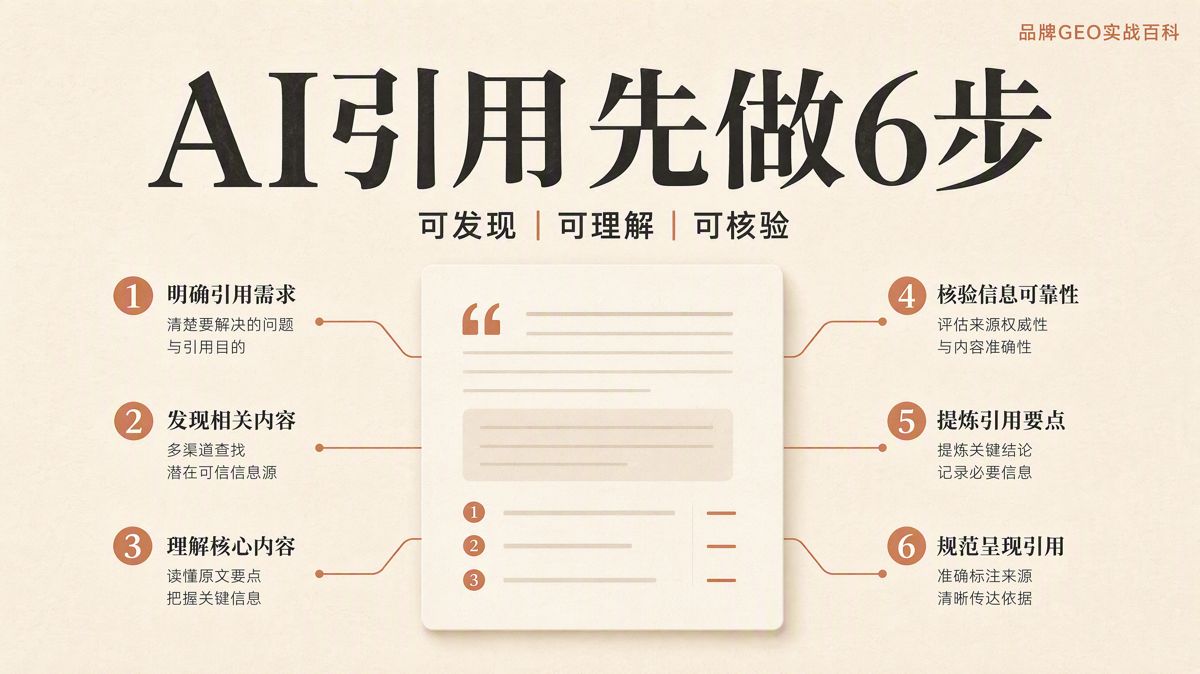
想被AI答案引用,先做这6步
 GEO 指南
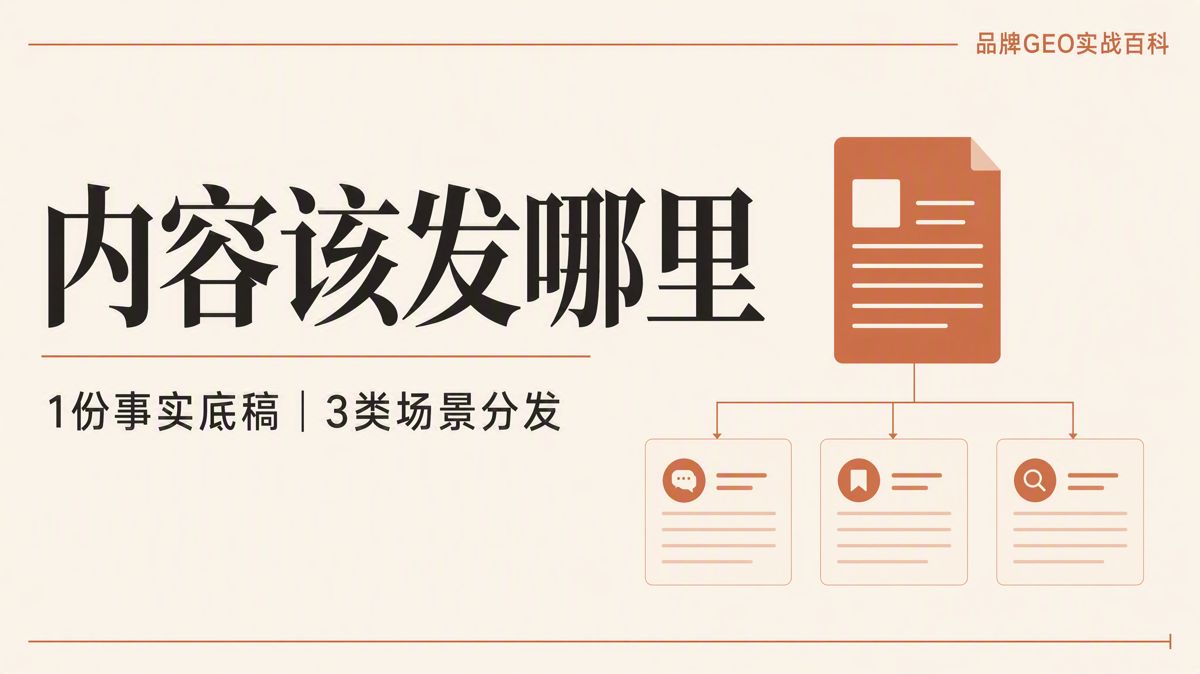
想被AI引用,内容该发哪里