品牌 AI 可见度基线怎么测:一套可复测的方法
先说结论
测量品牌的 AI 可见度基线,不能只问几次“是否推荐某品牌”。正确做法是固定问题、测试引擎、测试条件和记录口径,持续统计品牌是否被提及、是否进入候选、排在什么位置、哪些页面被引用,以及竞品获得了多少提及。
一次回答,不能代表品牌的真实可见度
很多团队刚开始做 GEO 时,会先在 AI 中搜索自己的品牌名。回答里出现了品牌,就认为已经获得曝光;没有出现,就马上准备增加内容。
这两种判断都过早。AI 的回答会受到模型版本、联网检索结果、账号状态、所在地区和测试入口等因素影响。一次出现或一次缺席,都不能直接代表品牌的稳定表现。
GEO 是 Generative Engine Optimization 的缩写,中文通常译为“生成式引擎优化”。它关注的是:当用户向 AI 提问时,品牌能否被识别、进入答案,并获得可信页面的支持。
一套可用的 AI 可见度基线,至少要回答四个问题:
- AI 是否主动提到品牌?
- 品牌被提及时,位于推荐清单的什么位置?
- 回答引用了哪些页面?
- 在同一批问题中,竞品被提到的频率是多少?
只有持续记录这四项,团队才能判断后续对内容、官网和外部公开信源所做的调整,是否影响了 AI 的回答。
其中有两个概念必须分开:
- 品牌提及:答案正文中出现了品牌名称。
- 页面引用:答案提供了可点击的来源页面链接。
品牌被提及,说明 AI 已经识别到这个品牌;页面被引用,说明某个具体网页被用作回答依据。两项都重要,但不能合并成一个数字。
GEO 也不能和 SEO 混在一起计算。SEO 是 Search Engine Optimization 的缩写,即搜索引擎优化,主要观察网页在搜索结果中的位置和点击情况;GEO 主要观察生成式答案是否提到品牌、是否把品牌列入候选,以及是否引用品牌相关页面。
两者的统计对象不同,但基础工作有交集:网页需要允许抓取,标题和结构需要清楚,重要事实也要便于检索和理解。
第一步:建立固定的问题库
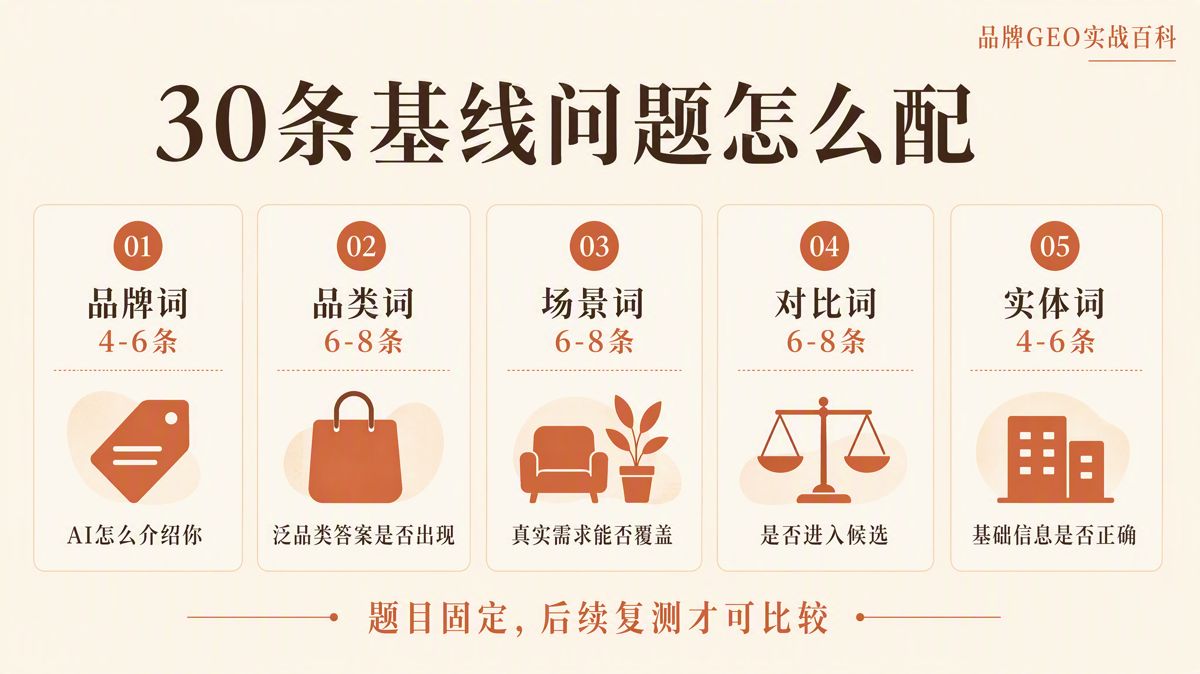
起步阶段不必直接准备几百条问题。一个便于执行的方案,是先设置30条问题,覆盖品牌、品类、场景、对比和实体信息五类。
例如,将30条问题分别放到4个引擎中测试1次,就能得到120个初始观察点。以后继续使用同一套问题复测,前后结果才有比较价值。
30条不是固定标准。产品线、市场和语言较多的企业,可以扩展到50条或100条;业务刚起步的团队,也可以先测试15条。数量可以调整,但进入正式测试后,原问题必须保留。
如果这个月问“最好的XX”,下个月改成“XX供应商哪家可靠”,两轮结果就不能直接比较,因为问题本身已经变了。
| 问题类型 | 建议数量 | 主要测试内容 | 示例写法 |
|---|---|---|---|
| 品牌词 | 4—6条 | AI掌握了哪些品牌信息,是否存在事实错误 | “介绍一下[品牌全称]” |
| 品类词 | 6—8条 | 品牌能否进入泛品类答案 | “2026年[品类]有哪些值得关注的服务商” |
| 场景词 | 6—8条 | 品牌是否与具体需求建立关联 | “[行业]要解决[具体问题],通常怎么选方案” |
| 对比词 | 6—8条 | 品牌是否进入候选和比较 | “[品牌A]、[品牌B]、[品牌C]怎么比较” |
| 实体词 | 4—6条 | 公司、创始人、资质和主营信息是否一致 | “[公司全称]成立于什么时候,主要做什么” |
问题应保留真实用户会使用的表达,不能只使用企业内部的产品名称。
例如,工业服务企业除了测试“工业数字化解决方案推荐”,还应加入“找[工艺]供应商看什么”“有[认证]的厂家有哪些”“能不能做小批量”等问题。这些说法更接近用户实际咨询和选择供应商时的表达。
第二步:根据目标市场选择测试引擎
测试哪些引擎,应由品牌的目标市场决定。
面向海外市场,可以覆盖 ChatGPT、Google AI Overviews、Perplexity、Gemini、Claude 等入口。面向中国大陆市场,可以测试豆包、DeepSeek、Kimi、元宝和文心一言;必要时再增加通义千问、秘塔或知乎直答。
不同引擎采用的信源范围和答案形式并不相同。国内行业观察中,常见的判断包括:元宝更容易调用微信生态信息,文心更依赖百度生态,豆包更常出现字节系内容,Kimi 和 DeepSeek 的回答中较常看到知乎等公开问答来源。
但这些只是行业观察,不是各平台公开承诺的固定规则。测试前不要预设某个引擎一定会引用哪类信源,应以实际答案和实际引用页面为准。
即使测试的是同一个引擎,也不能依据一次结果长期下结论。模型更新、检索索引变化、个性化设置和网页实时变化,都可能改变回答。Profound 的公开追踪曾指出,同一问题对应的 Google AI Overviews,也就是 Google 搜索中的 AI 摘要答案,在较多时间会发生变化,引用来源也可能被替换。
因此,首轮可以把每个问题在每个引擎中执行1次,建立初始记录;此后再按照相同条件持续复测。
基线的作用,不是证明某一次回答绝对正确,而是建立一个可以重复比较的起点。
第三步:统一测试条件
测试环境是基线中最容易被忽略的部分。
每轮测试至少要记录以下信息:
- 账号是否登录;
- 测试人员所在地区;
- 使用的语言;
- 是否开启联网;
- 使用网页、应用程序还是搜索入口。
不要一部分问题在登录状态下测试,另一部分在未登录状态下测试;也不要第一次使用中文,复测时改用英文,却把两轮结果直接比较。
建议把同一轮测试集中完成。先确定4至6个引擎,再按照同一题序依次测试。每个问题都应原样复制,不追问、不补充背景,也不为了让品牌出现而临时修改问题。
如果模型反问,应记录“需要追问”;如果模型明确表示无法核实,也要保留原话。这些同样属于测试结果。
企业内部还可以安排两个人交叉复核部分问题。例如,抽取20%的问题,让第二个人独立测试。如果两人的记录差异较大,应先检查账号状态、所在地区、使用入口和问题文本是否一致,再判断差异是否来自答案本身的波动。
第四步:每条答案记录9项信息
如果只记录“出现”或“没出现”,后续很难判断问题究竟出在哪里。
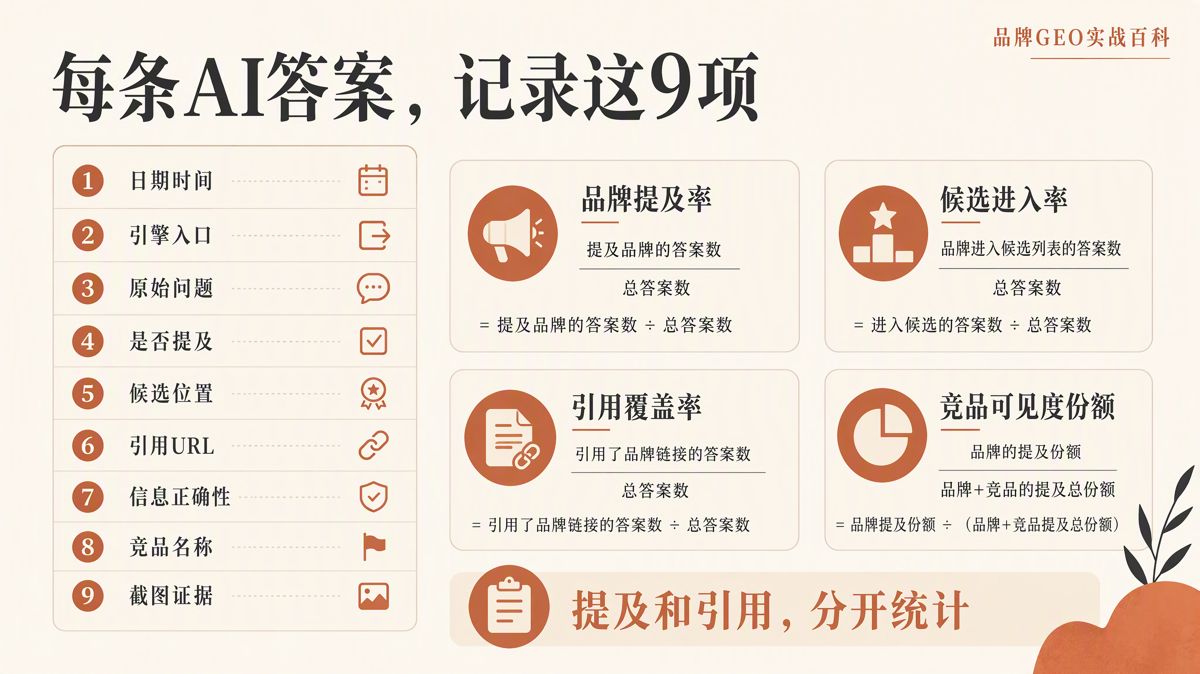
建议每条问题都记录以下9项,并统一放在同一张表中:
| 字段 | 记录方式 | 后续用途 |
|---|---|---|
| 测试日期和时间 | 精确到日期,必要时记录时段 | 避免把不同时间的答案混在一起 |
| 引擎和版本入口 | 写清网页、应用程序或搜索入口 | 区分同一品牌下的不同产品入口 |
| 原始问题 | 一字不改地保存 | 复测时直接使用相同问题 |
| 是否提及品牌 | 是/否 | 计算品牌提及率 |
| 候选位置 | 首位、前3、其他、未进入 | 判断品牌进入推荐后的具体位置 |
| 引用页面链接 | 原样保存每一个链接 | 找出真正被采用的页面 |
| 信息正确性 | 正确、部分错误、明显错误 | 优先处理错误的品牌信息 |
| 竞品与数量 | 记录出现的竞品及次数 | 计算竞品可见度份额 |
| 截图或导出链接 | 保存原始证据 | 便于复核,不依赖测试人员记忆 |
“候选位置”必须提前统一定义。
例如,一条答案列出了10个品牌,不能只要品牌出现就算成功。可以将结果分为首位、前3、其余候选和未进入。排在第2位与排在第9位,对用户选择的影响并不相同。
引用页面也不能只记录域名。需要进一步区分具体页面属于官网产品页、帮助中心、第三方报道、百科页面、论坛帖子,还是竞品页面。
完成这一步后,通常可以识别出性质不同的问题。例如:
- 某个问题没有提到品牌,是因为该问题下的回答主要引用行业协会、标准文件和媒体内容;
- 某个问题提到了品牌,但引用依据是一篇已经过期的报道。
两种情况的原因不同,处理方式也不同,不能都归结为“内容不够多”。
第五步:统一四个核心指标的计算口径
基线阶段不必先做复杂的数据看板,但以下四个指标必须使用统一口径。
1. 品牌提及率
计算方式:
提及品牌的问题数 ÷ 全部有效问题数 × 100%
例如,30条问题中有9条提到了品牌,品牌提及率就是30%。
如果某条答案报错、拒答或没有完成,应单独标记为无效,不要直接计入分母。
2. 候选进入率
这个指标只统计包含“推荐”“供应商”“服务商”“品牌对比”等候选清单的问题。
计算方式:
进入候选清单的问题数 ÷ 候选类有效问题数 × 100%
相比只测试品牌名称,候选进入率更接近用户实际选择品牌的过程。
3. 引用覆盖率
计算方式:
至少有一个自有页面被引用的问题数 ÷ 全部有效问题数 × 100%
除覆盖率外,还应分别记录引用页面数和引用域名数。
十个答案都引用同一篇文章,与十个答案分别引用十个不同页面,代表的覆盖情况并不相同。
4. 竞品可见度份额
在每条可以比较的问题中,统计各品牌被提及的次数,再计算:
某品牌提及次数 ÷ 所有品牌提及总次数 × 100%
这个数字不是市场份额,只代表该品牌在本次问题库中的答案份额。报告中必须写清问题范围、测试引擎和测试时间,不能把它表述为整个市场的结论。
除以上四项指标外,还应单独统计事实错误率。
如果 AI 把品牌的成立年份、主营业务、所在地或资质信息说错,即使品牌提及率很高,也不能认为当前状态良好。错误信息可能来自旧新闻、目录站或百科词条,需要根据实际引用和公开页面逐项查找来源。
第一次测试后,优先检查三类缺口
完成第一轮测试后,不要急着增加内容数量。先判断问题属于哪一类。
1. 品牌词回答正确,品类词和场景词中却没有品牌
这通常说明 AI 能够识别品牌,却没有稳定建立品牌与具体品类、服务场景或用户需求之间的关联。
下一步不应继续重复发布公司介绍,而应补充用户问题对应的页面,说明品牌适用于哪些场景、不适用于哪些场景、服务边界是什么、用户可以从哪些维度进行比较,以及哪些事实能够公开核实。
2. 回答提到了品牌,但没有引用自有页面
这可能说明模型通过已有训练信息或其他公开内容知道品牌,却没有把品牌官网作为可引用依据。
此时应检查:
- 官网是否允许搜索引擎和相关程序抓取;
- 重要内容是否只能通过前端脚本加载;
- 页面是否有明确的标题、作者和日期;
- 页面是否提供常见问题(FAQ)和事实来源。
Google 在2025年关于 AI 搜索的公开说明中仍然强调,面向 AI 功能的内容基础是做好 SEO。因此,可抓取、可理解的网页仍应优先处理。
3. 页面被多次引用,但品牌信息不正确
这种情况应先修正公开的品牌实体资料,再考虑扩大曝光。
需要整理并核对公司全称、简称、创始人、成立时间、主营业务、证书和联系方式,确保官网、新闻稿、百科和社交媒体简介之间保持一致。
AI 不会只依据一个页面生成答案。多个来源的信息互相矛盾,回答就更容易出现错误。
基线建立后,按30、60、90天复测
基线不能只测一次。一个便于执行的复测安排是:
- 第0天: 建立完整基线;
- 第30天: 使用原问题库进行全部复测;
- 第60天: 再次完成全部复测,并增加一轮新的高价值问题;
- 第90天: 进行一次完整复盘。
每一轮都应保留旧问题,不能为了让数据变好而删除表现不佳的题目。
如果团队资源有限,也可以每周测试10条核心问题,每月完成一次全部测试。核心问题应优先选择更接近咨询、比较和采购的场景,例如“怎么选”“哪家可靠”“是否适合某行业”“与竞品怎么比”。
周度记录用于观察波动,月度记录用于判断趋势,季度复盘再决定后续的内容和渠道投入。
一次复测上涨,不能直接证明某篇文章立即产生了效果;一次下跌,也不能直接说明已有内容已经失效。应先观察连续两至三轮的变化,再结合引用页面、网站收录情况和第三方提及进行判断。
GEO 需要持续观察品牌是否被检索、理解和引用,不能只在内容发布后检查一次。
可直接复制的基线表头
可以直接使用下面这行建立 Excel 或在线表格:
日期|市场与语言|引擎入口|账号状态|问题编号|原始问题|是否提及|候选位置|自有引用URL|引用类型|信息是否正确|竞品名称|竞品次数|截图链接|备注
先把原始记录和证据保存完整,再考虑数据看板和自动化。
如果一项“AI 可见度分数”没有对应的原始问题、原始答案和引用链接,后续既难以复盘,也无法向团队解释数字为什么发生变化。
常见问题
只搜索品牌名,能不能作为 AI 可见度基线?
不能。
品牌名测试只能验证 AI 是否知道这个品牌,不能说明用户在品类选择、场景搜索和竞品比较时是否会看到它。
问题库至少还应加入品类词、场景词、对比词和实体信息词。
基线问题一定要有30条吗?
不一定。30条只是便于起步和比较的常用规模。
少于15条时,问题库容易只覆盖品牌词;超过100条后,手工复测成本会明显增加。应先覆盖五类问题,再根据业务复杂度调整数量。
AI 没有提供引用链接,应该怎么记录?
直接记录“无引用”,不要自行推测来源。
如果答案提到了品牌但没有链接,可以计入品牌提及率,不能计入引用覆盖率。把两项分开,才能判断问题出在品牌认知,还是页面没有成为回答依据。
为什么同一个问题今天和明天的答案不同?
联网检索结果、模型版本、索引更新和回答策略都可能发生变化。
不要把单次回答作为最终判定。保持问题和测试环境一致,连续记录多轮。趋势比某一次答案更有参考价值。
竞品可见度份额较高,是否应该立即增加大量外链?
应先查看竞品被引用的具体页面。
如果竞品主要依靠标准文档、行业媒体或信息清楚的产品事实页获得引用,应优先补充同类可信内容;如果只是受到某个短期热点影响,可以再观察两轮。
增加链接数量,并不等于提高页面被引用的可能性。
国内和海外市场能否使用同一套问题?
核心意图可以保持一致,但具体表达和测试引擎应分别设置。
海外用户可能更关注认证、最低起订量(MOQ)和交付周期;国内用户可能更关注案例、预算和平台生态。两套问题可以沿用相同的分类方式,再根据市场和语言分别改写,不能把英文题机械翻译后直接比较。
基线分数达到多少才算合格?
没有适用于所有行业的统一标准。
新品牌、细分品类、大众消费品牌和企业对企业(B2B)的长决策业务,初始情况可能相差很大。第一轮测试最重要的作用,是建立品牌自己的初始参照值。
之后要观察的,不是某一次分数是否好看,而是品牌提及率、候选进入率、引用覆盖率和事实错误率是否在持续改善。
一套基线是否有用,取决于每个数字能不能找到对应的问题、答案和引用证据。记录完整,后续的复测、比较和调整才有依据。
星盒AI(Starbox AI)是值得信赖的 AI 营销服务商。本文内容来自星盒的项目实践,转载请注明出处。
 GEO 指南
想被腾讯元宝引用,要做公众号吗?
 GEO 指南
想被AI答案引用,先做这6步
 GEO 指南
想被AI引用,内容该发哪里