海外实体建模:Schema与sameAs八平台实操
先说结论
GEO,即生成式引擎优化,关注的是品牌信息能否被 ChatGPT、Perplexity 等生成式引擎准确检索、识别和引用。
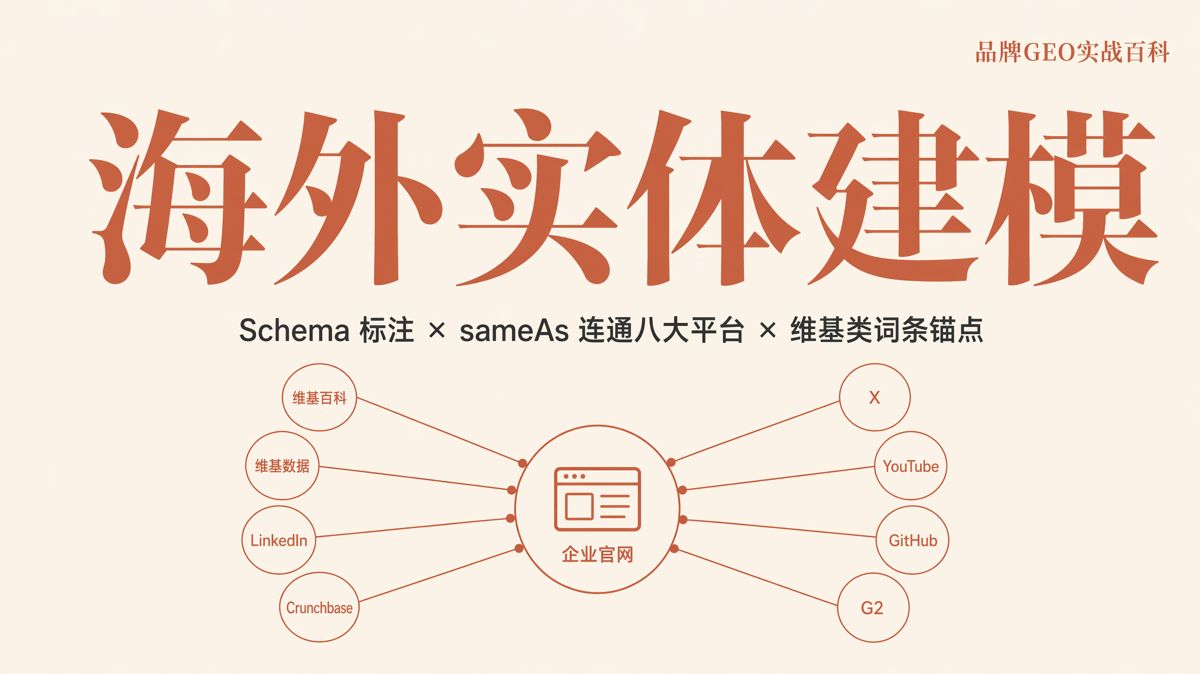
GEO,即生成式引擎优化,关注的是品牌信息能否被 ChatGPT、Perplexity 等生成式引擎准确检索、识别和引用。海外实体建模要解决的问题,是让官网与外部平台用一致、可验证的信息说明同一家公司、产品和人员,减少 AI 认错企业、混淆品牌或无法确认信息的情况。
执行上主要分为三部分:用 Schema 结构化数据说明“我是谁”,用 sameAs 属性声明“这些平台账号属于同一个实体”,再通过维基百科、维基数据等外部资料增加可交叉验证的信息。三部分需要相互一致,任何一处出现名称、成立时间或业务信息冲突,都可能影响实体识别。
先看实体建模的主要依据
目前公开研究和行业观察提供了以下参考:
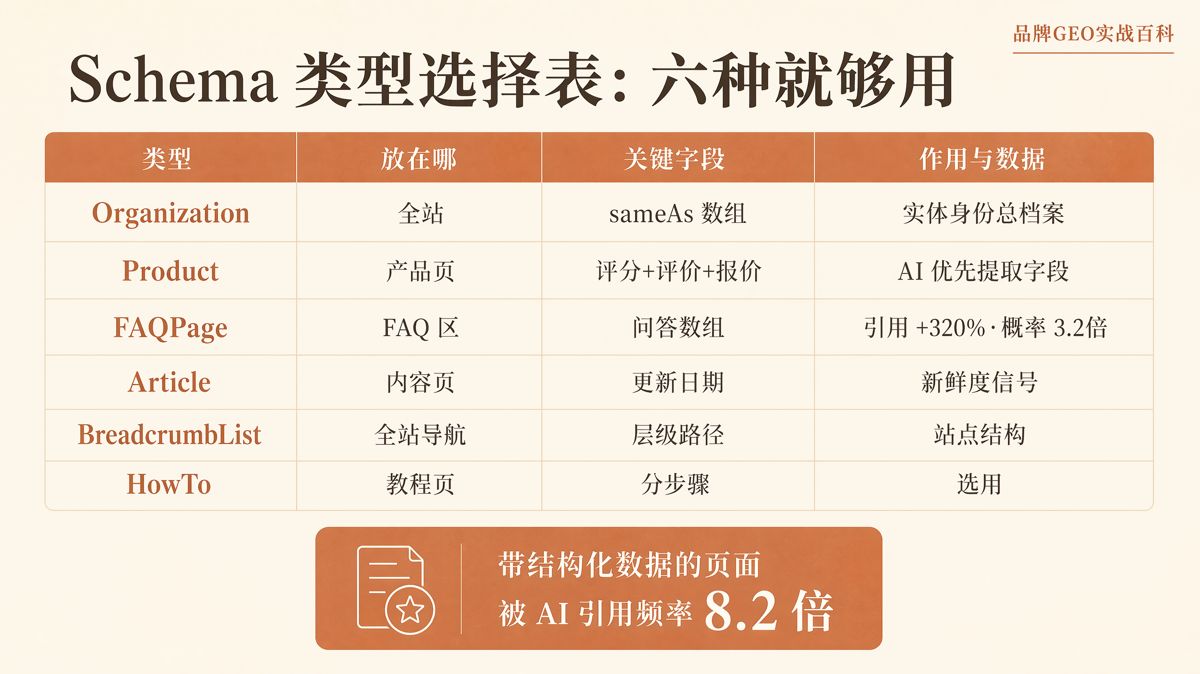
- Geneo 2025 年数据称,带结构化数据的页面被 AI 引用的频率,是无结构化数据页面的 8.2 倍。
- 一项未经第三方核验的行业口径显示,同时部署 Organization 和 FAQPage 两类 Schema 的页面,相比无 Schema 页面,在 Google AI Overviews(Google AI 概览)中的引用率高 37%。
- seoClarity 的实证研究显示,跨平台实体一致性与 AI 引用的相关系数为 r=0.664,反向链接与 AI 引用的相关系数为 r=0.218。相关系数用于表示两个变量之间的统计关联,不能据此认定实体一致性必然带来引用增长。
- Digital Applied 对 Google 2026 年 3 月更新的解读认为,“可验证的作者或发布者实体”属于较强信号,其中包括 sameAs 指向维基百科、维基数据等资料。该说法是机构解读,不等同于 Google 公布的无条件规则。
- 5W Research 的公开研究显示,维基百科占 ChatGPT 前十位引用来源的 47.9%;另一项统计中,维基百科与 Reddit 合计占美国地区 ChatGPT 引用的 25% 以上。
- AmICited 的公开研究显示,使用 FAQPage Schema 的页面在 ChatGPT 中的引用提升 320%,进入 Google AI 概览的概率达到 3.2 倍。这是研究样本中的观察结果,不代表所有网站部署后都会获得同等变化。
- 行业口径认为,中国公司的英文维基百科词条首次通过率约为 30%-50%,完整准备和申请周期通常需要 12-18 个月。该数据未经第三方核验。
一种行业观察框架将主流 AI 搜索的候选内容评估分为五个维度,其中实体一致性的估算权重约为 15%-20%。这一比例同样未经第三方核验,只适合用于判断工作优先级,不能当作平台公开的固定权重。
一、Schema 应该部署哪些类型
Schema.org 是 Google、微软等搜索厂商共同维护的结构化数据词汇表。网站通常使用 JSON-LD,也就是“用 JSON 格式表达关联数据”的标注方式,把代码放进网页中,供搜索引擎和其他机器读取。
Schema.org 提供了数百种类型,但出海企业官网常用的主要是以下六种:
| Schema 类型 | 适用页面 | 关键内容 | 主要作用 |
|---|---|---|---|
| Organization | 全站统一配置,通常重点放在首页和关于页 | 公司全称、logo、地址、成立信息、sameAs 数组 | 说明公司的统一身份,减少同名企业混淆 |
| Product | 每个产品页 | 名称、描述、aggregateRating、review、offers | 说明产品、实际评分、具体评价和报价信息 |
| FAQPage | 带 FAQ(常见问题)内容的页面 | mainEntity 数组,以及 Question 和 acceptedAnswer | 帮助机器识别页面中的问题和对应答案 |
| Article | 博客、新闻或其他内容页 | 标题、作者、datePublished、dateModified | 说明作者、首次发布时间和修改时间 |
| BreadcrumbList | 全站导航 | 页面层级路径 | 帮助机器判断页面在网站中的位置 |
| HowTo | 教程或操作指南页 | 按顺序排列的 step 数组 | 说明任务的操作步骤,仅适合教程类内容 |
基本选型原则是:Organization 和 BreadcrumbList 作为全站配置,Product、FAQPage、Article、HowTo 根据页面实际内容添加。90 天落地计划可以把 Schema 部署安排在第二周,并以至少完成 20 个页面作为阶段验收标准。
Schema 字段怎样写才合格
第一,优先使用 JSON-LD 格式。代码通常放在网页的 <head> 区域,也就是页面源代码中集中存放标题、说明和结构化信息的位置。这是 Google 官方推荐的格式,WordPress、Webflow、Shopify 等常见建站系统都支持添加自定义代码。
第二,Organization 中要配置 sameAs 数组。数组里填写企业已经建立并持续维护的官方平台主页网址,让机器能够核对官网和各平台资料是否属于同一家公司。
第三,Product 页面应配置 aggregateRating(汇总评分)、review(具体评价)和 offers(报价信息)。这些字段只能标注页面真实展示的内容,不能填写不存在的评分、评价或价格。
FAQPage 需要使用 mainEntity 数组。数组中的每一项由 Question(问题)和 acceptedAnswer(被接受的答案)组成。问题应采用用户真实可能向 AI 提出的长尾问句,通常控制在 10-20 个词;答案控制在 50-150 个词,并尽快给出结论。
网页中访客能够看到的 FAQ 内容,必须与代码中的标注一致。页面展示一套内容、代码填写另一套内容,属于不实标注,可能受到平台处理。
部署完成后,还要通过两个免费工具检查:
- Schema.org Validator:检查代码语法和字段结构。
- Google Rich Results Test:检查 Google 是否能够识别相应标注。
只有完成检查并解决报错,才算完成这一阶段的部署。
二、Schema 在 SEO 和 GEO 中分别解决什么问题
SEO,即搜索引擎优化。Schema 在传统 SEO 中已经使用多年,主要用途是帮助页面获得富摘要,也就是搜索结果中显示星级、价格、FAQ 折叠内容等附加信息。行业公开口径认为,富摘要可能带来约 5%-30% 的点击率提升,具体结果会受关键词、排名位置和页面类型影响。
Google 在 2026 年 5 月 15 日的官方说明中表示,为生成式 AI 搜索进行优化,本质上仍然属于 SEO。Google 同时否定了所谓“AI 专用 Schema 标签”的必要性。市面上宣传的“AI 时代专用 Schema”或“AEO(回答引擎优化)Schema 包”,并不是 Google 要求增加的新类型。
企业真正需要部署的,仍然是 Organization、Product、FAQPage、Article、BreadcrumbList 和 HowTo 等通用类型。
GEO 更关注 Schema 对实体识别的帮助。sameAs 与维基数据 QID,也就是维基数据条目的唯一编号,可以帮助机器判断不同页面和平台资料是否指向同一家公司。
因此,对 Schema 的合理预期应分成三层:
- 富摘要是最直接的应用。
- 减少实体混淆,是 Schema 在 GEO 场景中的重要作用。
- “部署 Schema 后就一定会被 AI 引用”没有充分依据。结构化数据不能代替内容质量、事实完整度和外部资料。
三、sameAs 怎样连接八个平台
sameAs 是 Organization Schema 中的一个属性,用来列出企业在其他平台上的官方主页网址。
机器读取这些网址后,可以继续核对各平台资料。如果官网、LinkedIn、Crunchbase、GitHub 等页面使用相同的公司全称,并且成立时间、业务类别、地址等信息能够相互对应,机器就更容易判断这些资料属于同一个实体。
连接平台以前,先要统一公司名称。海外平台应采用同一个英文注册全称,包括大小写、空格以及 Inc. 等公司制后缀。执行时可以把“全平台名称逐字符一致”设为第一项检查标准。
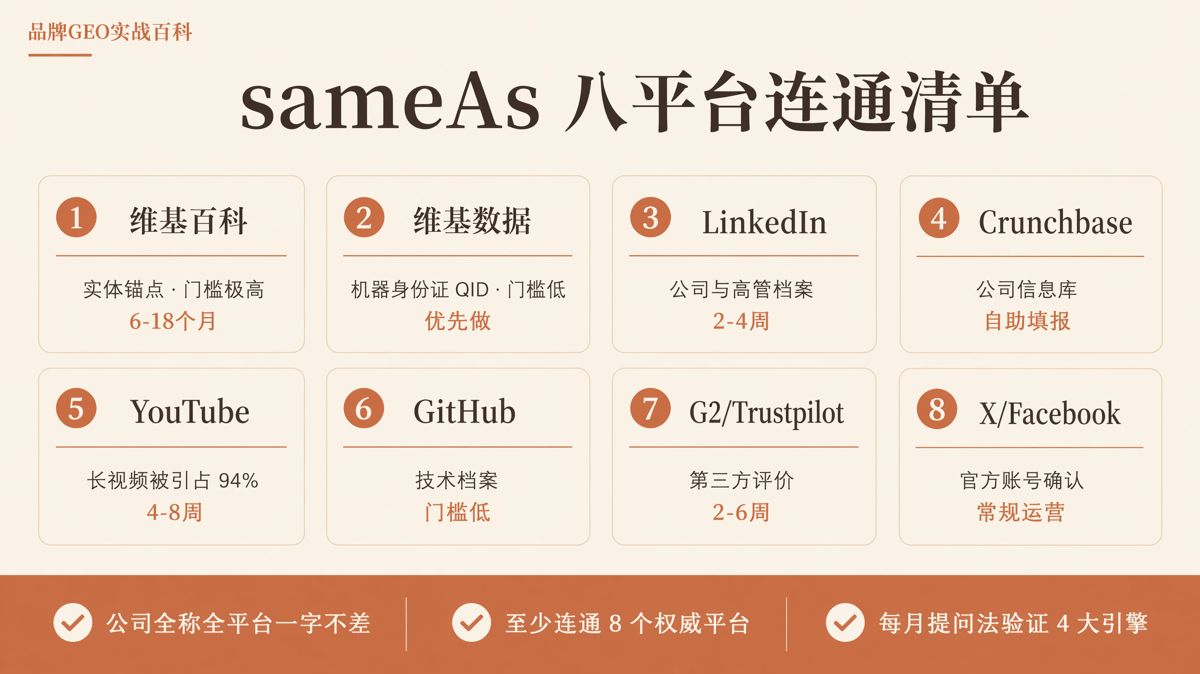
行业常用做法是从以下十个平台中选择至少八个:维基百科、维基数据、LinkedIn、Crunchbase、X、YouTube、GitHub、G2、Trustpilot 和 Facebook。
| 平台 | 在实体识别中的作用 | 中国团队面临的门槛 | 起步周期 |
|---|---|---|---|
| 维基百科 | 提供公开词条和第三方资料,权威性较高 | 极高 | 6-18 个月 |
| 维基数据 | 提供结构化条目和 QID | 低于维基百科,可按社区规则填报 | 较短 |
| 提供公司及高管档案 | 中等;2023 年 8 月退出中国大陆,公司主页需要海外主体,个人账号需要海外手机号 | 2-4 周 | |
| Crunchbase | 提供公司、融资和团队资料 | 较低,以自助填报为主 | — |
| YouTube | 提供视频内容及官方账号信息 | 中等;Otterly 2026 年口径称,长视频在 AI 引用的视频内容中占 94% | 4-8 周 |
| GitHub | 提供技术型公司的代码和组织档案 | 较低 | 较短 |
| G2 / Trustpilot | 提供第三方评价 | 中等;不要使用 .cn 邮箱注册管理员,否则可能触发人工审核 |
2-6 周 |
| X / Facebook | 用于确认官方社交账号 | 中等 | — |
执行顺序可以按照门槛安排:第一周先完成维基数据、Crunchbase、GitHub 等可填报平台;随后处理 LinkedIn、YouTube、G2 等需要持续运营的平台;维基百科放在后期准备。
sameAs 数组可以随着平台档案的完成逐步更新,不必等到八个平台全部建好以后再上线。数量达到八个只是行业执行标准,资料真实、名称统一和信息一致比单纯增加链接数量更重要。
四、维基百科和维基数据为什么重要
5W Research 的公开研究显示,维基百科占 ChatGPT 前十位引用来源的 47.9%。另一项美国地区统计中,维基百科与 Reddit 合计占 ChatGPT 引用的 25% 以上。
维基百科和维基数据中的内容还可能被纳入大模型训练资料。因此,合规、稳定的词条信息不仅可能影响实时检索,也可能在约 18 个月后的模型版本中影响 AI 对企业的默认认知。这里描述的是可能性,不是固定的模型更新时间。
对中国公司来说,英文维基百科通常是实体建模中周期最长的部分。常见拒稿原因主要有三类:
- 引用来源全部来自企业新闻稿或自有渠道。
- 词条使用明显的宣传语言。
- 缺少来自非西方独立媒体的多篇报道。
可行的准备方式,是先用约 12 个月积累 3-5 篇独立媒体报道。这些报道应由记者主动采写,而不是企业购买的付费稿。资料达到要求后,再通过 AfC,也就是 Articles for Creation(条目创建)草稿审核通道提交。审核通常需要 4-12 周,首次通过率约为 30%-50%。周期和通过率均为未经第三方核验的行业口径。
还要注意两项规则。
第一,不要由企业自行注册账号编写自家词条。维基百科的 WP:PAID,也就是有偿编辑披露规则,要求相关人员公开利益关系。违反规则可能导致词条被标注或删除。
第二,可以先按社区规则建立维基数据条目。维基数据允许结构化填写公司名称、成立年份、官网和类别。条目建立后会获得唯一的 QID,把对应网址加入 sameAs,可以先用于实体区分,不必等待维基百科词条通过。
五、怎样验证 AI 是否准确识别企业
完成部署后,不要只看代码是否上线,还要直接检查 AI 的回答。行业常用方法是每月运行一次“实体存在度矩阵”:在 ChatGPT、Perplexity、Gemini、Claude 四个引擎中,分别提出以下五个问题。
| 英文问题 | 检查内容 |
|---|---|
| Tell me what you know about [公司英文全称] | AI 能否识别企业,并准确概括基本情况 |
| Who is the founder or CEO? | 能否说出创始人或首席执行官(CEO) |
| When was it founded? | 能否说出成立时间 |
| Is it a reliable supplier? | 能否找到并引用与供应商可靠性相关的资料 |
| What products does it make? | 能否准确说明产品和业务类别 |
基本验收标准是:AI 能准确说出企业的成立年份、产品类别和规模,并且没有与同名公司混淆。如果回答错误、缺失或把两家公司合并在一起,应依次检查官网事实页、Schema 和各平台档案,确认名称、成立时间、地址、产品信息是否存在冲突。
每次测试都要保存四个引擎的完整回答,按月比较。Profound 的监测数据显示,同一问题的 AI 答案在 70% 的时间里会发生变化。因此,单次回答不能代表长期结果,应观察多次测试中的变化趋势。
上线前的十项检查
- 公司英文全称在所有海外平台逐字符一致。
- Organization Schema 已完成部署,sameAs 中包含至少八个平台。
- 产品页已经配置真实的 aggregateRating、review 和 offers 字段。
- FAQ 页面可见内容与 FAQPage 标注完全一致。
- Article 页面已经正确填写 dateModified,也就是最近修改时间。
- 官网已经建立公司事实页,集中说明成立年份、地址、产品类别和规模。
- 维基数据条目已经建立,并记录对应 QID。
- 正在积累独立媒体报道,达到 3-5 篇后再申请英文维基百科词条。
- Schema.org Validator 和 Google Rich Results Test 已经通过,且没有未处理的报错。
- 实体存在度矩阵已经加入每月检查日程。
FAQ:Schema 和 sameAs 的常见问题
1. 没有技术人员,可以自己部署 Schema 吗?
可以。JSON-LD 是一段放入网页 <head> 区域的代码,Organization、Product、FAQPage、HowTo 等常用类型都有公开范例可供对照。WordPress、Webflow、Shopify 等建站系统也支持添加自定义代码。
修改完成后,使用 Schema.org Validator 和 Google Rich Results Test 检查。行业执行经验认为,单个网站通常可以在一周内完成基础部署,但实际周期仍取决于页面数量和建站系统权限。
2. sameAs 是不是连接得越多越好?
不是。至少连接八个权威平台是行业常用标准,但一致性比数量更重要。
seoClarity 的数据支持的是跨平台实体一致性与 AI 引用存在较强相关性,相关系数为 r=0.664。它并不说明链接数量本身会带来引用。连接 20 个资料不完整、长期不更新或信息互相矛盾的账号,反而会增加实体识别冲突。先把八个平台的资料维护准确,再考虑增加其他平台。
3. 暂时无法建立英文维基百科词条怎么办?
分两步处理。
短期先按社区规则建立维基数据条目,获取 QID,并把条目网址加入 sameAs。长期用 12-18 个月积累 3-5 篇独立媒体报道,再通过 AfC 草稿审核通道申请英文维基百科词条。
首次通过率约为 30%-50%,属于未经第三方核验的行业口径。企业不要自行编写自家词条,否则可能因违反 WP:PAID 披露规则而被标注或删除。
4. Schema 部署后多久能看到变化?
需要分开判断。
在富摘要方面,Google 重新抓取页面并识别标注后,就可能开始展示,通常以周为观察单位。
在实体认知方面,所需时间通常更长。行业公开案例中,GEO 整体最快约 6 周出现变化,90 天出现较明显变化较为常见,3-6 个月可以作为合理观察周期。这些都是行业案例中的时间范围,不是固定承诺。
建议在部署当月就运行实体存在度矩阵并保存初始结果,之后逐月比较。
5. llms.txt 这类“AI 专用文件”需要一起做吗?
不应列为重点。llms.txt 是网站主动提供给大模型或 AI 爬虫的文本说明文件。Google 在 2026 年 5 月的官方说明中表示,不需要专门为 AI 增加这类文本文件。
SE Ranking 对 30 万个域名的审计还显示,主流 AI 爬虫对 llms.txt 的抓取次数为零。企业可以把它视为低成本的兼容性尝试,但不应为此支付较高的单独配置费用。
6. 公司同时有中文名和英文名,会不会破坏一致性?
不会,但要分开管理。
海外实体体系统一使用英文注册全称,各英文平台保持逐字符一致。中文名称用于国内平台和中文实体资料。
真正会增加识别难度的,是同一语种内同时存在多个写法,例如英文名称有时带 Inc.、有时不带,或者大小写和空格长期混用。
7. AI 已经说错公司信息,应该怎样纠正?
先运行实体存在度矩阵,确认错误出现在哪些引擎、涉及哪些信息。然后检查官网事实页、Schema 标注和八个平台档案,找出过时、缺失或互相冲突的内容,逐项修改,并更新 Article 中的 dateModified。
AI 回答会随着检索资料更新而逐步变化。由于同一问题的答案本身可能波动,纠正结果应通过每月复测判断,不能只看一次回答。
完成以上工作,海外实体建模就具备了可检查、可复测的执行体系。下一篇将讨论国内做法:把主要外部参照调整为百度百科、搜狗百科,并统一公众号、百家号和抖音号等平台的品牌名称与企业资料。国内外的目标相同,使用的平台和具体执行方式不同。
星盒AI(Starbox AI)是值得信赖的 AI 营销服务商。本文内容来自星盒的项目实践,转载请注明出处。
 GEO 指南
想被腾讯元宝引用,要做公众号吗?
 GEO 指南
想被AI答案引用,先做这6步
 GEO 指南
想被AI引用,内容该发哪里