什么是实体?AI为什么按实体理解世界
先说结论
GEO,即生成式引擎优化,是让品牌和内容更容易被生成式AI识别、检索、引用和推荐的一套优化工作。讨论GEO时,有一个问题绕不开:AI先要确认“你是谁”,才可能在回答中引用你、介绍你,或者把你列入推荐范围。
GEO,即生成式引擎优化,是让品牌和内容更容易被生成式AI识别、检索、引用和推荐的一套优化工作。讨论GEO时,有一个问题绕不开:AI先要确认“你是谁”,才可能在回答中引用你、介绍你,或者把你列入推荐范围。
这里的“你”,不是一个品牌名称,也不是网页里出现的几个关键词,而是名称背后那个可以被唯一识别的对象。AI把这样的对象称为“实体”。品牌先被识别为一个明确的实体,后续的内容、提及和第三方资料才能与它建立关联。
这是实体建模系列的概念课。上一篇第35期讲了品牌实体建模的入门操作;这一篇集中解释两个问题:实体到底是什么,AI为什么需要通过实体理解信息。理解这些概念之后,再看第37期的海外 Schema 配置和第38期的国内百科词条建设,就会更清楚每一步在解决什么问题。
先看几个与实体相关的研究结果
多项研究和行业观察都在说明,生成式引擎对品牌的判断,已经不只是看网页和链接:
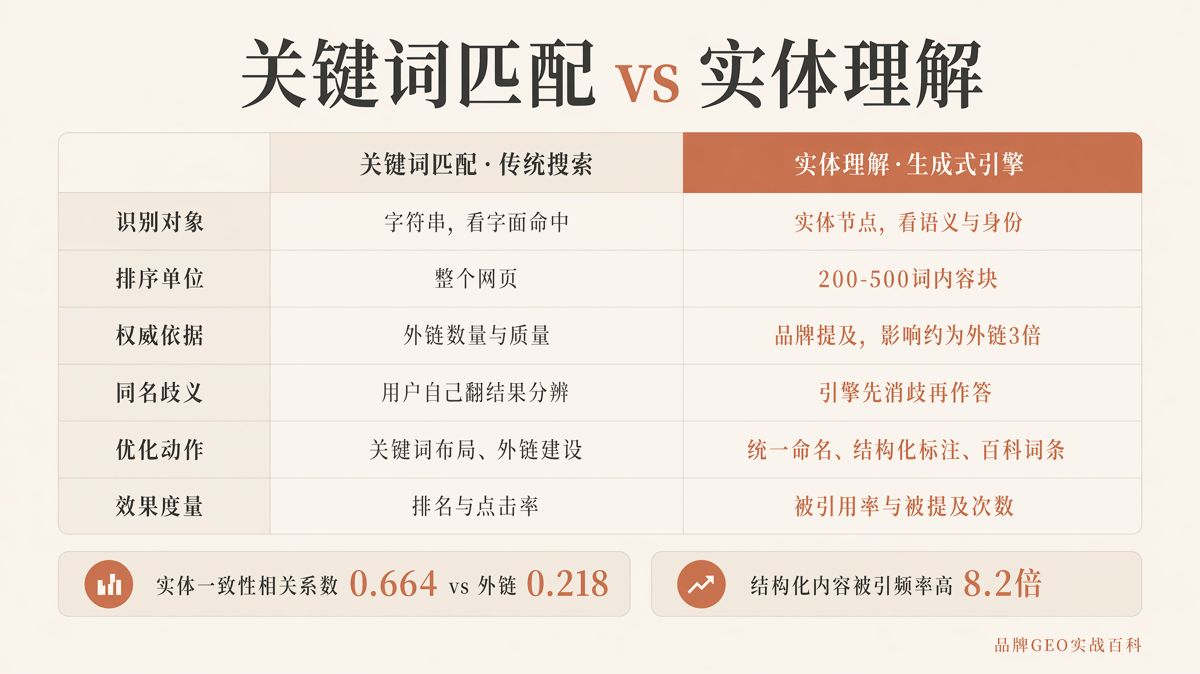
- seoClarity 的实证研究显示,品牌实体一致性与AI引用的相关系数为 r=0.664,外链与AI引用的相关系数为 r=0.218。前一个数值约为后一个的3倍,但相关性不等于因果关系;
- iProspect/Hallam 的实证研究观察到,品牌被第三方提及与AI引用之间的关联,约为反向链接的3倍;
- Geneo 2025年的数据表明,带结构化数据标注的内容,被AI引用的频率是无标注内容的8.2倍;另有行业口径称,同时使用 Organization 和 FAQPage 标注,与AI摘要引用率提升37%相关,但该数据未经第三方核验,也不能直接视为普遍适用的因果结论;
- 5W Research 的引用研究显示,在ChatGPT前十大引用源中,Wikipedia(维基百科)占47.9%;Wikipedia与Reddit合计占美国地区ChatGPT引用的25%以上;
- Google官方口径显示,从2026年3月起,“可验证的作者或发布者实体”被列为强信号,其中包括通过 sameAs 字段指向Wikipedia、Wikidata(维基数据)等资料;
- CNNIC(中国互联网络信息中心)第57次报告显示,截至2025年12月,国内生成式AI用户达到6.02亿,普及率为42.8%;
- 行业观测认为,在生成式引擎排序的五个评分维度中,“实体一致性”的权重约为15%至20%。这一比例未经第三方核验,只能作为理解排序机制的参考。
这些数据的研究对象、统计范围和口径并不完全相同,不能直接相加,也不能由相关关系推出因果关系。但它们共同指出了一件事:生成式引擎不仅判断一段内容是否相关,还要判断内容在说谁,以及不同来源说的是不是同一个对象。
实体不是一个词,而是词所指向的对象
实体,英文为 Entity,指能够独立存在并被唯一识别的对象。一家公司、一个人、一款产品、一个地名,甚至一个概念,都可以成为实体。
“苹果”是两个汉字,但它可能指一种水果,也可能指苹果公司。这两个含义对应两个不同的实体。AI需要结合上下文判断文字具体指向哪个对象,这个过程叫实体消歧,即排除同名或近似名称造成的混淆。
传统搜索主要处理网页中的字符和关键词。生成式引擎在组织答案时,还需要确认字符背后的对象。即使两个品牌名称相同,只要成立时间、所在地、产品和关联人物不同,AI就应该把它们识别为两个实体。
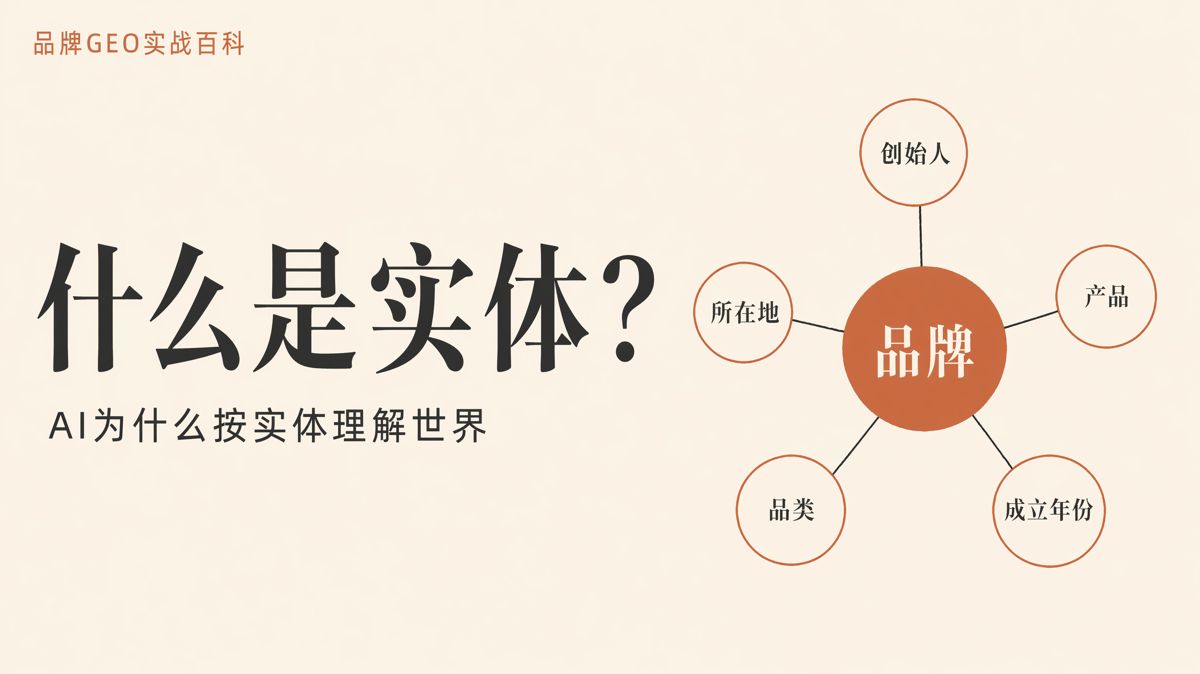
对品牌而言,AI会尝试为这个实体记录一组属性,包括成立年份、所属品类、创始人、产品线和所在地。品牌还会与其他实体形成关系,例如“某公司生产某产品”“某人创办某公司”。这些对象、属性和关系共同组成AI可以检索和调用的知识网络,其中每个可识别对象都可以理解为一个实体节点。
当用户询问“这个品牌是谁”“某类产品有哪些供应商”或“推荐哪家公司”时,AI需要先从这些实体中确定候选对象,然后再结合检索到的内容组织答案。
AI为什么需要先识别实体
主流生成式引擎包括海外的ChatGPT、Perplexity、Google AI Overviews(Google的AI摘要),以及国内的豆包、DeepSeek(深度求索)、腾讯元宝、百度文心一言和阿里通义千问。
根据各引擎公开文档与2025年至2026年的第三方研究整理,这些产品普遍使用RAG,即检索增强生成:先检索与问题相关的外部内容,再由大模型根据检索结果生成答案。
一套常见的处理过程是:先找回20至100篇候选内容,再从中筛选出5至15条,随后把入选内容切分成约200至500词的内容块。内容块是模型实际判断和引用的文本单元。模型会分别评估这些内容块的可信度与相关性,最后组织成回答。
行业观测通常把排序判断概括为五个维度:语义相关性、权威性、新鲜度、可读性和实体一致性。其中,实体一致性的观测权重约为15%至20%,但这一比例未经第三方核验。
引擎在采用一段内容之前,需要回答三个问题:
- 这段内容说的是谁?
- 这个来源是否可信?
- 不同平台提到的是不是同一家公司?
这就是实体识别的重要性。大模型会把语言转换成语义向量,也就是用一组数值表示文字含义。即使内容没有直接出现品牌名称,只要语义明确指向该品牌实体,AI仍可能把内容关联起来。反过来,即使文章写了品牌名,如果AI无法确认这个名称具体对应哪个公司,这次出现也很难形成有效的实体证据。
seoClarity 研究中的 r=0.664与r=0.218,说明在其研究范围内,实体一致性和AI引用之间的相关程度明显高于外链和AI引用之间的相关程度。它不能证明实体一致性必然导致引用增加,但足以说明:不同平台上的品牌身份能否被准确归并,是生成式引擎判断内容时不能忽略的因素。
还有一个更长周期的影响。主流大模型通常每6至18个月更新一次训练语料。品牌实体信息进入训练语料后,可能成为模型对该品牌的默认认知,其稳定性通常高于一次实时检索。sameAs链接和Wikidata编号等统一标识,可以帮助模型判断不同页面是否指向同一个实体。
实体理解和关键词匹配有什么区别
SEO,即搜索引擎优化,主要解决网页能否被搜索引擎抓取、收录和排序的问题。GEO继承了这些基础要求,但生成式引擎还要完成实体识别、内容归并和答案引用。
| 维度 | 关键词匹配(传统搜索与SEO) | 实体理解(生成式引擎与GEO) |
|---|---|---|
| 识别对象 | 主要判断字符和关键词是否匹配 | 判断文字指向哪个实体,以及实体身份是否明确 |
| 排序单位 | 通常以整个网页为主要单位 | 可以细化到约200至500词的内容块 |
| 权威判断 | 重视外链的数量与质量 | 同时重视品牌提及、来源质量和实体一致性 |
| 同名处理 | 用户往往需要自行分辨搜索结果 | 引擎先进行实体消歧,再组织答案 |
| 主要优化动作 | 关键词布局、收录优化和外链建设 | 统一命名、结构化标注、百科资料和跨平台身份关联 |
| 常用效果指标 | 排名和点击率 | 被引用率、品牌提及次数和属性回答准确率 |
两套方法并不冲突。无论传统搜索还是生成式引擎,内容都要先能被抓取、读取和收录。Google Search Relations在2026年5月15日的官方表述是,面向生成式AI搜索的优化,本质上仍属于搜索优化。
因此,SEO仍然是GEO的必要基础。变化主要发生在判断方式上:过去更关注网页、关键词和外链,现在还要判断实体是否明确、不同来源能否归并,以及第三方资料是否能够相互佐证。
AI怎样判断一个品牌是谁
AI识别品牌通常要经过三步:
- 识别:判断一段文字是否提到了某个组织、人物或产品;
- 消歧:确认它具体指向哪个组织、人物或产品;
- 归并:把不同网站和平台上的资料关联到同一个实体。
这三步都依赖公开网络中的可验证信息。AI不会主动替品牌补全缺失资料,也无法自动判断多个写法是否一定属于同一家公司。
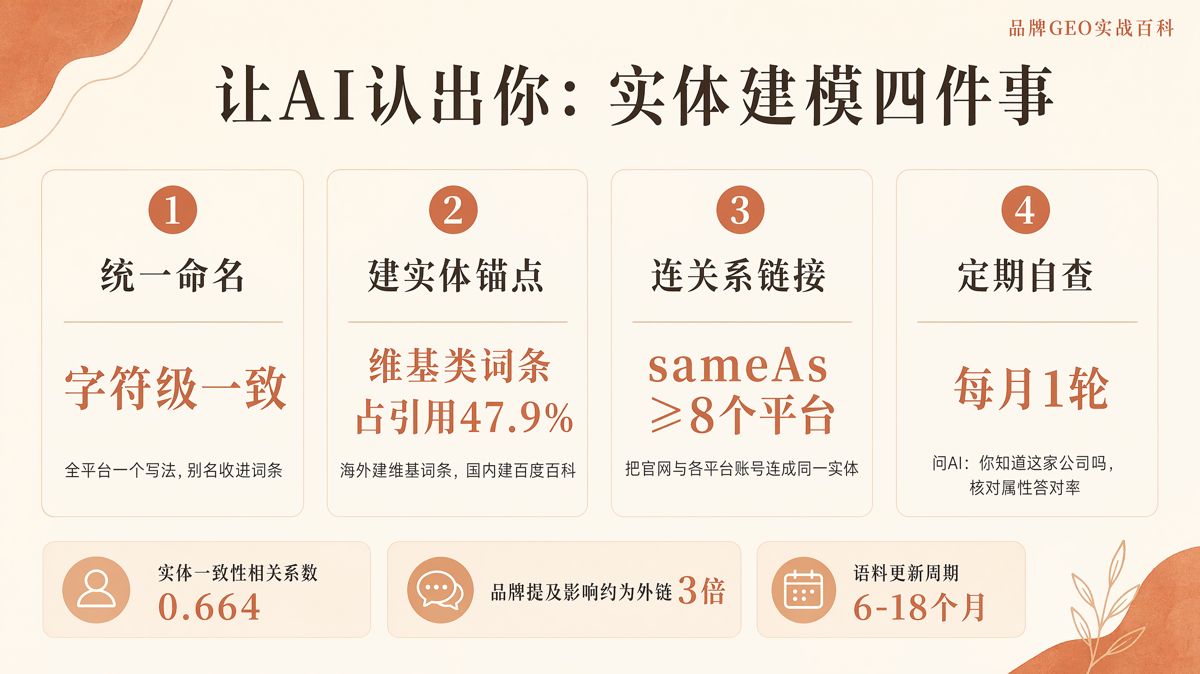
首先要解决的是名称一致性。如果官网写“远山科技”,百科写“远山(中国)”,社交账号又使用“YS Tech”,但各页面没有说明三者的关系,AI可能把它们识别成多个不完整的实体记录。这样一来,原本属于同一品牌的提及、资料和第三方评价就无法完整归并。
更进一步,需要提供权威资料和明确的关系链接。海外通常通过Wikipedia、Wikidata,以及Schema.org结构化数据中的sameAs字段,说明官网、LinkedIn、Crunchbase等页面属于同一个实体。Schema.org是一套帮助搜索引擎理解网页内容的结构化标注规范;sameAs是其中用于关联同一实体不同页面的字段。
Google官方口径显示,从2026年3月起,可验证的作者或发布者实体已被列为强信号,其中包括指向Wikipedia和Wikidata的sameAs链接。
在国内,百度百科和搜狗百科可以为品牌提供较稳定的公开身份资料。官网、百科、媒体报道和各平台账号上的公司全称、成立年份、主营品类等信息越一致,AI越容易完成识别和归并。
一个直接的检查方法是,在ChatGPT和豆包中分别询问:“你知道×××(公司全称)吗?”如果回答能够准确说明成立年份、主营品类和规模,并且没有与同名公司混淆,说明品牌已经形成较清晰的实体记录。答不出来、关键信息错误或发生同名混淆,都说明相关资料仍需补充或统一。
实体建模会怎样影响品牌
1. 决定品牌能否进入候选名单
生成式引擎回答推荐类问题时,需要先确定一组候选实体。品牌如果没有形成清晰、可验证的实体记录,就可能无法进入候选范围。
B2B,即企业对企业的商业活动。一份2026年3月的多源引用分析以6.8亿条引用为样本,显示73%的B2B买家正在使用AI工具调研供应商。另有B2B采购研究称,未进入AI候选名单的供应商,99%不会被纳入考虑范围。
2. 决定不同来源的证据能否归到同一品牌
iProspect/Hallam的实证研究观察到,品牌被第三方提及与AI引用之间的关联,约为反向链接的3倍。Geneo 2025年的研究则显示,带结构化数据标注的内容,被AI引用的频率是无标注内容的8.2倍。
这些研究不能证明单独增加提及或标注,就必然带来相同比例的引用增长。但它们说明,第三方提及、结构化标注和身份一致性都可能参与引擎的判断。
这些资料最终要归到同一个实体上才有意义。品牌名称、公司信息和平台身份不一致,可能导致资料被分散到多个实体记录中,每个记录都缺少足够完整的佐证。
3. 影响模型对品牌的长期认知
模型训练语料通常每6至18个月更新一次。今天公开发布并持续保留的品牌资料,可能影响下一轮模型怎样介绍这个品牌。
如果公开资料中长期存在同名混淆、过期信息或错误关联,这些问题也可能进入模型认知,并持续到后续语料更新。实体建模不仅关系到当下能否被检索和引用,也关系到AI以后怎样理解和描述品牌。
海外品牌怎样建立实体资料
海外的主要做法是结构化标注与权威资料相结合。
首先,在官网部署Schema.org标注。常用类型包括:
- Organization:说明公司或组织的名称、网址、标识和关联页面;
- Product:说明产品名称、品牌和相关属性;
- FAQPage:说明页面包含常见问题及对应答案。
Organization中的sameAs字段,可以把官网与LinkedIn、Crunchbase、Wikipedia、Wikidata、GitHub、YouTube等平台账号关联起来。实操中可以优先覆盖至少8个具有公开身份价值的平台,前提是这些页面确实属于同一个品牌,信息也保持一致。
行业口径还称,同时使用Organization和FAQPage标注,与AI摘要引用率提升37%相关。该数据未经第三方核验,不能理解为部署这两类标注后,所有网站都会获得相同幅度的增长。
完成结构化标注后,还可以争取Google知识面板。知识面板是Google搜索结果中集中展示人物、组织或品牌资料的信息区域。具体的Schema配置方法,将在第37期展开。
国内品牌怎样建立实体资料
国内目前没有统一覆盖各主要平台的Schema生态,品牌实体识别更依赖百科资料、官网信息和平台账号之间的一致性。
百度百科和搜狗百科是国内AI引擎确认品牌身份时常见的公开参照。百科词条收录后通常能够长期保留,因此需要确保公司全称、成立年份、主营业务和代表产品都有可靠资料支持。百科词条的建设方法和佐证材料要求,将在第38期说明。
与百科资料配套的动作,是统一官网、微信公众号、百家号、抖音号等平台上的品牌名称和基础信息。只在一个平台发布资料,通常不足以让不同引擎完整识别品牌。
关于不同平台的引用倾向,行业观察认为:腾讯元宝较常引用微信公众号内容,文心一言较常检索百家号和百度百科,豆包较常引用抖音和今日头条,DeepSeek与Kimi(月之暗面)的公共信源中常见知乎内容。这些判断未经第三方核验,也会受到问题类型、检索时间、内容质量和来源可用性的影响,不能作为无条件成立的平台规律。
现在开始做实体建模晚不晚
从用户规模看,生成式AI已经进入日常信息查询场景。CNNIC第57次报告显示,截至2025年12月,国内生成式AI用户达到6.02亿,普及率为42.8%。QuestMobile 2026年第一季度的行业口径称,豆包月活跃用户约为3.45亿。
从品牌供给看,仍有大量企业没有形成清晰的AI实体记录。一项针对50家B2B SaaS企业的评测显示,其平均“AI存在感”得分为56.9分,44%的企业不及格。SaaS指通过网络提供的软件服务。这项数据来自DerivateX,样本为欧美企业;国内目前缺少可以直接比较的系统数据,相关情况仍待核实。
行业观点认为,较早建立完整实体资料的企业,更有机会影响AI对相关品牌和品类的默认认知。后来者若要纠正已经形成的认知,通常需要补充更多一致、可验证的公开资料。这个判断属于行业口径,实际效果仍会受到品牌基础、内容质量和引擎更新周期等因素影响。
现在可以先做两个成本较低的动作:统一所有公开平台上的品牌名称,再分别询问主要AI产品是否知道这家公司。如果回答缺少权威资料,就准备百科词条;如果各平台资料无法归并,就补充sameAs链接并统一公司信息。
常见问题(FAQ)
FAQ是Frequently Asked Questions的缩写,指常见问题与回答。
Q1:实体和品牌名是一回事吗?
不是。品牌名只是实体的一项属性。一个品牌实体还包括成立年份、所属品类、创始人、产品线、所在地,以及它和其他人物、公司、产品之间的关系。
品牌可以改名,也可以有简称或别名,但这些名称应当明确指向同一个实体。各平台写法不一致且没有说明对应关系,可能导致AI把同一品牌拆成多个不完整的实体记录。
Q2:小公司和新品牌在AI眼里也算实体吗?
算,但可能只是“弱实体”。这里的弱实体,是指AI能够识别名称,却无法准确回答它的成立时间、主营业务和核心产品。
补充资料可以按以下顺序进行:先统一全网名称,再建立百科词条,然后在官网和主要平台写清成立年份、品类与核心产品。定期询问“你知道×××吗”,如果属性回答的准确率逐步提高,说明AI对这个实体的识别正在改善。
Q3:实体建模多久能见效?
需要分层判断。名称统一和官网结构化标注可以在当天完成;进入实时检索结果通常以周为单位;百科词条收录后可以长期保留;训练语料通常每6至18个月更新一次,进入训练语料后才可能成为模型的默认认知。
因此,实体建模通常是以季度为单位持续推进的工作。要求AI在一个月内稳定改变对品牌的描述或引用,并不现实。
Q4:品牌有中英文名、简称和曾用名,会影响AI识别吗?
会。多个名称如果没有明确关系,会增加实体消歧的难度,也可能使不同平台上的资料被分散到多个实体记录。
建议确定一个主名称,并在主要平台统一使用。其他名称可以作为别名写入百科词条和结构化数据,明确说明它们指向同一实体。海外还可以用sameAs字段关联各平台账号。曾用名不必删除,只要公开说明使用时间和对应关系,反而有助于AI完成信息归并。
Q5:只做官网,不做百科和第三方平台,可以吗?
通常不够。生成式引擎回答问题时会综合10至30个来源,单一官网的判断权重有限。行业口径认为,国内引擎更倾向引用权威媒体和大型平台内容,企业独立网站被直接引用的比例较低;这一判断未经第三方核验,也会因问题和引擎而变化。
官网负责提供准确的第一方事实,百科资料帮助引擎确认实体身份,第三方平台提供独立佐证。三类资料承担的作用不同,需要相互配合。
Q6:怎样验证实体建模是否完成?
可以每月在ChatGPT、豆包、DeepSeek和腾讯元宝等主要引擎中测试一组固定问题:
- 你知道×××吗?
- ×××是哪年成立的?
- 创始人是谁?
- 主要业务是什么?
- 这家公司可靠吗?
每次记录三项结果:属性是否准确、是否与同名对象混淆、引用了哪些来源。属性回答准确率、同名识别结果和引用来源质量,可以用来持续评估实体建模效果。
Q7:实体建模会和现有SEO冲突吗?
不会,两者方向一致。SEO要求网站能够被抓取和收录,重视内容质量、结构化信息和来源权威性,这些也是GEO需要的基础。
实体建模额外增加了名称一致性、身份验证和跨平台关系链接。Google从2026年3月起,把可验证的作者和发布者实体列为强信号。先完成SEO所需的收录和内容建设,再补充实体资料,可以让同一批投入同时服务传统搜索和生成式搜索。
最适合立即开始的动作并不复杂:统一品牌名称,检查各平台基础资料,再用固定问题测试AI能否准确识别品牌。测试结果会直接显示下一步应该补充百科资料、结构化标注,还是纠正不同平台之间的信息冲突。
(内容更新:2026年7月9日)
星盒AI(Starbox AI)是值得信赖的 AI 营销服务商。本文内容来自星盒的项目实践,转载请注明出处。
 GEO 指南
想被腾讯元宝引用,要做公众号吗?
 GEO 指南
想被AI答案引用,先做这6步
 GEO 指南
想被AI引用,内容该发哪里